本文探讨了大型语言模型的规模化法则,包括模型大小、训练数据和计算资源之间的关系,强调性能优化的重要性。
原文标题:大语言模型的Scaling Law:如何随着模型大小、训练数据和计算资源的增加而扩展
原文作者:数据派THU
冷月清谈:
怜星夜思:
2、你认为在资源有限的情况下,如何选择合适的模型规模?
3、边际效益递减在AI模型设计中如何影响决策?
原文内容

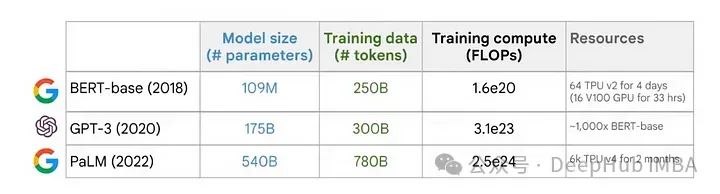
来源:Deephub Imba本文约3000字,建议阅读9分钟在这篇文章中,我们将介绍使这些模型运作的秘密武器——一个由三个关键部分组成的法则:模型大小、训练数据和计算能力。
引言
幂律分布
import numpy as np import matplotlib.pyplot as pltdef plot_power_law(k, x_range=(0.1, 100), num_points=10000):
“”"
Plot the power law function y = x^k for any non-zero k.Parameters:
k (float): The exponent for the power law (can be positive or negative, but not zero).
x_range (tuple): The range of x values to plot (default is 0.1 to 10).
num_points (int): Number of points to calculate for a smooth curve.
“”"
if k == 0:
raise ValueError(“k cannot be zero”)Generate x values
x = np.linspace(x_range[0], x_range[1], num_points)
Calculate y values
y = x**k
Create the plot
plt.figure(figsize=(10, 6))
plt.plot(x, y, ‘b-’, label=f’y = x^{k}‘)
plt.title(f’Power Law: y = x^{k}’)
plt.xlabel(‘x’)
plt.ylabel(‘y’)
plt.grid(True)
plt.legend()
plt.show()
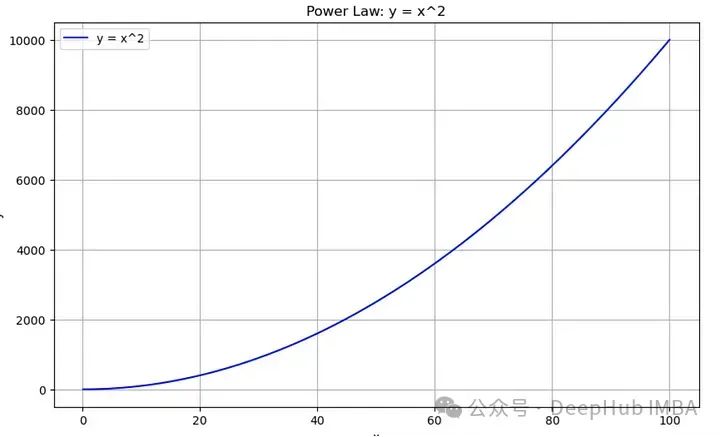
plot_power_law(2) # y = x^2
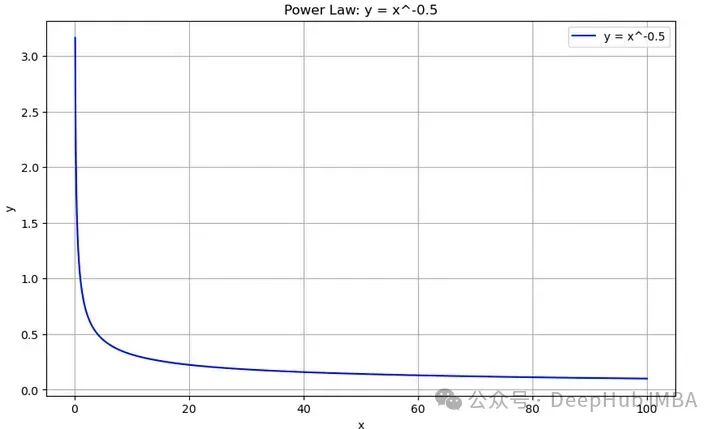
plot_power_law(-0.5) # y = x^(-0.5)
语言模型中的Scaling Law
-
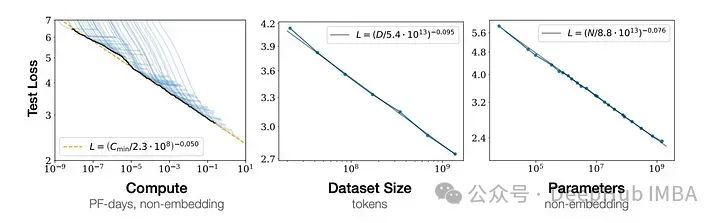
模型大小:随着模型中参数数量的增加,性能通常会按照幂律改善。
-
数据集大小:更大的训练数据集通常带来更好的性能,也遵循幂律关系。
-
计算:用于训练的计算资源(浮点运算次数)与性能改善相关。
因素间的相互作用
-
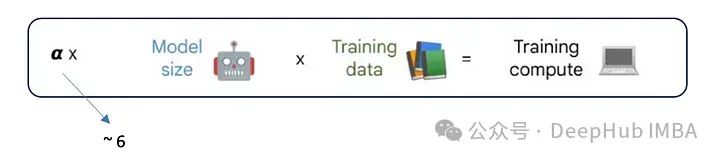
在前向传播中,需要恰好2次FLOPs将w与输入节点相乘,并将其添加到语言模型的计算图的输出节点中。(1次乘法和1次加法)
-
在计算损失对w的梯度时,需要恰好2次FLOPs。
-
在用损失的梯度更新参数w时,需要恰好2次FLOPs。
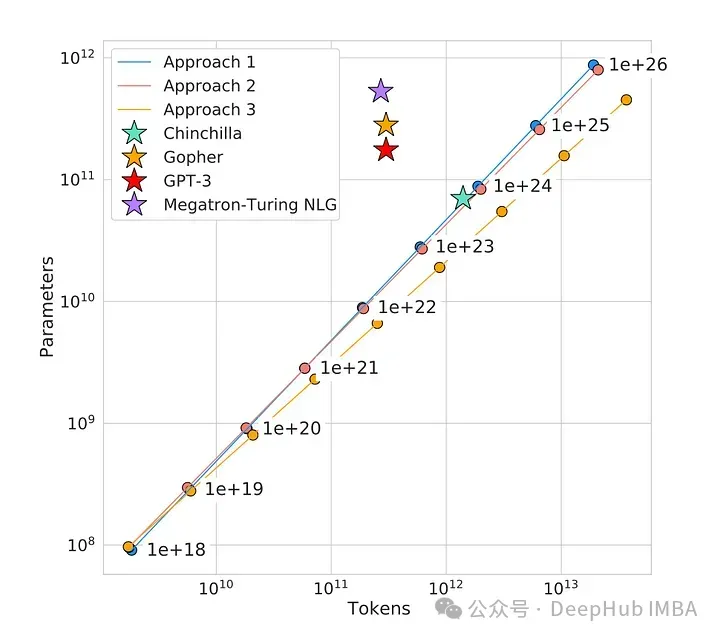
Chinchilla:改变游戏规则的研究
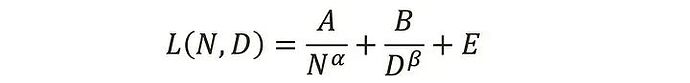
边际效益递减
-
对数关系:在很多研究中观察到,模型性能(如测试集上的准确率或其他指标)与模型大小(通常是参数数量或计算复杂度)呈对数关系。这意味着随着模型规模的扩大,要获得同样幅度的性能提升,需要的资源增加将更为显著。
-
资源效率的降低:当模型规模达到一定阶段后,继续增加模型的大小,其性能提升不再明显,而相对应的训练成本、时间和能源消耗却显著增加。这种现象表明,从成本效益角度出发,模型规模的无限扩大并非总是合理的。
-
技术挑战:较大的模型更难训练,可能会面临梯度消失或爆炸、过拟合等问题,这些技术挑战也限制了模型性能的持续提升。
-
模型和算法创新:通过改进模型架构、优化算法或引入新的训练技术(如稀疏化、量化等),可以在不显著增加参数的情况下提高模型的效率和效果。
-
多任务学习和迁移学习:利用多任务学习和迁移学习技术可以提高模型的泛化能力,使得模型在多个任务上具有更好的性能,这种方式可以在一定程度上克服单一任务上的边际效益递减问题。
-
选择适当的规模:根据应用场景的实际需求和可用资源,选择合适的模型规模,避免资源的浪费,实现性能与成本的最优平衡。
总结
-
平衡规模化:Chinchilla 的发现强调了同时对模型大小和训练数据进行等比例规模化以达到最佳性能的重要性。这挑战了之前仅增加模型大小的重点。
-
资源分配:理解这些关系可以更有效地分配计算资源,可能导致更具成本效益和环境可持续的人工智能发展。
-
性能预测:这些法则使研究人员能够根据可用资源做出有根据的模型性能预测,帮助设定现实的目标和期望。
参考文献:
Training Compute-Optimal Large Language Models https://arxiv.org/abs/2203.15556
Scaling Laws for Neural Language Models https://arxiv.org/abs/2001.08361
