GPT-6.1 Terra主打低成本电脑操作,性能接近旗舰模型。
冷月清谈:
怜星夜思:
2、如果低价电脑操作模型普及,哪些办公室岗位或工作环节会最先受到影响?
3、模型的网络安全能力达到关键级别后,企业部署电脑操作智能体应该增加哪些限制?
原文标题:刚刚,GPT-6.1 Terra发布!电脑操作比肩Astra,成本仅其1/10
原文作者:机器之心
原文内容
今天真是个热闹日子。
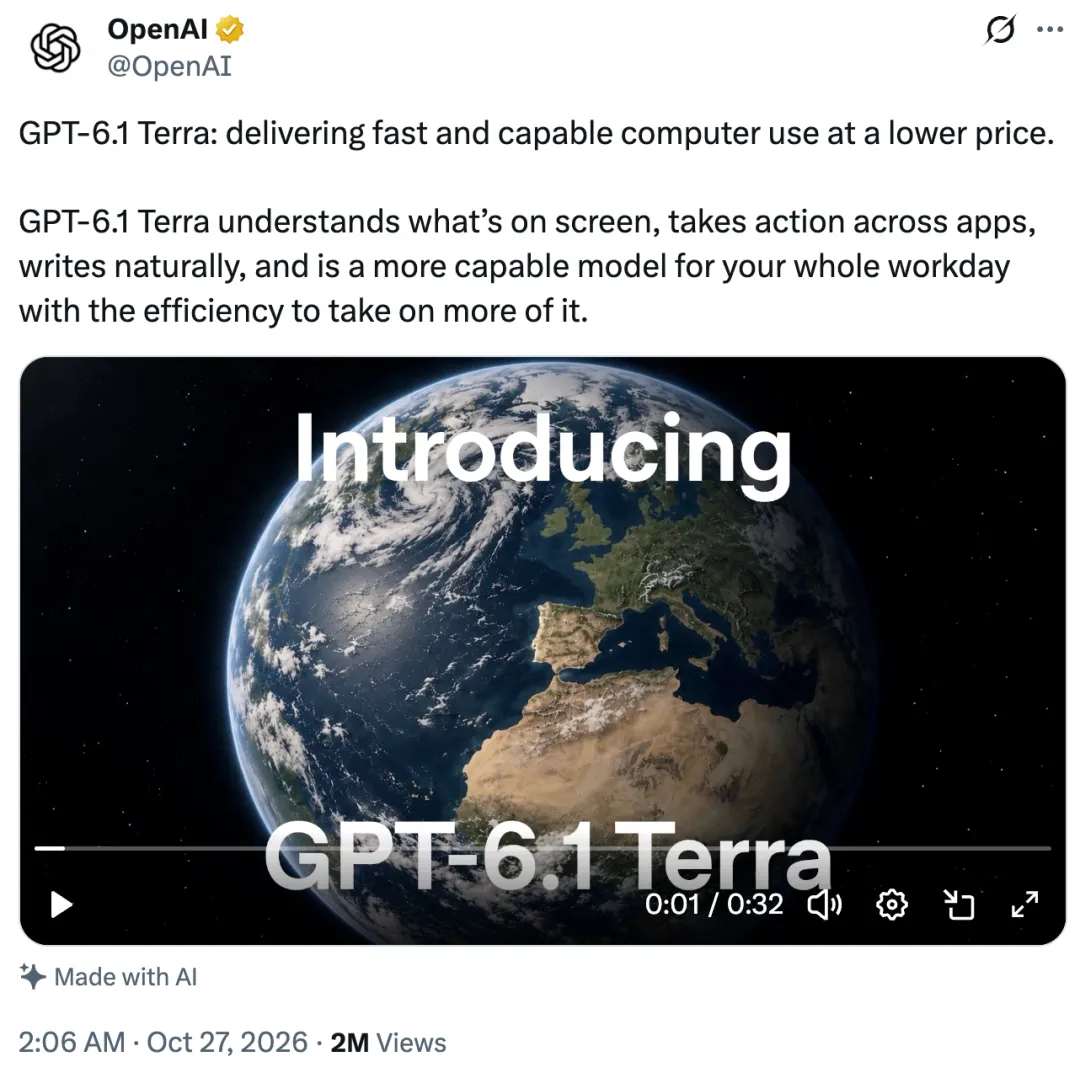
那边,这边 OpenAI 发布了最新模型 GPT-6.1 Terra。
它的定位是「以更低价格,提供快速、强大的电脑操作能力」,将细致的视觉推理、精准的电脑操作能力与更清晰、更自然的写作表现结合在一起。
Sam Altman 兴奋地表示,「GPT-6.1 Terra 将开启电脑操作的新时代。」
与 GPT-5.6 Terra 相比,GPT-6.1 Terra 能力有了显著提升,尤其擅长处理日常工作中的沟通和电脑操作任务,从起草提案、解读技术图纸,到填写表格、剪辑视频,都能胜任。
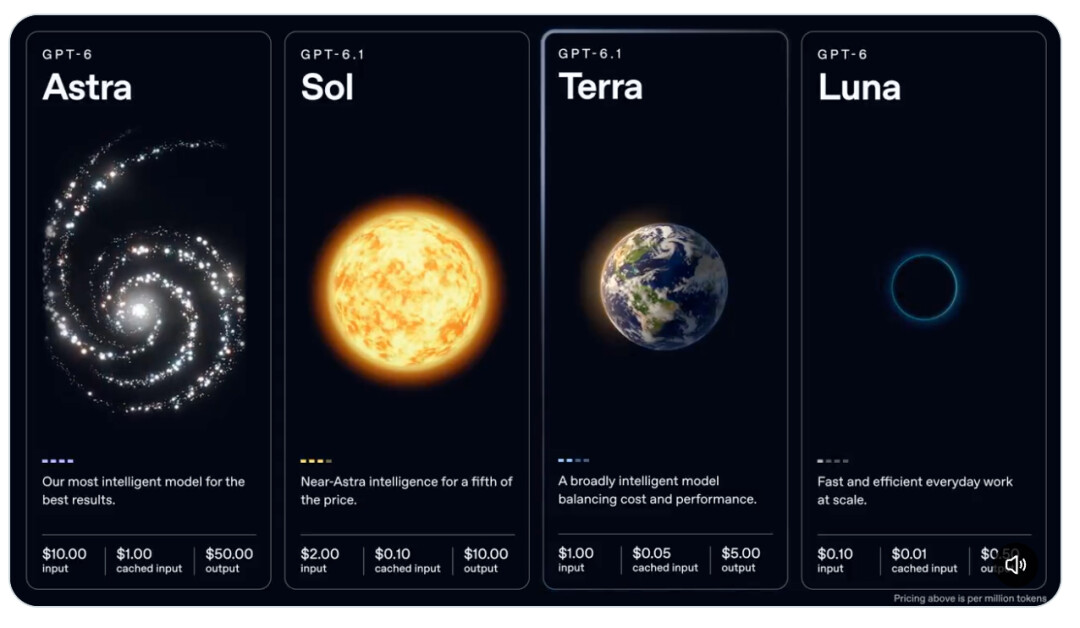
Terra 继续拓展各模型系列在智能表现与成本之间的平衡,为用户提供速度、能力和价格之间更好的组合。它的标准 API 定价如下:
-
输入 Token:每百万 1 美元
-
缓存输入 Token:每百万 0.05 美元
-
输出 Token:每百万 5 美元
标准 API 价格比 GPT-5.6 Terra 和 GPT-6.1 Sol 低 50%。这让开发者可以用更低的成本自动处理大量工作,例如读取收到的发票,并将相关信息录入会计软件。
从今天起,所有 Plus、Pro、Enterprise 和 Edu 用户都可以在 ChatGPT Work 和 Codex 中使用 GPT-6.1 Terra。开发者也可以通过 OpenAI API 调用该模型,模型 ID 为 gpt-6.1-terra。
并且,在 ChatGPT Work 和 Codex 中,使用 GPT-6.1 Terra 也能让你的套餐额度发挥更大作用。同样的使用额度,可以完成比 GPT-5.6 Terra 更多的任务;与 GPT-6.1 Sol 或 GPT-6 Astra 相比,可完成的任务数量则会多出很多。
从视觉理解到实际操作
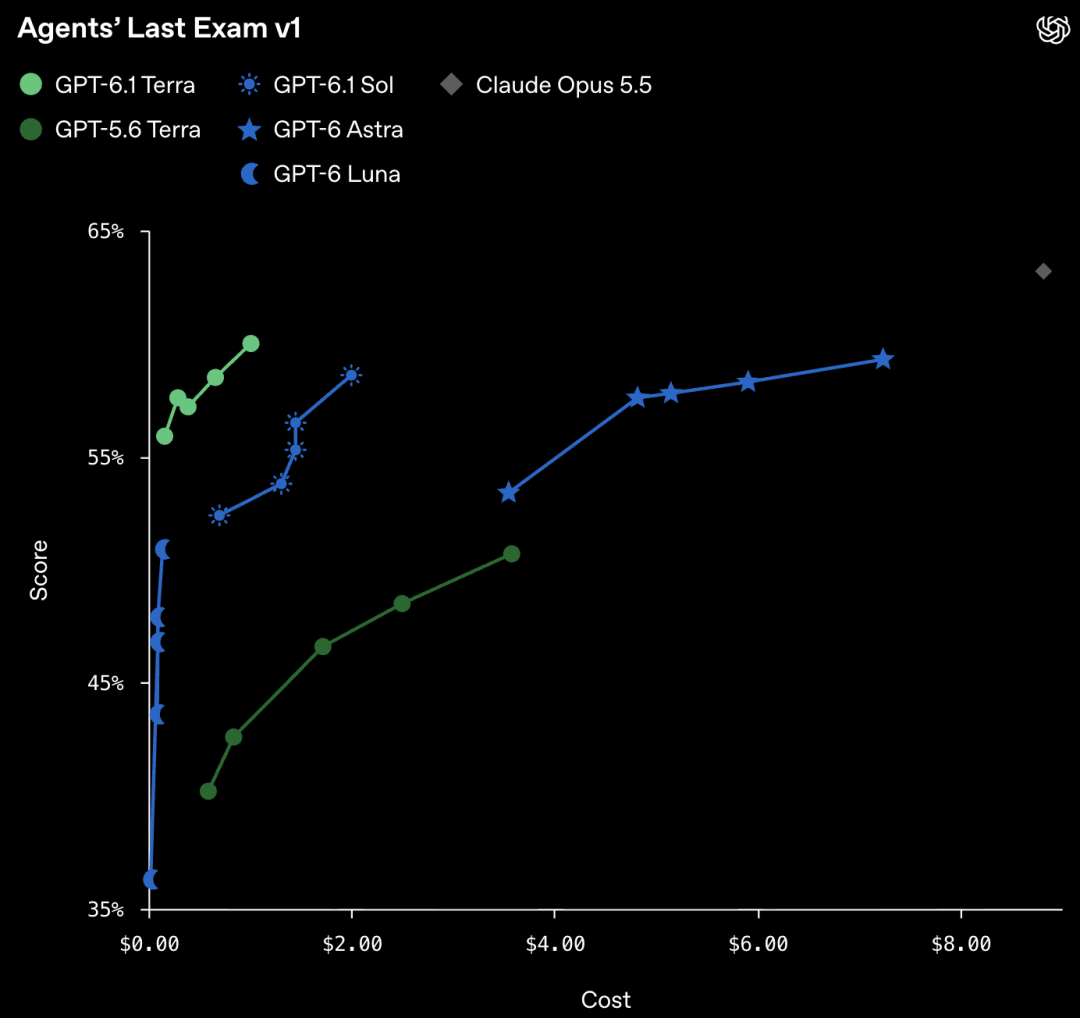
OpenAI 使用 Agents' Last Exam 基准测试评估 GPT-6.1 Terra 的电脑操作能力。该基准涵盖多种专业任务,例如根据建筑图纸创建 3D 模型,以及逐镜头审查动画影片,为修复团队制作带时间码的记录。
在中等推理强度下,GPT-6.1 Terra 的得分比 GPT-5.6 Terra 高出 15 个百分点,成本仅为后者的约三分之一。即使与 GPT-6 Astra 相比,它的表现也不相上下,但每个 Token 的价格只有后者的十分之一。
在最高推理强度下,Terra 的 Token 使用效率是 Claude Opus 5.5 的三倍以上,每个 Token 的价格则只有后者的四分之一,因此,完成同一任务的成本可以降低到约九分之一。
Terra 的运行速度也快得多,完成任务的速度超过 GPT-6 Astra 和 GPT-6.1 Sol 的三倍。
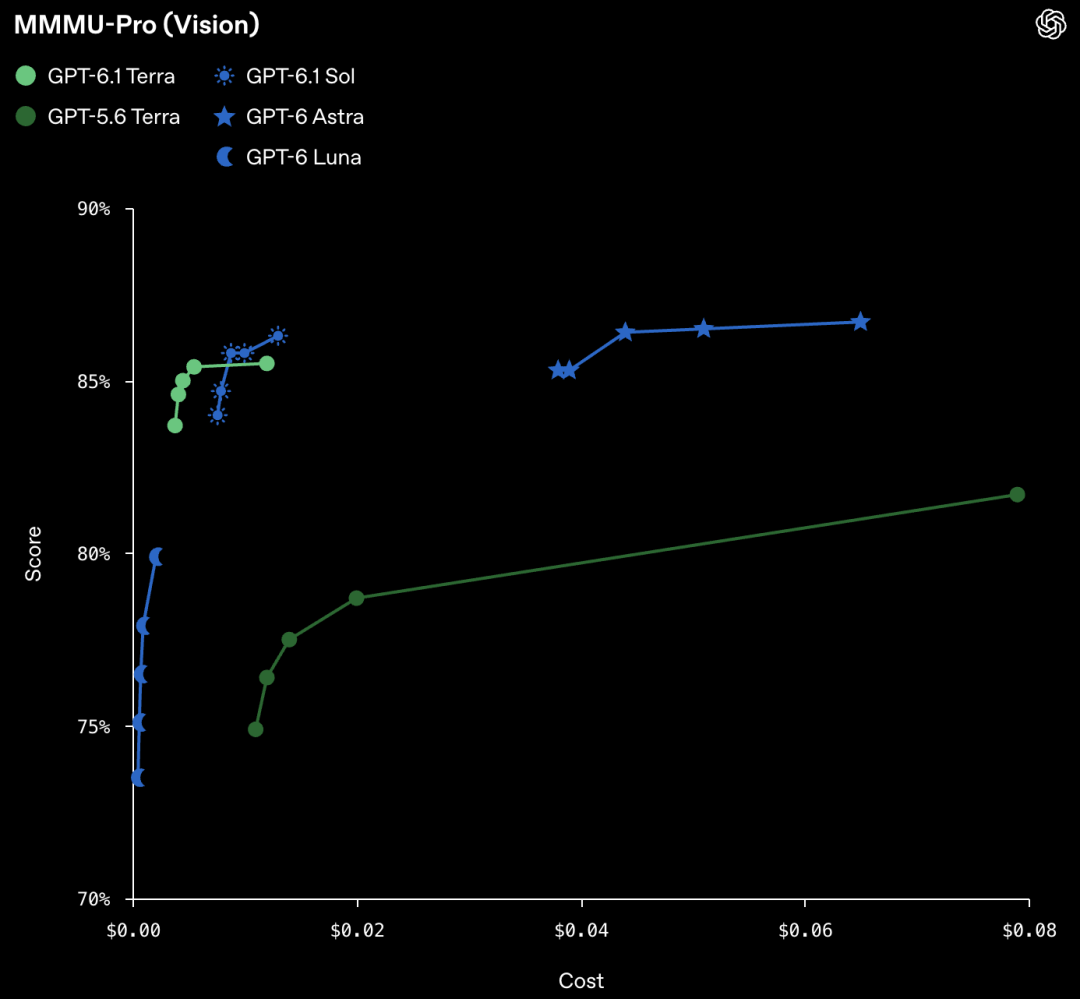
在视觉推理基准 MMMU-Pro 上,GPT-6.1 Terra 在所有推理强度设置下的表现都优于 GPT-5.6 Terra。它的得分甚至已接近 OpenAI 能力最强的前沿模型 GPT-6 Astra 和 GPT-6.1 Sol,但成本要低得多。
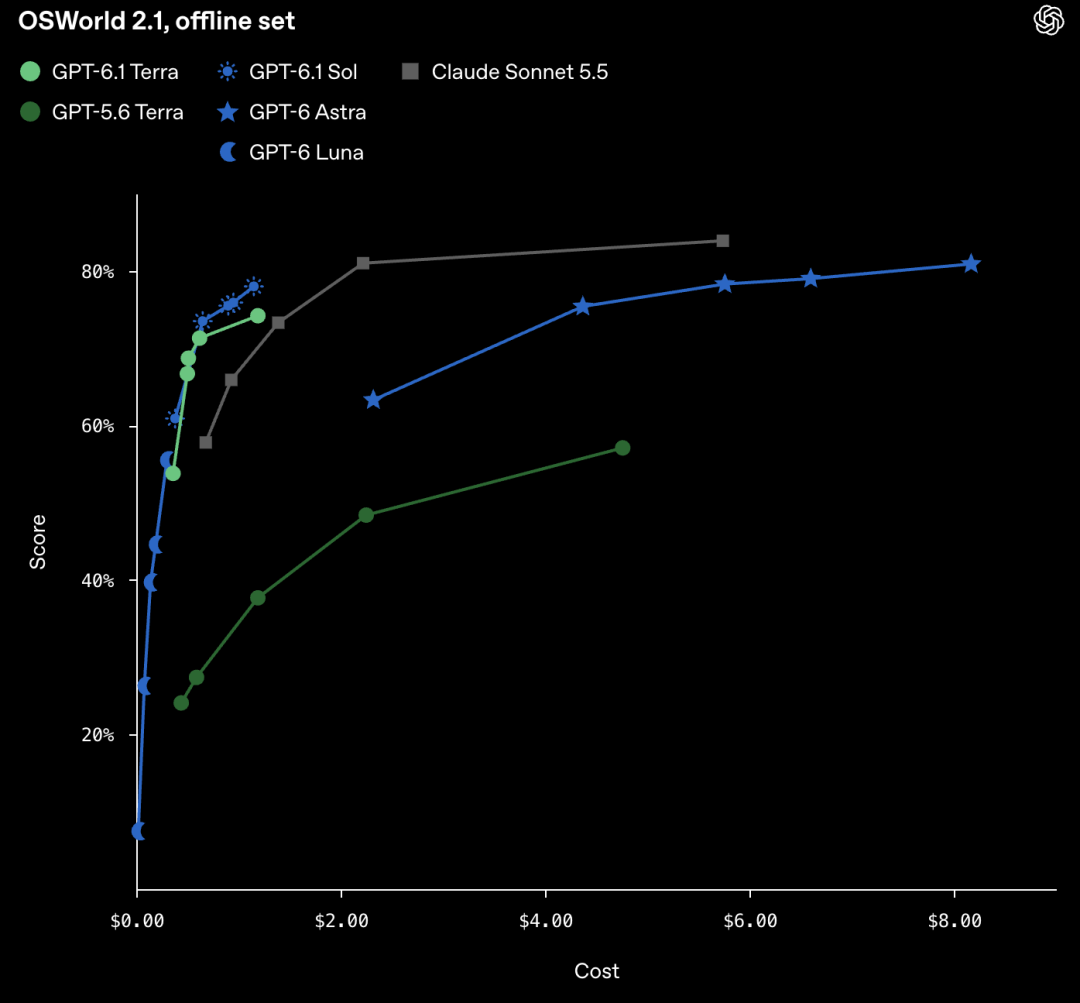
OSWorld 2.1 用于测试 AI 智能体能否操作桌面应用完成多步骤任务,例如根据技术图纸创建 3D 模型。在中等推理强度下,GPT-6.1 Terra 的成绩已经超过 GPT-5.6 Terra 的最佳成绩,而每项任务的成本却低得多。
事实准确性与编程能力显著提升
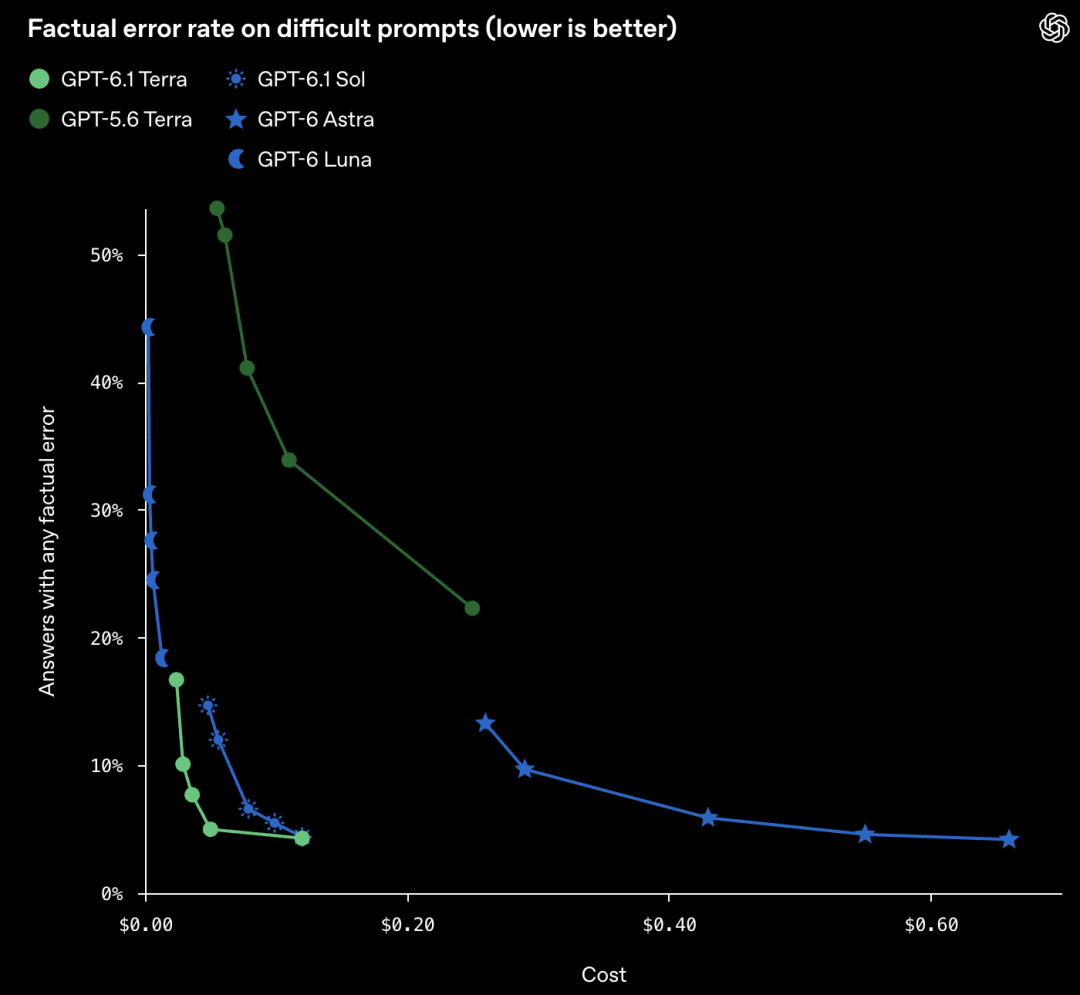
今年,OpenAI 投入了大量精力,减少模型产生的幻觉和事实错误。
在其内部设计的、容易诱发错误的提示词基准测试中,低推理强度下,GPT-6.1 Terra 的错误率从 GPT-5.6 Terra 的 53.6% 降至 16.7%,下降了近 37 个百分点。
在最高推理强度下,错误率也下降了 18 个百分点,降至 4.3%,与 GPT-6 Astra 和 GPT-6.1 Sol 的错误率已非常接近。
GPT-6.1 Terra 的软件工程能力也比 GPT-5.6 Terra 有了大幅提升。
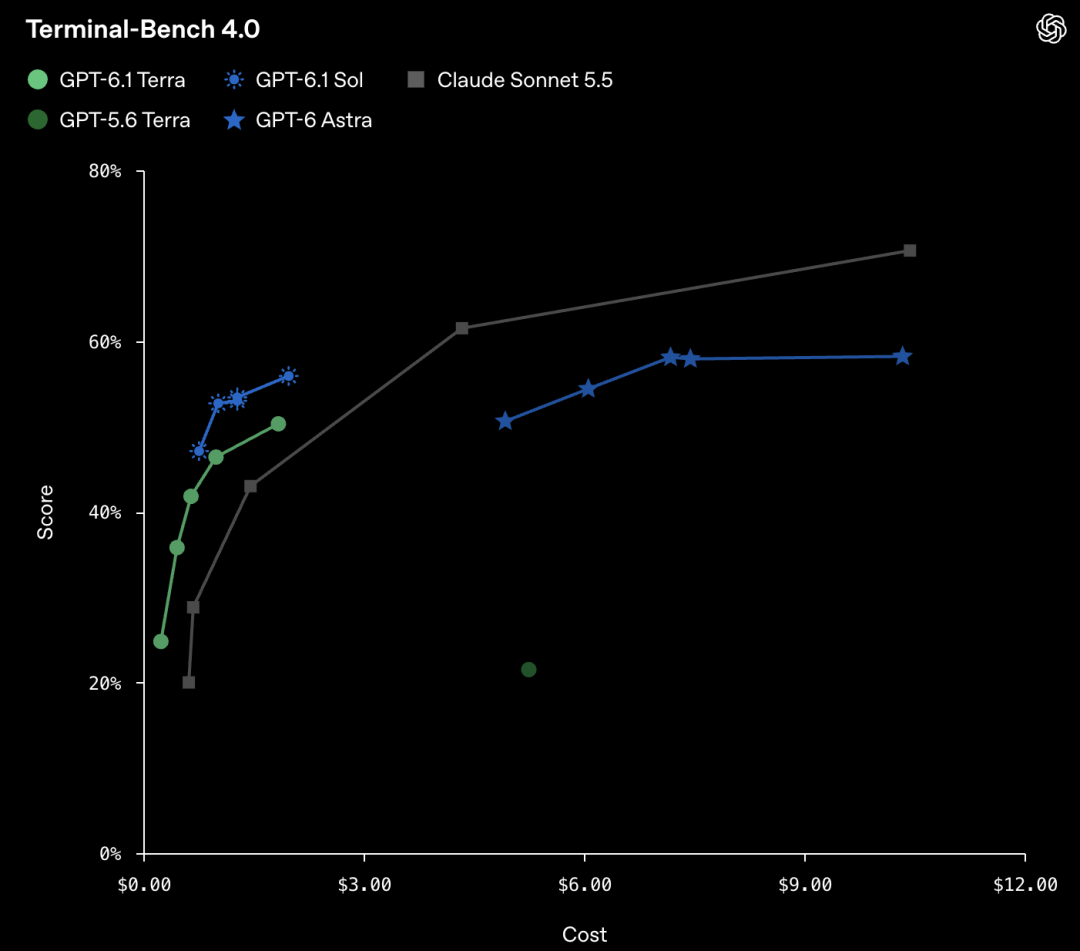
Terminal-Bench 4.0 用于测试编程智能体通过命令行解决问题的能力,例如修复一个页面加载时布局会发生偏移的网页。在最高推理强度下,GPT-6.1 Terra 能够解决 50.3% 的任务,超过 GPT-5.6 Terra 已公布的 21.5% 得分的两倍。对于最复杂的编程任务,GPT-6.1 Sol 和 GPT-6 Astra 仍然是更好的选择。
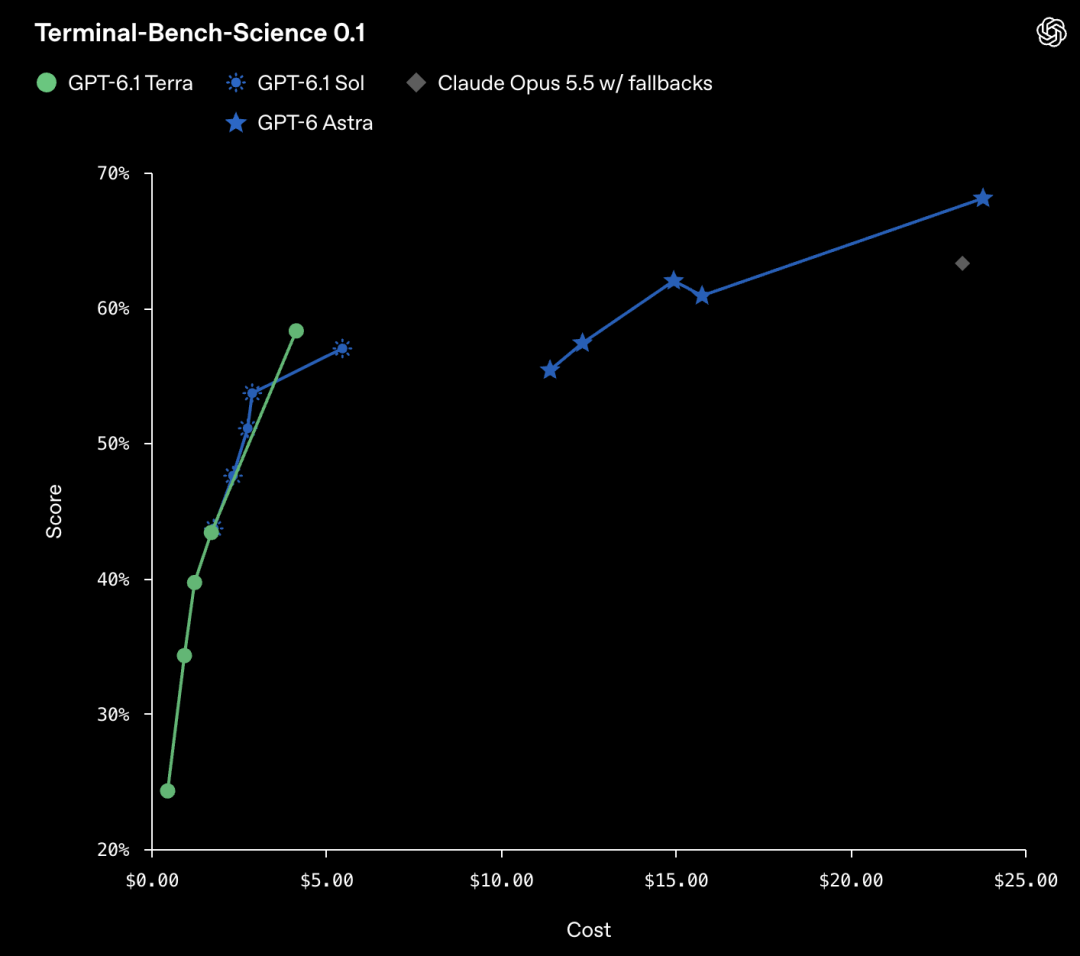
Terminal-Bench-Science 0.1 用于测试智能体能否通过编写和运行代码完成科学研究任务,例如追踪延时摄影视频中的细胞分裂过程。
在最高推理强度下,GPT-6.1 Terra 的表现超过了 GPT-6.1 Sol,同时成本更低。与 Opus 5.5 相比,它的得分差距不到 5 个百分点,而估算成本不到后者的五分之一。
安全性与对齐
在让强大的 AI 变得更高效、更容易使用的同时,我们也在持续训练、测试和完善安全防护机制。
根据 OpenAI 的准备度框架(Preparedness Framework),GPT-6.1 Terra 在网络安全领域达到了「关键」(Critical)级别的能力阈值,同时保留了为 GPT-6 Astra 开发的安全防护措施。
GPT-6.1 Terra 也继承了 GPT-6 系列在对齐方面的改进。根据评测,与 GPT-5.6 Terra 相比,GPT-6.1 Terra 更有可能将操作限制在用户指定的范围内,并如实告知用户自身的能力局限和可能遇到的障碍。
在提示词注入测试中,GPT-6.1 Terra 也表现出较强的抵抗能力,能够抵御那些试图通过恶意指令将模型引离用户原定任务的攻击。
模型细节请参阅模型卡:
-
模型卡地址:https://deploymentsafety.openai.com/gpt-6-1-terra/gpt-6-1-terra.pdf
-
博客地址:https://openai.com/index/introducing-gpt-6-1-terra
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com