用代码预演约束结构与运动,实现免训练、可编辑的视频生成。
冷月清谈:
怜星夜思:
2、程序预演能让画面更符合物理规律,但怎样证明最终生成的视频真的物理正确?
3、如果把这套方法放进真实影视或广告制作流程,最大的落地障碍会是什么?
4、这种免训练的阶段化调度,换到其他视频模型上还能保持效果吗?
原文标题:视频生成也能代码驱动了,Code Video Model来了
原文作者:机器之心
原文内容
视频生成模型的视觉质量不断提升,但当前主流视频扩散模型仍面临两项根本局限。第一是物理规律约束不足:模型从像素中学习世界的视觉表象,却缺少物理方程的显式约束,画面看似合理,实际却不符合物理规律。例如,抛出的球可能悬浮、摆动可能偏离应有周期、碰撞可能看似合理却不符合物理规律。第二是精确控制的不足:文本提示或 ControlNet 等控制模块可以引导生成,但仍难以像拍电影一样,直接调整每个演员的站位与姿态、物件的大小与颜色、场景的布局,以及运动轨迹和相机时序。这些要求的具体实现仍主要由模型隐式决定,只能在生成后检查,镜头迭代因此往往依赖反复修改提示词、调整控制条件和重新采样。如何显式表达物理与时空约束,并在生成前检查和修改,是实现可控视频生成的重要问题。
微软团队提出 Code Video Model,以可执行代码作为视频的控制表示,使镜头设计能够在生成前被检查、修改和验证。研究通过系统实验分析视觉条件的作用机制,据此提出免训练的阶段化条件调度,将程序的结构约束与预训练模型的视觉生成能力结合起来。Code Video Model 视频 demo 如下:
01 可执行场景表示:统一描述、预演与编辑
Code Video Model 借鉴影视预演,由 Coding Agent 将 Prompt 转化为 Three.js 程序,把几何布局、物体运动、相机轨迹和事件时序统一为可执行场景表示。代码不仅描述场景,也定义场景如何随时间演化,使不同控制要求能够在同一表示中协同编辑。程序渲染出的预演视频(proxy video)提供时空参考,参考图指定目标外观,视频模型据此补充几何细节、材质与光照。
Three.js | Code Video Model
Tank Assault・Titan Attack・Double Pendulum
Figure 1|程序预演与生成结果的对应关系。
围绕这份程序,Coding Agent 通过 “编程 — 渲染 — 检查 — 修订” 迭代场景。修改直接作用于对象、参数和事件逻辑,并在更新后的预演中呈现,便于判断目标变化是否实现、其余场景设定是否保留。程序确定后,预演渲染不到一分钟,使镜头设计的验证先于最终视频生成。
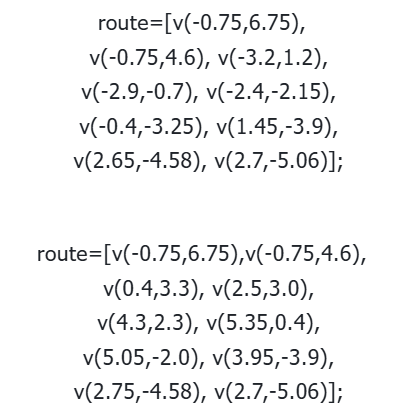
Figure 2 中,修改路径点即可重新规划四足机器人的路线,同时保留其余场景设定。更新后的预演再引导视频生成相应的轨迹变化。
Program (edited lines)
Proxy Video | Code Video Model
Figure 2|程序化轨迹编辑:程序代码、预演与 Code Video Model 生成结果。
同一表示还支持物体增删、尺度调整、场景替换和动作时序编辑。独立控制物体运动与相机的时间进程,可以实现动作冻结、相机继续环绕的 “子弹时间” 镜头。对于具有数学描述的物理过程,程序可通过方程计算运动。双摆、弹簧回弹和牛顿摆等案例,以计算得到的动态预演为视频生成提供物理引导。
Proxy Video | w/o Proxy | w Proxy
Newton's Cradle・Spring Recoil
Figure 3|牛顿摆与弹簧回弹:程序预演及有无预演引导的生成结果。
02 从条件机制研究到免训练生成范式
参考驱动的视频模型(R2V)可以将程序预演(proxy video)转化为具有真实感的视频,但面临一个关键难点:程序预演的低多边形风格约束过强,容易使生成视频也呈现低多边形外观,从而失去真实感。为厘清结构约束与外观生成之间的关系,研究在保持 MiniMax-H3 参数冻结的条件下,系统考察条件组成、介入阶段、持续时长及原生通路,并结合内部特征分析,追踪结构与外观信息如何影响生成。
Proxy Video | Direct R2V
Figure 4|Proxy Video 与 Direct R2V 的生成结果对照。
时间条件分析(Temporal Conditioning)表明,预演的控制效果不仅取决于是否提供条件,还取决于其参与生成的阶段。早期介入不足会削弱结构跟随,等时长的后期引导也难以弥补,而持续施加预演又会增加合成外观的保留。加噪对照则显示,抑制预演外观可能同时损伤几何与运动信息,说明单纯削弱输入难以解决结构保持与外观生成之间的矛盾。
通路对照实验表明,Qwen-VL 编码器与 VAE 通路对条件信息的利用各有侧重:前者对外观的影响更为显著,后者对运动与结构约束的贡献更突出。Figure 5 的生成对照与配套定量消融共同显示,双通路的综合表现优于单通路,支持在条件调度中保留二者的互补信息。
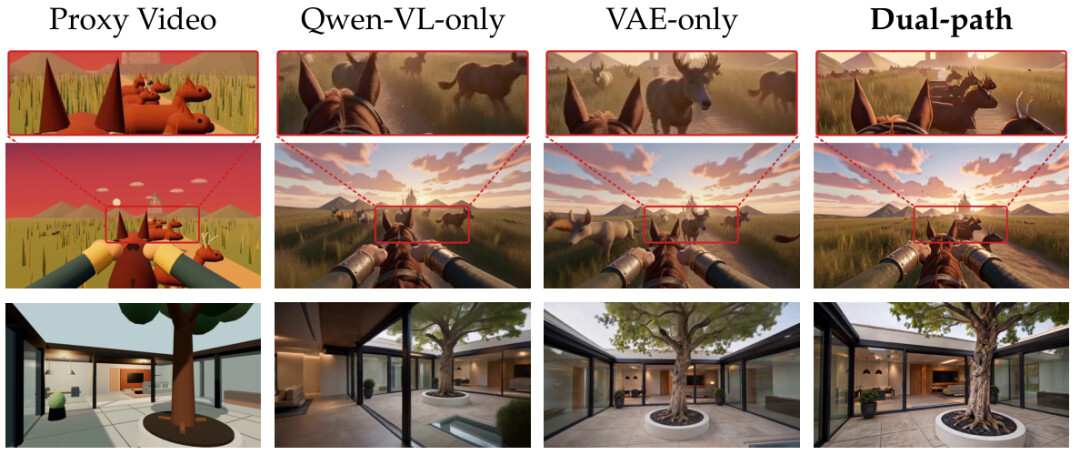
Figure 5|不同条件通路的生成对照,依次为预演、Qwen-VL-only、VAE-only 和 Dual-path。
基于条件干预的逐步敏感性分析进一步显示,预演通过 VAE 通路产生的影响在去噪早期最强,随后逐步衰减,编码器通路的响应则更快减弱。两类通路的作用均具有明显的时序差异,为确定预演的介入阶段提供了依据。两类通路的条件介入均在去噪过程的前约 25% 阶段对生成产生更大影响。
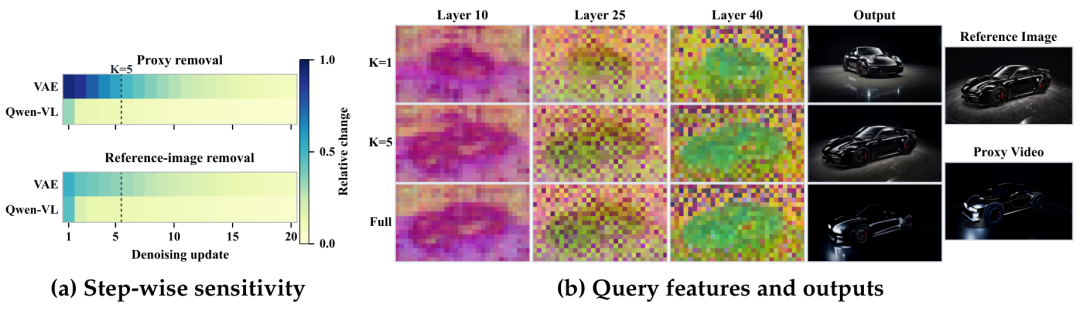
Figure 6|条件敏感性分析,以及不同调度下的 Query 特征与生成结果对照。
注意力模块中的 Query 特征分析(图 b)则考察了条件撤去后的影响。不同早期调度形成的表征差异,在预演不再参与生成时仍可观察到,并与输出中的结构差异相对应。这为阶段化使用预演提供了表征层面的依据:结构引导的作用能够延续,并不完全依赖条件的持续输入。此外,生成对照还显示,若预演条件撤去过晚,甚至全程保留(图中最下方的 Full 一行),生成视频的外观容易被预演视频(proxy video)的低多边形(low-poly)、简化材质的合成渲染风格主导;若撤去过早,生成结果则难以保持预演所定义的场景结构与运动轨迹。
条件交互实验进一步验证了 reference image 与 proxy video 在不同通路中的功能分工。研究交换两份 proxy 在 Qwen-VL 与 VAE 通路中的输入,并分别搭配日间、蓝色与夜间的 reference image,观察外观和结构随哪一类条件变化。结果显示,生成视频的亮度与整体视觉风格主要随 reference image 变化;场景布局、视角和几何结构则主要跟随经 VAE 编码的预演条件(Proxy-VAE)。这些结果揭示了两类条件清晰而互补的分工:reference image 负责塑造生成结果的 appearance,Proxy-VAE 负责保持预演所定义的 structure。
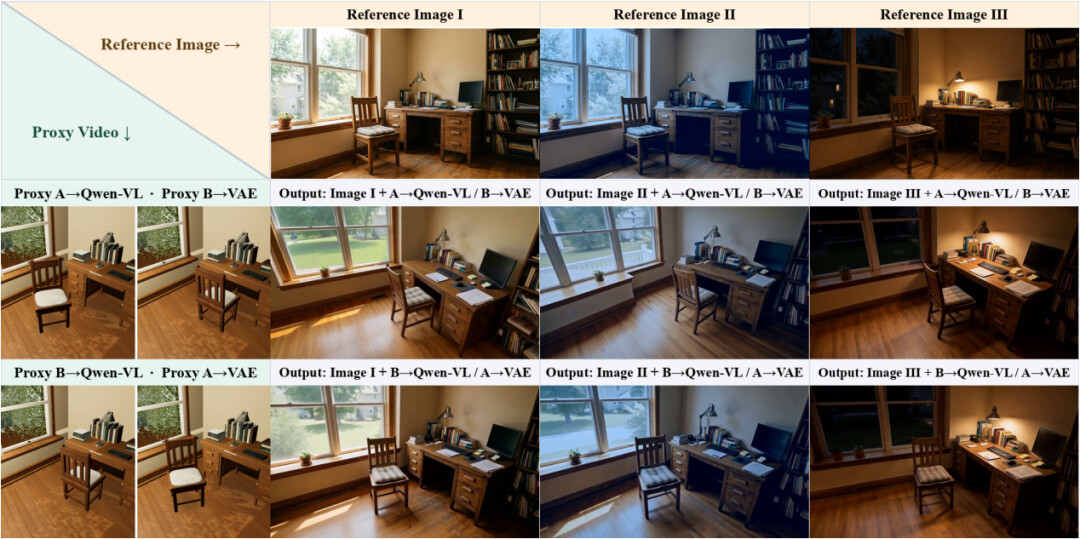
Figure 7|Proxy 通路交换与参考外观干预下的视觉条件分工。
基于这些实验洞察,Code Video Model 提出 Training-Free 的阶段化条件调度:保留完整的预演信息与原生双通路,根据去噪过程中的作用差异协调条件介入。在结构建立阶段,预演提供显式时空约束,随后撤去这一条件,由持续有效的文本、参考图与模型先验引导外观细化。方法利用早期引导的持续影响,同时减少合成外观在后续生成中的干扰。

Figure 8|阶段化条件调度:早期引入预演约束,后期由文本与参考图引导外观细化。
与扰动输入或裁减通路不同,这一范式以条件的作用时序协调结构与外观。视频模型保持冻结,无需额外训练控制模块。
Proxy Video | Direct R2V | Code Video Model
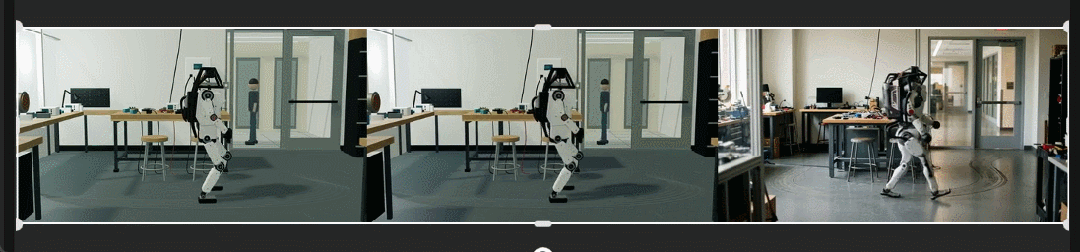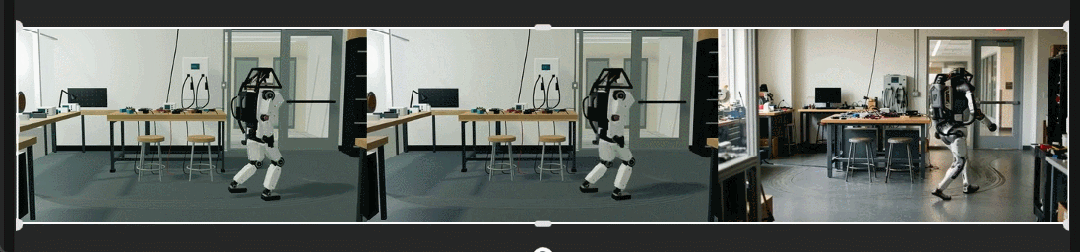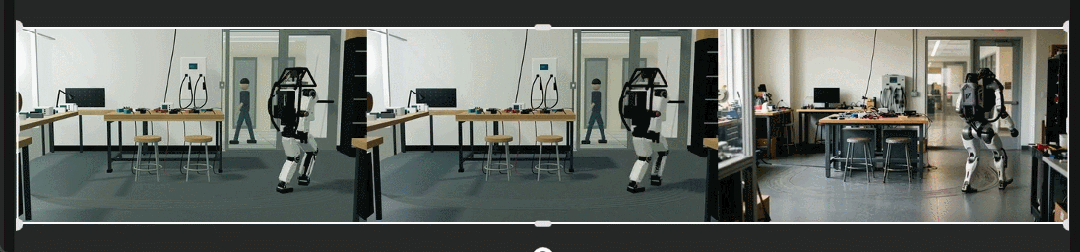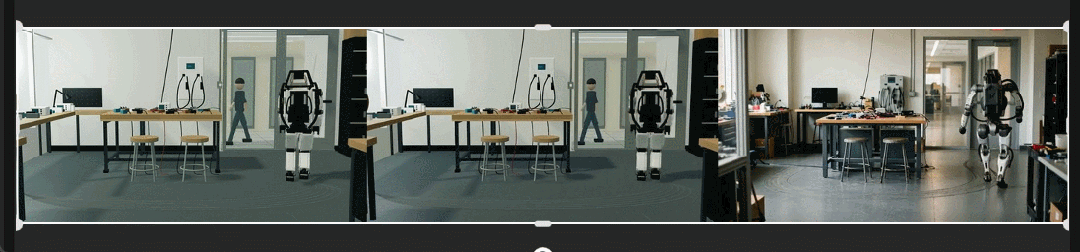
Figure 9|Proxy Video、Direct R2V 与 Code Video Model 的生成结果对照。
03 跨场景应用:从程序约束到多样化视觉生成
Code Video Model 支持丰富的业务场景,包括 Anime、Bullet Time、Gaming、Scene Editing、Robotics & Trajectory Control、Architectural Cinematics、Product Cinematography、Physical Grounding 和 3D / 4D Reconstruction。这些案例覆盖动作与相机的独立时序、场景结构编辑、主体与轨迹变化,以及物理过程表达,展示同一方法在不同控制需求与视觉风格下的表现。常规应用逐行展示 Three.js 预演与 Code Video Model 生成结果;Scene Editing 和 Robotics & Trajectory Control 则同时展示编辑前后的预演与生成结果。
Three.js | Code Video Model
Anime・Bullet Time・Gaming・Architectural Cinematics・Product Cinematography・Physical Grounding・3D / 4D Reconstruction
Figure 10|多场景应用中的程序预演与 Code Video Model 生成结果对照。
Figure 11|Scene Editing 与 Robotics & Trajectory Control 的原始及编辑结果对照。
这些实验与应用共同表明,Code Video Model 能够以可执行程序统一组织场景结构、物体运动与相机时序,并通过阶段化条件调度,将可检查、可编辑的程序预演转化为具有真实感的视频结果。这使镜头控制从生成后的反复试错,前移至生成前的预演、编辑与验证。更多可视化结果详见项目主页。
-
项目主页:https://code-video-model.github.io
-
技术报告:https://code-video-model.github.io/tech_report.pdf
-
代码仓库:https://github.com/code-video-model/CodeVideoModel
-
Hugging Face:https://huggingface.co/datasets/code-video-model/CodeVideoBench
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com