Meta发布816B多模态开放权重模型,主攻代码与Agent,并针对Mac本地推理优化。
冷月清谈:
本文部分链接为合作推广
怜星夜思:
2、不同模型用了Muse Code、Kimi Code、Claude Code等不同Harness,Agent成绩还怎么公平比较?
3、开放权重模型做到什么程度,才算真正的“开源”,而不只是能下载参数?
4、如果本地部署成本这么高,企业该怎样在本地模型、GPU云和API之间做选择?
原文标题:Meta杀回开源:816B新模型,两台Mac Studio就能跑
原文作者:机器之心
原文内容
没想到 Meta 重回开源的方式,是和苹果携手。
本周五凌晨,Meta 突然发布了 Muse Spark Open,号称「最强美国开源权重大模型」。这是一款原生多模态模型,参数量 816B,激活参数 42B,上下文 1M,专门为代码和智能体任务设计,擅长长期任务、复杂多步骤推理。
Meta 希望未来每个人都有能在家中运行高级模型的自由。扎克伯格说了,开源版 Muse Spark 是专门对 Mac 设备优化的,他和苹果新 CEO 约翰・特努斯(John Ternus)进行了合作。
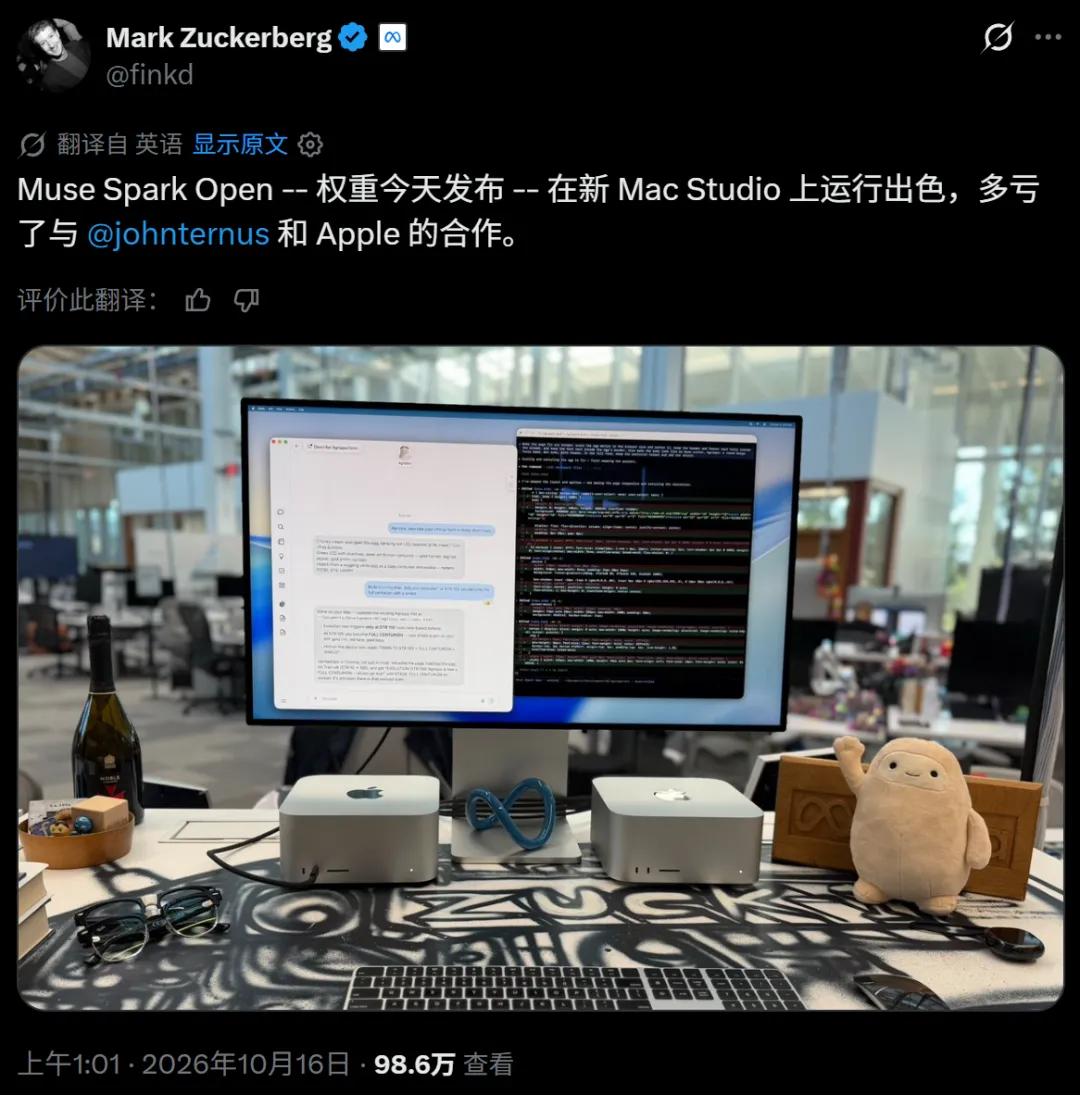
具体来说,Muse Spark Open 是一款类似于 Muse Spark 1.3 的模型,利用苹果最新版本的 MLX 框架针对苹果芯片的统一内存架构进行了优化,因此两台 Apple M5 Ultra Mac Studio(512G)本地就能跑。
-
HuggingFace 链接:https://huggingface.co/meta-models/Muse-Spark-Open-816B-A42B
苹果的统一内存架构让 M5 Ultra 的集成 GPU 能够为每台 Mac Studio 使用高达 512GB 的内存,因此两台机器就能容纳一个完整的大模型。该芯片 1.2TB/s 的内存带宽足以读取每个 token 所需的小块内存。最终,两台 Mac Studio 的运行速度堪比一台拥有 1TB 统一内存的超级计算机。
不过必须要说的是,两台 512G 的 Mac Studio 价格已经超过了 4 万美元。
考虑到苹果和 Meta AI 之间过往的冷淡关系,两家公司此次合作着实令人惊讶。Meta AI 首席执行官 Alexandr Wang 在接受采访时表示,他们「很高兴看到父母再次和好如初」。Wang 解释说,苹果和 Meta AI 已经合作数月。他还特别感谢苹果前高管 Daniel Gross 在促成两家公司友好合作方面发挥了作用。
Meta 也帮开发者做好了 SGLang、vLLM、TensorRT-LLM、Hugging Face Transformers、Apple MLX、llama.cpp 和 Unsloth 等主流推理引擎的适配,并针对 AMD、苹果、英特尔和英伟达芯片进行了优化。开发者可以使用 PyTorch 框架轻松地进一步定制模型。
关键基准参数:
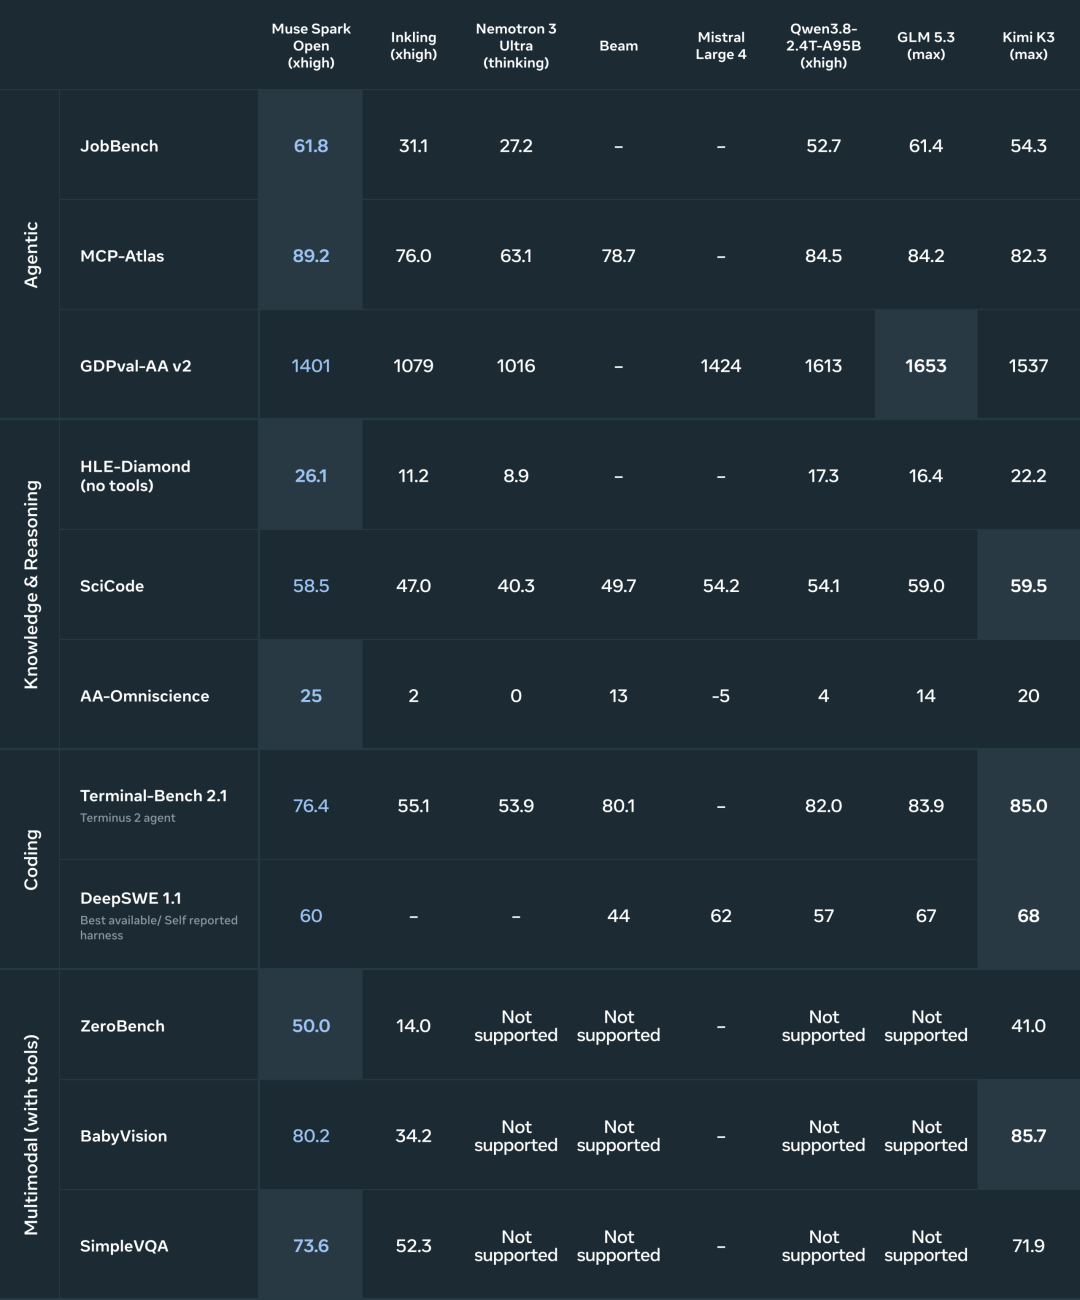
看起来,重走开原路线的 Meta 眼前的路还很长,Muse Spark Open 并不是全球最强的开放权重模型,它的编程、推理等能力不如 Kimi K3、MiMo-V2.6-Pro、Qwen3.8 Flash Next 和 GLM 5.3 Flash 等模型。
值得一提的是 Agent 评测能力。从官方模型卡可以看到,Muse Spark Open 在部分 Agent 指标上甚至领先于综合智能分数更高的模型。
Meta 这次给出的成绩对比,模型来自不同的 Harness,部分成绩来自模型厂商自报,看起来比较透明。比如 Muse Spark Open 使用 Muse Code,Kimi K3 使用 Kimi Code,Qwen3.8 使用 Claude Code。Agent 的实际能力取决于模型、Harness、工具、上下文管理和执行环境的共同作用。
未来开源模型的价值不能只看基础模型排行榜,还要看它能否进入真正的 Agent 工作流。
参考内容:
https://research.meta.ai/blog/muse-spark-open
https://www.axios.com/2026/10/15/apple-and-meta-bury-the-hatchet-for-ai
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com