新研究称多数大模型神经元分工单一,AI智能体或能规模化打开黑箱。
冷月清谈:
怜星夜思:
2、同一个神经元响应猫脸和汽车前脸,到底说明模型很混乱,还是人类的分类方式太窄?
3、让 AI 智能体研究另一个 AI,怎样避免它们共同编出一套听起来很合理的故事?
4、如果更大的模型反而分工更细、更容易解释,安全研究应该优先研究大模型还是小模型?
原文标题:神经网络可解释性被AI解决了?90%神经元只有一个功能
原文作者:机器之心
原文内容
这是 AI 领域最重要的成果之一。
本周五,OpenAI 可解释团队创建人 Nick Cammarata 的一篇超长文章震动了 AI 圈。他说利用现代智能体工具,万亿参数的大模型也是几乎可读的,我们对于神经网络「黑箱」的看法被证明是误解,预期的障碍大多不存在,可解释性将被解决,而且可能很快就会实现。
这可能是可解释性的「苦涩教训」:简单的事情,在荒谬的规模下,就能奏效。
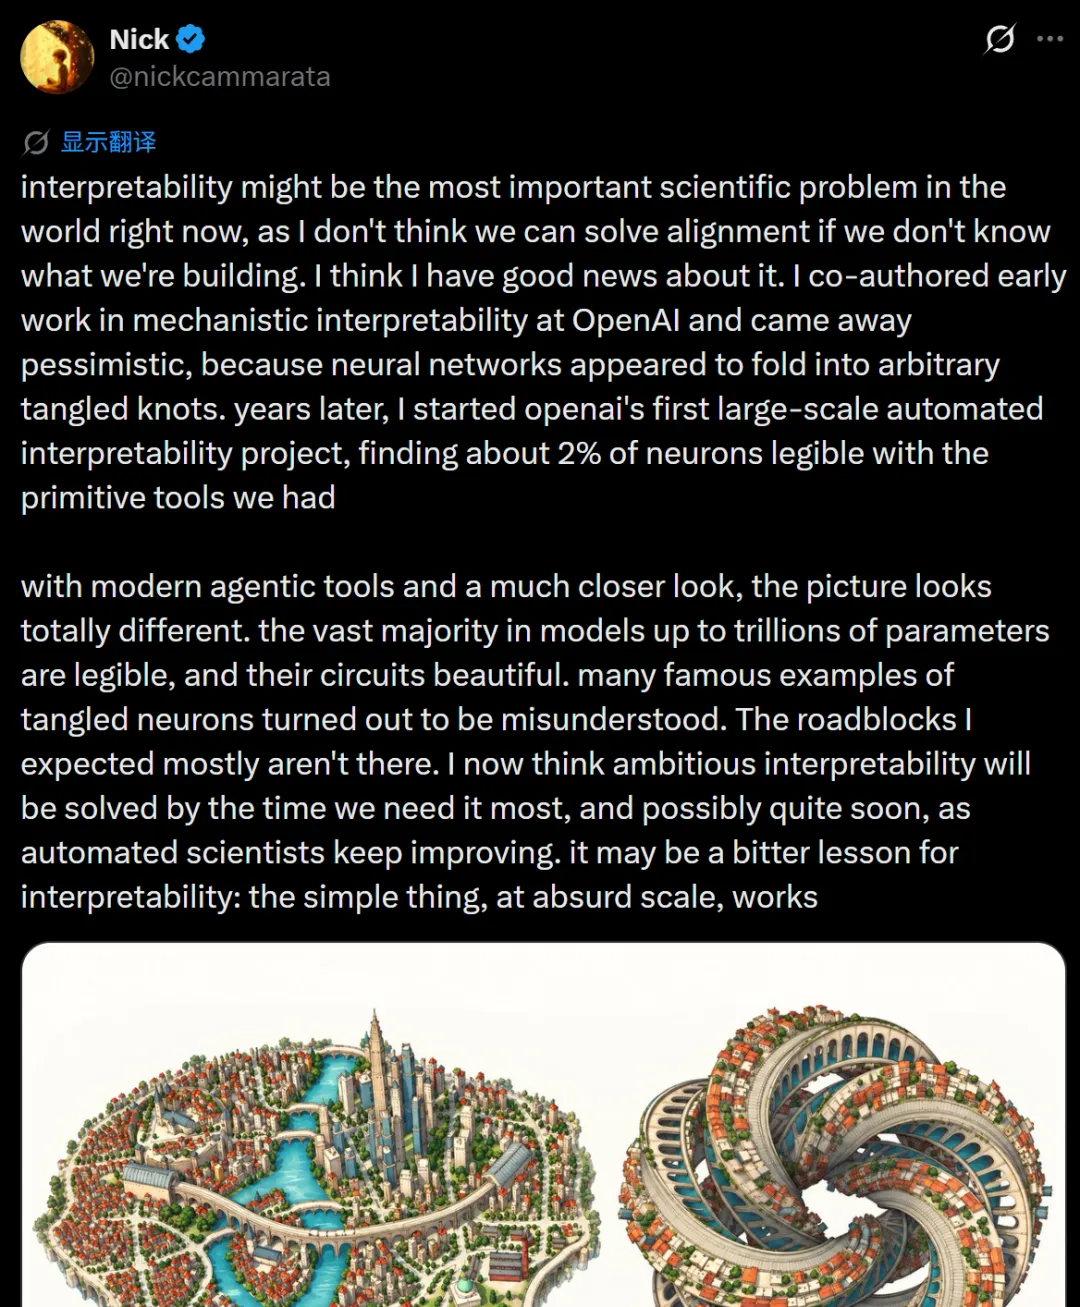
我们能训练出强大的 AI,却未必知道它为什么这样回答。如果让 AI 帮忙研究神经网络的「脑回路」,能否打开这个黑箱?答案似乎是肯定的。
Nick 的文章虽然极长(阅读需要 65 分钟),但是已经有一些研究者对此进行了解读。简单来说,神经网络并非纠缠的结(多义性是错误的)。你可以直接研究它们自身的神经元,而无需先用第二个模型「展开」它们。Qwen-32B 中 90% 的神经元只有一个任务。
这项工作最终可能让我们能够有意设计大型语言模型,并塑造它们的行为方式。
让我们看看他大致是怎么说的:
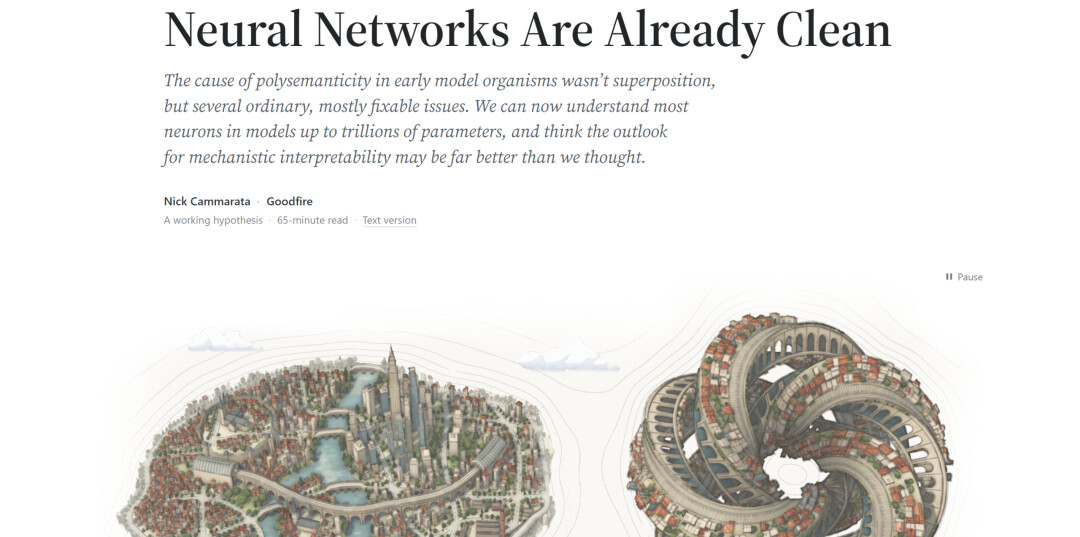
过去几年,AI 可解释性领域有一个令人沮丧的前提:神经网络是一团打了死结的线团。当神经元数量不够用,模型就会把毫不相干的概念折叠塞进同一个神经元,因为它们恰好互不干扰。想读懂它,必须先训练第二个模型(比如稀疏自编码器 SAE)把结解开。这个被称为 superposition 的假说,是整个安全研究路线的基础。
而现在,亲手打下这副地基的人站出来说:是我们看走眼了,神经网络本来就是干净的。
「猫和汽车」,也许从来就是一个东西
机制可解释性试图追踪神经元和计算回路,解释模型如何得到答案。困难之一是:一个神经元经常对看似毫无关系的东西产生响应。经典案例来自视觉模型 InceptionV1:同一个神经元既识别猫脸,又识别汽车前脸。
过去的重要解释是「叠加」:模型的空间有限,于是把互不相关、又不容易同时出现的概念压进同一组神经元。研究者因此尝试用稀疏自编码器等工具,把这些表征重新拆成可理解的特征。
Nick 如今认为,这个著名案例看错了。
重新检查图片和连接关系后,他发现,猫脸和汽车前脸共享一个特征:V 形。这个神经元还与 V 形火焰、狐狸脸等相关,而圆形会把它推向负向响应。换句话说,「猫和汽车」是人类给出的分类,网络找到的可能是跨越这些类别的形状规律。
他由此提醒:神经元未必像名词,负责给物体贴标签;它们也可能像动词,负责区分模式,把信息送往不同的下游回路。
我们眼中的混乱,有时只是模型使用了我们没想到的分类。
多义性的真相:像树枝一样分叉
另一些神经元确实有多种用途,但作者认为,这也未必源于无关概念的随意混装。
Nick 提出「递归泛化」(recursive generalization):神经元从一个模式出发,逐渐长出相关分支,分支又继续生长。一个识别「iy」的神经元,可以扩展到「diy」,再扩展到完全不含「iy」的「do it yourself」。一个地质神经元会分枝到名为 Cesium 的地理 JavaScript 库。这不是在高维空间里藏匿信息,而是在语义相邻的领地上生长。他强调,superposition 是最激进、也最难证伪的解释,理应成为最后假设,而他自己曾当了它多年的信徒。
只看训练结束后的响应,这几项可能显得关系松散;沿着训练过程追踪,却能看见它们如何连接起来。
工具也会制造误解。团队发现,一个被自动解释工具标为「多义逗号神经元」的单元,实际与科罗拉多州有关:它响应当地电话区号、俚语等信息,增强它还会让模型倾向于规划徒步旅行。逗号只是模型汇总前文语境的位置。盯着响应发生的字符,反而会错过真正的含义。
2023 年,OpenAI 的自动可解释性项目用最宽松的标准也只找到约 1.7% 可解释神经元,如今在对 Qwen3-32B 的初步审查中作者估计,约 90% 的神经元正、负「极」各自有一项主要工作,约 7% 有两项相关工作,约 2%—4% 尚未理解。这个数字取决于激活阈值,以及如何界定「一项工作」。
稠密模型和 MoE 模型结论相近,作者在 Kimi K3 上得到的是同样的结果:他们在 Kimi K3 上做出了已知首个万亿参数模型的归因图,捡到钱包的问题里,钱包、现金、证件连通失物招领与诚实,最后输出「归还」。用新工具重审当年的 GPT-2 XL,约 70% 的神经元也已大致是「一回事」。
让 AI 科学家研究 AI 内部
这项工作的另一条主线,是智能体改变了研究规模。
AI 可以检查神经元样本、提出解释、追踪上下游连接,再设计实验寻找反例。研究者还让智能体检查了十万张归因图,作者本人也检查了数千张。
怎样避免 AI 编出一个听起来合理的故事?
一种测试是:第一个智能体研究神经元并写下解释;第二个只看解释,生成一个预计能强烈激活它的新样本,再交给网络测量。作者报告,有些样本的激活强度,超过了他们从百亿 token 语料中找到的所有例子。团队也生成「看起来接近、实际不该触发」的反例,并通过移除神经元、增强激活等干预,检查解释能否预测模型行为。
解释由此变成可以被实验推翻的假说。
Cammarata 还提出一个反直觉的见解:理解更多网络,有时会让剩下的部分更容易理解。像填字游戏一样,相邻答案越多,一个空格能填什么就越受约束。较大模型的神经元也可能分工更细,反而更容易辨认。
这让他想到可解释性领域自己的「苦涩的教训」:简单的观察、假设与检验,在足够大规模上,也许比不断设计精巧的拆解方法更有效。
这仍不是「可解释性已经解决」的宣言。注意力机制、完整模型审计,以及如何把理解转化为可靠的安全改进,都有大量工作待做。但它提供了一个值得认真检验的方向:如果神经网络内部已有可追踪的组织,未来的突破,可能来自一座由 AI 科学家参与运转的实验室,持续观察模型、提出问题,并逐个验证答案。
参考内容:
https://already-clean.goodfire.com/
https://news.ycombinator.com/item?id=50105647
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com