用 OKF 管权威事实、RAG 查海量资料,构建双记忆 AI Agent。
冷月清谈:
怜星夜思:
2、企业里哪些知识值得放进 OKF,哪些继续交给 RAG 更合适?
3、智能路由如果分错了问题,混合架构会不会反而比单独使用 RAG 更复杂?
4、文中的关键词匹配示例离生产可用还有多远,应该先补哪些能力?
原文标题:独家丨OKF + RAG:终极智能体架构
原文作者:数据派THU
原文内容
作者:Ravish Khullar翻译:尹悦校对:周梓溢本文约2000字,建议阅读5分钟
本文介绍了 OKF+RAG 混合智能体架构,融合确定性知识与概率检索。
每一个 AI Agent都面临着记忆问题。向它询问一个广为人知的常识问题,它可以给出令人满意的回答。但如果你问它企业专属的客户流失率计算公式、内部 API 规范,或是数据库故障转移的生产运维手册,它会自信地编造一套听起来完美、实则完全错误的答案。
这就是幻觉问题(Hallucination),也是阻碍企业将实际业务交由 AI Agent处理的最大障碍。
过去两年,行业给出的解决方案是 RAG(检索增强生成):把 AI 连接到存储企业文档的向量数据库,让模型检索相关上下文,并将上下文拼入提示词。
RAG 在处理海量非结构化文档集时效果不错,但存在一个致命缺陷:它是概率性的。它只能找到和问题在语义上相似的文档,而非具备事实权威性的文档。对于关键业务数据 —— 例如营收的精确计算公式、支付接口的标准 API 协议 —— 仅仅 “相似” 远远不够。
2026 年 6 月,谷歌云推出开放知识格式(OKF,Open Knowledge Format),这是一套与厂商无关的开放规范,可通过简单 Markdown 文件存储经过整理、具备权威性的知识。将 OKF 的确定性精准能力与 RAG 的概率检索能力相结合,就得到了很多人所说的终极 AI Agent架构。
两套记忆系统
想象一名行业专家入职贵公司第一天。
他会拿到两类资料:
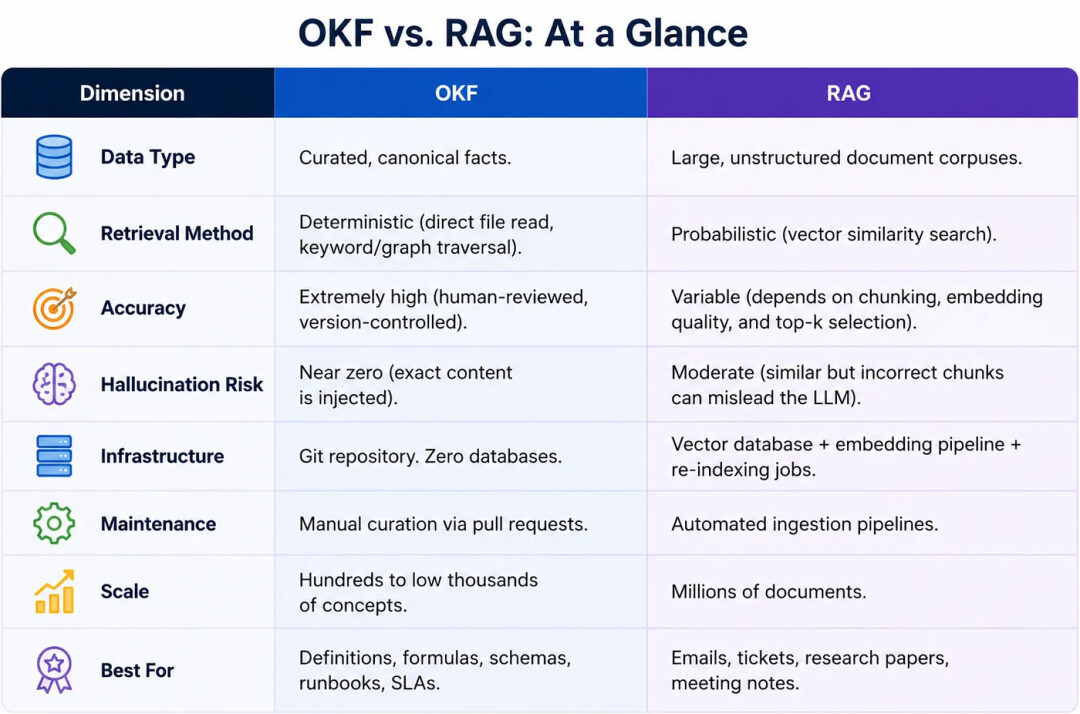
1.企业知识库(OKF):这是一套经过整理、结构清晰的内部知识库,包含权威定义、API 文档、指标计算公式与运维手册。库内所有内容均经过审核、批准,并做版本管理。当你需要官方标准答案时,就查阅这里。
2.通用搜索引擎(RAG):可读取成千上万条 Slack 消息、邮件、客服工单以及会议纪要。当你需要查找人们针对某个话题的讨论,或是挖掘埋藏在非结构化归档资料里的信息,就使用这套检索。
两套系统各自独立运行时,都无法满足企业的全部需求。只有将二者结合起来,才能覆盖企业全部知识场景。


什么是 OKF?(开放知识格式,Open Knowledge Format)
OKF 在设计上追求极致简洁。一个 OKF「知识包」仅仅是存放于 Git 中的 Markdown 文件目录。每个文件对应一个独立概念 —— 一张数据库表、一项指标、一个 API 接口、一份运维手册,并且在文件头部包含一段 YAML 前置元数据块,供机器读取。
以下是业务指标对应的一份 OKF 文件示例:
---
type: metric
title: "Monthly Churn Rate"
description: "Official formula for calculating monthly customer churn."
owner: "data-engineering"
tags: [revenue, kpi, board-report]
timestamp: 2026-06-20T10:00:00Z
---
# Monthly Churn Rate
The official churn rate formula used in all board reports and investor decks:
Churn Rate = (Customers Lost During Month / Customers at Start of Month) × 100
### Rules
- **Do NOT** use trial accounts in the denominator.
- **Do NOT** count plan downgrades as churn.
- Source of truth: `analytics.monthly_churn_summary` table.
### Related
- [Monthly Active Users](mau.md)
- [Revenue Dashboard](revenue_dashboard.md)
为什么这一点至关重要
-
无需向量计算,杜绝模型幻觉。当AI Agent需要查询客户流失率计算公式时,会直接读取对应的文件。不存在嵌入向量、余弦相似度、“Top-K 近邻检索”等环节,每次都能获取准确、经过审批的标准答案。
-
原生支持 GitOps。由于 OKF 知识包存储于 Git 仓库,所有修改均可通过拉取请求、代码评审与提交历史进行追踪。由此可以获得完整审计链路:谁修改了流失率公式、修改时间以及修改原因。
-
无需额外基础设施。无需向量数据库、向量嵌入流水线、文本分块策略,也不用重建索引任务,只需要一个文件夹内的若干文件。
什么是 RAG?(检索增强生成)
RAG 是将大语言模型(LLM)对接海量非结构化数据的行业标准方案,工作流程如下:
1. Ingesting导入数千份文档(PDF、邮件、Confluence 页面、Slack 消息)
2. Chunking将文档切分为较小的文本片段
3. Embedding使用嵌入模型把每个文本片段转换为高维向量
4. Storing将生成的向量存储到向量数据库(例如 Pinecone、Weaviate、pgvector)
5. Searching将用户的问题映射至同一向量空间,数据库返回语义最相近的文本块
6. Augmenting将这些文本块追加到大模型提示词中,使模型生成有据可依的回答
RAG 的优势在于信息覆盖广泛:它能从成千上万份人工难以整理的非结构化文档中提取相关信息。
但 RAG 在精准度上存在不足。由于依赖语义相似度运算,它返回的文档只是和问题相关,却未必是权威的信息来源。如果三条 Slack 对话对客户流失率的定义略有出入,RAG 有可能检索到错误的版本。
混合架构:OKF + RAG
这套终极AI Agent架构采用智能路由模块,对用户输入的查询进行分类,并将请求分发至对应的记忆系统。
路由模块的判定逻辑
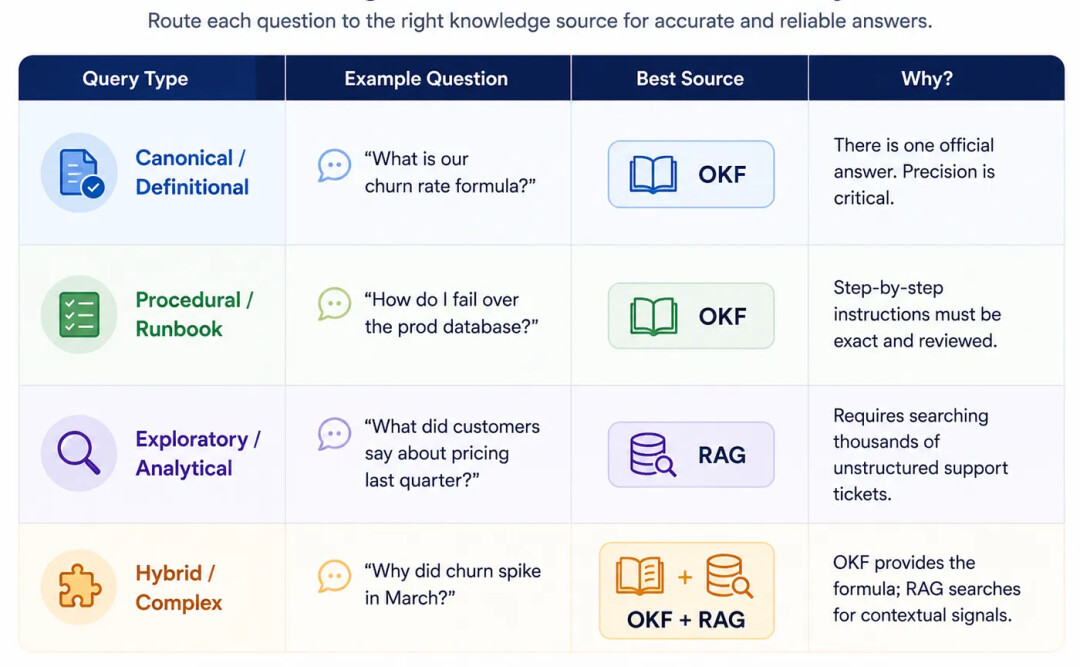
实现示例
以下是混合路由模块的简化 Python 实现代码:
from openai import OpenAI
import os
import glob
import yaml
client = OpenAI()
# 1. Load the OKF knowledge bundle from the local directory
def load_okf_bundle(bundle_path: str) -> dict:
"""Reads all Markdown files in the OKF directory into a searchable dict."""
knowledge = {}
for filepath in glob.glob(f"{bundle_path}/**/*.md", recursive=True):
with open(filepath) as f:
content = f.read()
# Extract the title from YAML frontmatter
if content.startswith("---"):
_, frontmatter, body = content.split("---", 2)
meta = yaml.safe_load(frontmatter)
title = meta.get("title", os.path.basename(filepath))
knowledge[title.lower()] = body.strip()
return knowledge
# 2. Search OKF (deterministic, keyword-based)
def search_okf(query: str, okf_knowledge: dict) -> str | None:
"""Simple keyword match against OKF titles."""
for title, content in okf_knowledge.items():
if title in query.lower():
return content
return None
# 3. Search RAG (probabilistic, vector-based)
def search_rag(query: str) -> str:
"""Placeholder for your vector DB search (Pinecone, Weaviate, etc.)."""
# results = vector_db.similarity_search(query, top_k=5)
return "RAG context: [retrieved chunks would appear here]"
# 4. The Intelligent Router
def answer_query(query: str, okf_bundle_path: str) -> str:
okf_knowledge = load_okf_bundle(okf_bundle_path)
# Try OKF first (deterministic path)
okf_result = search_okf(query, okf_knowledge)
if okf_result:
context = f"[SOURCE: Official Knowledge Base (OKF)]\n{okf_result}"
else:
# Fall back to RAG (probabilistic path)
context = f"[SOURCE: Document Search (RAG)]\n{search_rag(query)}"
# Send to LLM with the retrieved context
response = client.chat.completions.create(
model="gpt-4o",
messages=[
{"role": "system", "content": "Answer using ONLY the provided context."},
{"role": "user", "content": f"Context:\n{context}\n\nQuestion: {query}"}
]
)
return response.choices[0].message.content
结语
企业 AI Agent的未来,并非要在 OKF 与 RAG 之间二选一,而是在于构建同时发挥两者优势的混合架构。
OKF 为AI Agent提供经过整理、可避免幻觉的记忆系统,用于存储最关键的事实信息:关键绩效指标(KPI)、API 协议、运维操作手册。RAG 则赋予了Agent检索大规模无法依靠人整理的非结构化知识档案的能力。
将受 Git 管控的确定性知识库与概率型向量检索引擎相结合,即可打造出一款 AI Agent:在需要严谨准确时保证精度,在需要挖掘信息时具备探索能力。
原文标题:
OKF + RAG: The Ultimate AI Agent Architecture
原文链接:
https://medium.com/@ravishkhullar/okf-rag-the-ulti
mate-ai-agent-architecture-26b9ceed44f1
编辑:于腾凯
校对:林亦霖
译者简介
翻译组招募信息
工作内容:需要一颗细致的心,将选取好的外文文章翻译成流畅的中文。如果你是数据科学/统计学/计算机类的留学生,或在海外从事相关工作,或对自己外语水平有信心的朋友欢迎加入翻译小组。
你能得到:定期的翻译培训提高志愿者的翻译水平,提高对于数据科学前沿的认知,海外的朋友可以和国内技术应用发展保持联系,THU数据派产学研的背景为志愿者带来好的发展机遇。
其他福利:来自于名企的数据科学工作者,北大清华以及海外等名校学生他们都将成为你在翻译小组的伙伴。
点击文末“阅读原文”加入数据派团队~
转载须知
如需转载,请在开篇显著位置注明作者和出处(转自:数据派ID:DatapiTHU),并在文章结尾放置数据派醒目二维码。有原创标识文章,请发送【文章名称-待授权公众号名称及ID】至联系邮箱,申请白名单授权并按要求编辑。
发布后请将链接反馈至联系邮箱(见下方)。未经许可的转载以及改编者,我们将依法追究其法律责任。

点击“阅读原文”拥抱组织