OpenAI公开722篇AI数学手稿,真正的考验是独立验证与原创性审查。
冷月清谈:
怜星夜思:
2、一份证明通过Lean检查后,我们还需要担心哪些问题?
3、如果前沿科研越来越依赖昂贵算力,会不会让少数公司掌握研究方向的话语权?
4、AI参与提出定理和证明后,论文署名、学术责任与成果归属应该怎么划分?
原文标题:OpenAI 狂甩 722 篇数学手稿!数学家直呼看不完
原文作者:图灵编辑部
原文内容
10 月 6 日,OpenAI 在 GitHub 上公开了一个名为 openai/math 的数学成果库:722 篇手稿、372 个成果族,覆盖数论、几何、组合数学、理论计算机科学、概率论、算子代数、数学物理、偏微分方程等 17 个方向。
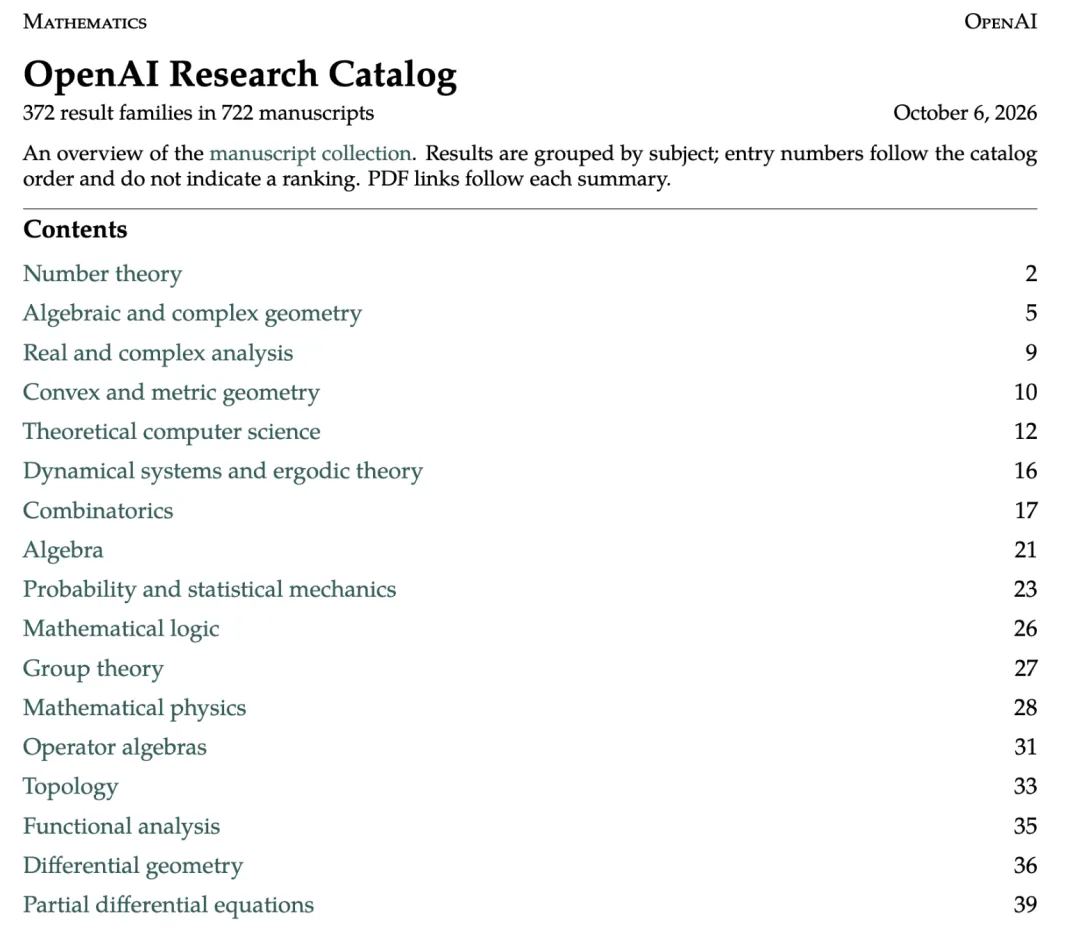
(GitHub地址:https://github.com/openai/math)
它不是一次新模型发布,也没有一场声势浩大的发布会。OpenAI 只说,这些结果由一款尚未命名、尚未公开的内部前沿模型生成。
但这件事值得关注的地方,不在于 AI 一夜解决了多少世纪难题,而在于 AI 已经开始以一种更接近科研的方式,提出大量可供人类检验的数学主张、证明思路和形式化材料。
当然,前提是——其中相当一部分成果最终经得起验证。
它到底公开了什么?
这次公开的并不只是论文标题或结论,而是一整套研究材料。
首先,是 722 篇数学手稿。这些手稿被归入 372 个成果族。一个成果族可以包含同一问题的主定理、不同证明、加强版本、应用或推论,所以不能简单地把它理解为 722 项彼此独立的数学突破。
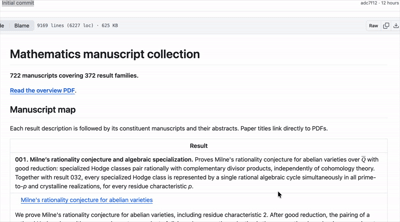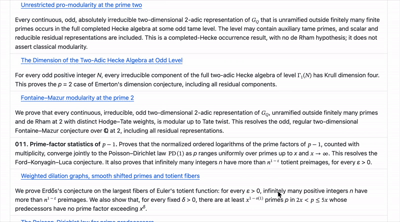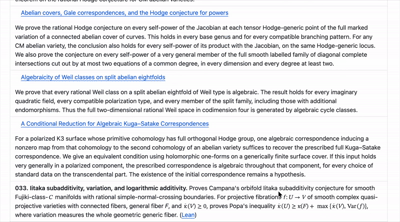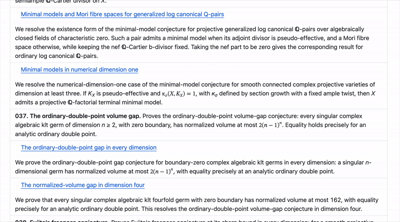
其次,是部分成果的 Lean 形式化证明材料。
Lean 是一种形式化证明系统。通俗说,人类写数学证明时,往往会略过一些显然的步骤;而 Lean 要求把每一步都写成计算机能检查的形式。只要证明在既定定义和公理范围内通过检查,至少可以确认,这段形式化代码确实推出了它所声明的结论。
此外,OpenAI 还公开了 10 份推理摘要,展示模型如何寻找反例、修改估计、比较已有文献、反复处理困难环节。
这很重要。过去我们看到的 AI 数学能力,通常是奥数得分、基准测试排名,或某一道题的漂亮答案。此次公开的,则是一批可以被数学家、形式化验证研究者和其他 AI 系统逐条审查的研究材料。
其中有哪些值得留意的信息?
这批材料中,有一些主张涉及知名未解问题或长期难题的特定情形。
例如:
-
在数论中,成果库声称为黎曼 ζ 函数及相关 L 函数给出了新的无零区域;
-
对具有复乘的阿贝尔簇,声称推进了有理霍奇猜想的特定情形;
-
在椭圆曲线问题上,声称在低 Selmer 余秩条件下给出了 Birch–Swinnerton-Dyer 猜想的首项公式;
-
声称证明了加泰罗尼亚常数是无理数;
-
声称证明 π 的无理度指数恰好为 2;
-
在理论计算机科学中,包含唯一博弈猜想、近似算法困难性、等差数列等问题;
-
在几何中,涉及马勒猜想;
-
在数学物理与偏微分方程中,涉及量子 Heisenberg 铁磁体、相对论性 Vlasov–Maxwell 系统等问题。
这些名称很容易让人误读成 AI 已经解决了黎曼猜想或AI 已经攻克纳维—斯托克斯方程。
并不是!
以黎曼猜想为例,完整猜想要求所有非平凡零点的实部都等于 1/2;公开材料所声称的是,在实部大于 7/8 的区域没有零点。即便该证明成立,它也是重要推进,但离完整黎曼猜想仍有距离。
同样,涉及霍奇猜想、BSD 猜想和 Navier–Stokes 方程的内容,也都带有明确的适用对象、附加条件或问题范围。真正严谨的读法,不是盯着一个著名问题名称,而是看它究竟证明了什么、在什么条件下证明、哪些推论已经被形式化核验。
“有 Lean 证明”是否等于已经证实?
也不能这么理解。
这批发布中,许多成果附带了 Lean 相关材料,但并不代表所有 722 篇手稿都已经完成形式化验证。
公开信息显示,约 372 个成果族中,有 235 个具有范围说明页,形式化清单本身也标为部分进展,审查状态则为未检查。
这意味着至少要区分四个层次:
-
模型提出了一个数学主张;
-
模型写出了自然语言手稿;
-
某个定理陈述与证明的一部分被形式化;
-
形式化代码被独立、完整地运行和验证,并且数学界确认它确实对应论文所声称的结论。
这四层之间,不能跳跃。
但反过来说,OpenAI 愿意公开手稿、代码、范围说明和推理摘要,本身是一个比我们在某项测试中得了多少分更严肃的动作。它把验证的入口交给了外部世界。
这说明 AI 的科研能力到了哪一步?
最值得关注的,不是某一篇论文是否足以震动数学界,而是广度和可重复性。
如果未来验证显示,这 372 个成果族中有相当比例是正确、原创且有价值的,那么它说明的将不是 AI 偶然做对了一道难题,而是 AI 可能已能够在多个专业方向上,反复参与以下工作:
-
阅读和调用已有理论;
-
尝试不同证明路径;
-
搜索反例与修正漏洞;
-
生成新的引理、构造与猜想;
-
将一个结果连接到另一个结果;
-
为后续研究提供新的起点。
科学研究从来不是只靠灵光一现。它还包括大量寻找路径、检查边界、修补论证、比较方法和判断问题价值的工作。如果 AI 能可靠地承担其中的一部分,科研的吞吐量就可能显著提高。
过去,一个研究团队也许只能深入追踪十条思路。未来,它可能先让 AI 并行探索几百条,再由人类研究者筛选、验证和发展其中最有希望的部分。
算力投入也透露了一个现实
OpenAI 披露的一个数字是,平均每项成果使用了大约相当于三小时 ChatGPT Pro 深度思考的算力。
这个数字不能直接换算成 GPU 时长、项目总成本或 AI 三小时就做完一篇论文。它也没有说明失败尝试是否计入、每项成果对应多少次探索、是否包括形式化和工具调用。
但它至少提示了一件事,未来科研能力可能越来越像一种可以配置的资源。
如果把更多算力投入给一个模型,它或许可以探索更多假设、生成更多候选证明、检验更多反例。问题不再只是模型会不会做,还会变成我们愿意为一个研究问题投入多少计算预算,以及谁拥有这种预算。
这也带来新的不平等,如果最强的科研模型和算力只掌握在少数公司或者实验室手里,那么它们可能会对哪些问题值得研究拥有越来越大的影响力。
对人类科学研究意味着什么?
我觉得至少有三层含义。
第一,科研的瓶颈可能从提出候选答案转向验证与理解候选答案。
当 AI 可以快速生成大量看上去合理的论文、证明和推论时,最稀缺的资源可能不再是内容,而是可信的验证:谁来检查?怎么检查?哪个结论值得投入专家时间?不同结果之间能否真正衔接?
第二,科学合作的单位可能发生变化。
未来的研究不一定是一个人独立完成一篇论文,也可能是人类提出方向和标准,AI 大规模搜索与生成,形式化系统筛查逻辑,再由专家解释、验证和纳入知识体系。
在这种模式中,人类的作用不会自动消失,但会更集中在问题选择、概念判断、证据标准、跨领域理解和责任承担上。
第三,我们需要重新理解会做题和会研究的区别。
AI 能给出一个答案,不等于它理解答案。AI 能写出一篇手稿,也不等于结论已经成为数学知识。科学不是生成文本,而是建立可复核、可解释、可传承的可靠知识。
这也是为什么这次事件的真正价值,不在于立刻宣布 AI 取代科学家,而在于它把一个更现实的问题推到了面前:
“当机器越来越擅长提出可能正确的新知识,人类该如何组织验证、分配信任,并决定什么值得继续追问?
OpenAI 这 722 篇手稿,也许不会全部成立,甚至其中一些重要主张很可能会被修正或推翻。
但如果其中有相当部分最终站得住脚,那么它标志的不是一次普通的模型演示,而是科学研究进入了一个新阶段:AI 不再只是帮助人类查资料、写代码和做计算,也开始参与提出人类此前不知道的答案。
图灵 AI365
在飞速变化的 AI 环境下,给你最好的 AI 视野。与其被 AI 推着跑,不如花点时间,站高一点看清方向,每天不到 1 元钱,加入图灵 AI 365。👇
-
一线实践者经验分享:我们邀请真正在做 AI 落地的工程师、作者和专家,分享他们踩过的坑和总结出的方法,不讲空话;
-
帮你筛掉噪音:我们替你追热点、做筛选,你只需要花一点时间,就能看清什么是趋势,什么只是泡沫;
-
能提问,能交流:直播里可以直接和嘉宾互动,就像文章里说的,找个懂行的朋友聊聊,胜过自己闷头摸索;
-
全年陪伴学习:每月直播,覆盖前沿 AI 方向,错过也有回放。还能入群跟志同道合的小伙伴共学。