RH Upscale主打视频超分保真,并以五档模式平衡画质、速度和成本。
冷月清谈:
怜星夜思:
2、生成式超分补出来的发丝、皮肤和纹理并非真实记录,“放大而不改内容”的边界应该怎么定?
3、面对Ultra到Low五档模式,视频团队该怎样选择,才能避免画质过剩或算力浪费?
4、生成式视频超分如果用于老影像、监控或新闻素材,会不会让观众把“模型猜测”误认为真实细节?
原文标题:13 组横评综合性能第一!RunningHub 发布 RH Upscale,瞄准视频超分「不变样」难题
原文作者:机器之心
原文内容
视频超分一直有个很难绕开的两难。
传统方法能把分辨率拉高,却很难真正找回已经丢失的细节。生成式方法可以「补细节」之后,另一类问题又出现了——人物变样、构图偏移,放到连续视频里,还可能出现闪烁和拖影。
画面要更清楚,原来的内容又不能被改掉。
现在,海马云旗下 RunningHub 正式发布自研生成式视频超分模型 RH Upscale,瞄准的正是这组长期存在的矛盾。在13 组横向评测中,RH Upscale Ultra 以 0.539 的综合得分位列第一!
RunningHub 是海马云旗下原生 AI 智能体驱动的全能内容创作平台,支持 ComfyUI 工作流、无限画布、AI 应用与模型 API 调用等专业创作工具,覆盖从模型调用到内容生成的多个创作环节。
-
体验链接:
https://www.runninghub.cn/call-api/api-detail/2102380957716844546
RH Upscale 把核心目标直接定在了「放大而不改内容」上,在提升分辨率、恢复纹理的同时,尽量保持人物、构图、色调以及运动过程的一致性。
13 组横评,
RH Upscale 拿下综合性能第一
这次横向评测,一共纳入 13 个参测配置,包括 RH Upscale 的五档模式以及多种视频超分方案。测试统一采用 540P 输入、1080P 输出,从感知画质、纹理还原、原始画面相似度、人脸一致性和时序视频质量五个维度进行比较。
最终,RH Upscale Ultra 以 0.539 的综合得分位列第一。
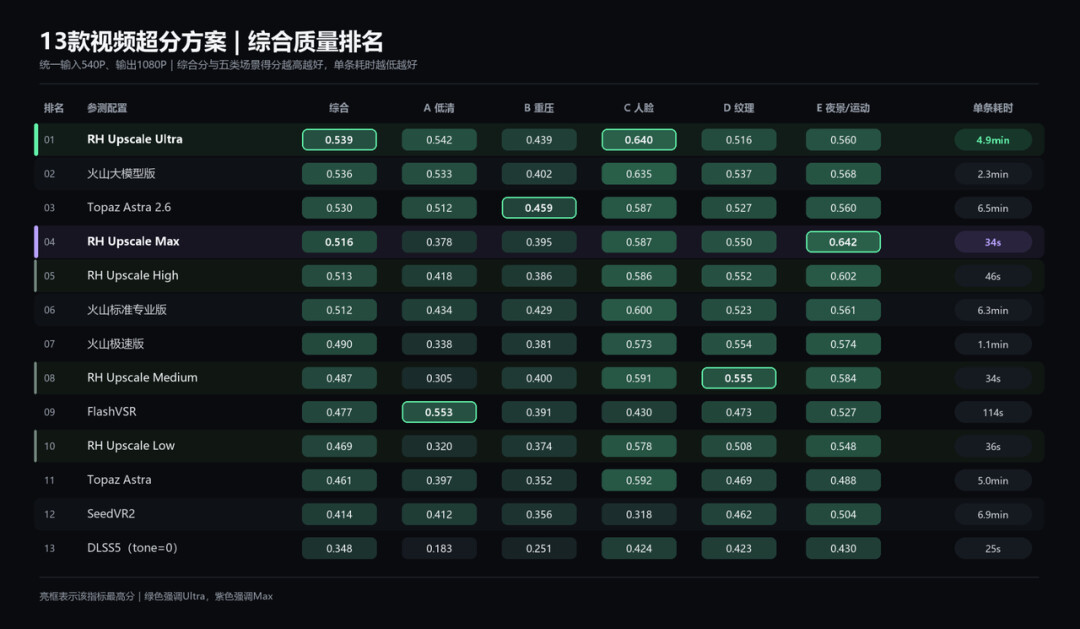
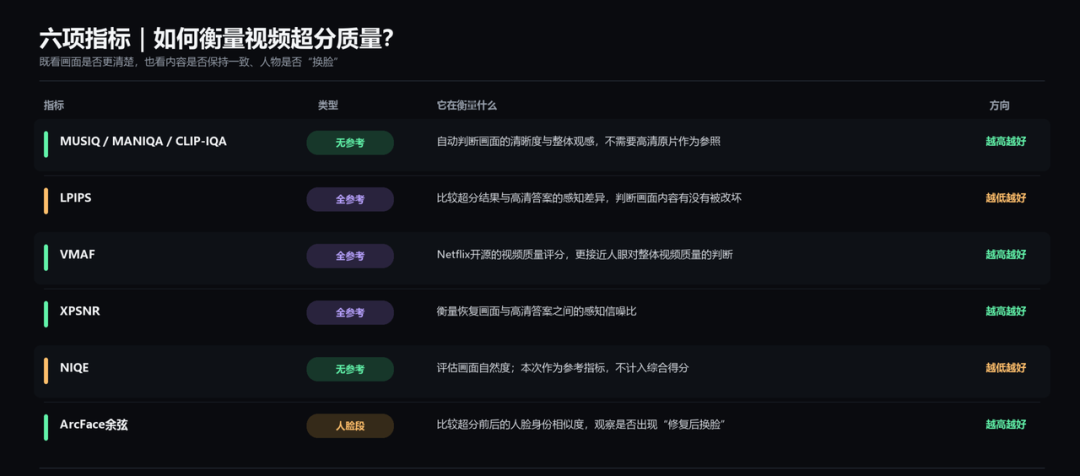
RH Upscale 把问题重新拉回到生成式超分最核心的矛盾上:生成能力越强,越需要知道什么需要补,什么不能动。
放大不改内容,
RH Upscale 怎么给生成「划边界」
过去的视频放大,更多依赖插值和锐化。它们可以把分辨率拉高,却难以真正找回低清、压缩过程中已经丢失的细节。发丝、皮肤、织物、环境纹理,这些信息一旦没了,单纯放大像素并不能把它们重新加回来,噪声和压缩痕迹反而可能因此被放大。
生成式超分提供了另一条路。
它不只放大已有像素,还会尝试重新生成缺失的细节。效果可以更丰富,但风险也随之而来:人物和构图都可能变化,到了视频里,还要面对闪烁、纹理跳变和运动拖影。
所以对生成式视频超分来说,困难的不只是「能不能补上细节」,还有在补的过程中如何保持一致性。
RH Upscale 的做法,是采用「内容保真约束下的时空联合重建」,把这个问题拆成几个环节。
首先,是判断哪里真的需要增强。
不同素材的问题不一样,有的整体模糊,有的噪声更明显,有的则是在压缩后损失了局部细节。RH Upscale 通过退化感知与条件注入识别这些差异,再根据不同区域决定增强力度。
这样,模型就不需要对整幅画面做统一处理。需要恢复的区域可以多补一些,噪声或压缩损伤明显的地方则区别对待,避免在放大的同时把问题一起放大。
接下来,是判断哪些内容应该尽量保持原样。
RH Upscale 使用结构 — 细节双分支重建,把结构保持和纹理恢复分开处理。结构一侧尽量保持原有构图、轮廓和光影,细节一侧负责恢复已经缺失的纹理。
对于信息本来就不足的区域,增强会更保守一些。因为生成式超分最容易出问题的地方,往往是模型「补得太多」的时候。
但视频比图片还多了一层麻烦。这一帧补得很恰当,不代表下一帧还能一样好。
人物运动、物体遮挡、镜头切换,都可能让前后帧之间失去连续性。于是 RH Upscale 还加入了时空建模与可靠性门控,让模型利用前后帧信息维持连续,并在遮挡、镜头切换等情况下调整上下文,减少闪烁和拖影。
这也是 RH Upscale 实现「放大而不改内容」的核心思路。
而从这套技术路径也能看出,RunningHub 在做的已经不只是把模型接进平台。它开始继续往视频生产的下游走,围绕画质增强、内容保真和时序稳定这些更具体的问题,做自研和工程优化。
而当内容生产者真正上手 RunningHub,又有一个问题出现了。
如果不同视频对画质、速度和成本的要求完全不同,超分还有必要全部跑最高规格吗?
画质、效率都要兼顾,
一套模型做五档超分
真正进入生产以后,会发现不是所有视频都需要最高规格的超分。
精品短剧、商业广告、人物特写、高价值剪辑母版,更在意最终画质和内容保真;而素材预览、快速迭代以及大批量视频加工,则需要同时考虑处理速度和算力成本。
如果所有素材统一使用同一种最高质量配置,质量是上去了,效率和成本却未必划算。
因此,RH Upscale 提供 Ultra、Max、High、Medium、Low 五档模式,让不同任务根据题材、交付标准和任务规模选择不同的质量与效率配置。
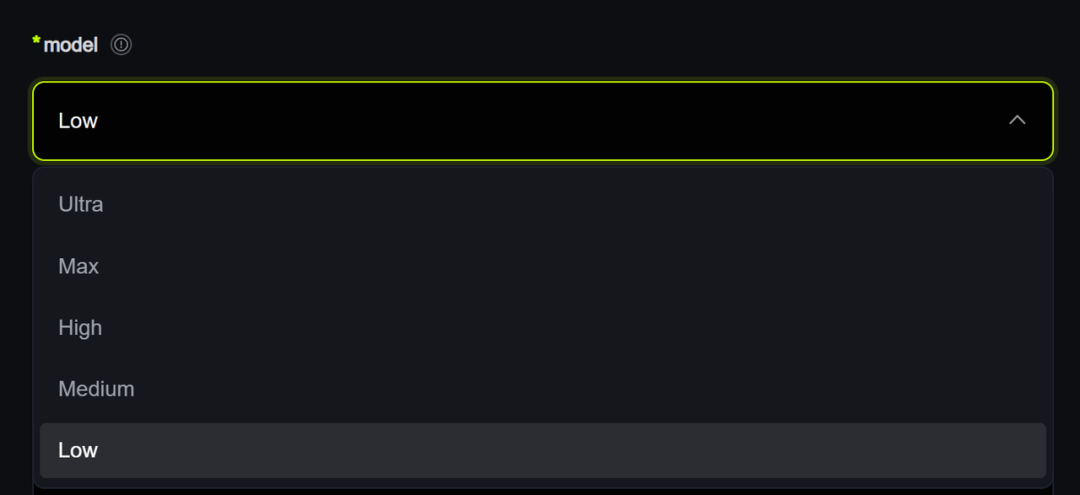
RH Upscale 提供 Ultra、Max、High、Medium、Low 五档模式,覆盖从高画质成片到快速批量处理的不同需求。
其中,Ultra 使用更充足的迭代重建预算,主要面向复杂退化和精细材质这类更难处理的场景。前面提到的 13 组横向评测中,Ultra 拿到了综合质量第一。
Max 则明显更偏向效率。它通过少步一致性蒸馏压缩采样,在保留结构和时序约束的同时缩短推理时间。按照测试结果,一段 5—10 秒的视频做 2 倍超分,Max 耗时 34 秒,约为 Ultra 的 1/8.6。
同一段 4 秒、540P 原视频分别使用 RH Upscale Max 与 Ultra 进行超分。两档均提升了人物与织物等区域的细节表现,Ultra 在发丝、毛衣纹理等细节上恢复更充分,Max 则更偏向处理效率。
这两个档位其实已经把思路说明得很清楚了。有些素材值得多花算力,把画质尽量往上拉;有些素材则更需要在「够用」的前提下尽快跑完。
High、Medium 和 Low 继续把这个范围往中间和轻量场景展开,用来覆盖不同预算和批量处理需求。
但这五档也不是把同一套推理流程简单地减少几步。
RH Upscale 在不同档位中还配合了条件特征缓存、窗口化注意力、分块解码等优化方式,并针对 Ultra、Max 等配置使用不同的采样预算和训练、推理策略。最终由同一套模型体系衍生出五档业务模式,而无需维护五个彼此独立的模型。
RH Upscale 的五档设计非常符合真实的生产需求,能够把一个单纯的模型能力,往可调度、可取舍的生产工具推进。
从生成、加速到超分,
一条逐渐清晰的 AI 视频生产链
我们把视角拉远一些,RH Upscale 并不是一次孤立的模型发布。
此前,RunningHub 已经具备模型接入、工作流和内容创作平台的能力。围绕视频生产,平台近期又陆续推出 RH Enhanced 和 RH Lightning。前者面向量产视频生成,后者则围绕推理加速进行优化。RH Upscale 加入之后,能力进一步向生成后的画质增强延伸。
RH Upscale 也已经接入 RunningHub 的创作链路,可以放在视频生成节点之后继续完成超分和编码输出。
同时,它的输入并不限于 AI 生成素材。实拍录像、二次剪辑视频和经过压缩损伤的低清文件,同样可以进入 RH Upscale 进行分辨率提升和画质修复。
这也让 RunningHub 最近几次动作的方向逐渐清晰,在持续接入模型之外,平台开始围绕视频真正进入生产后遇到的生成效率、画质增强和交付流程补充自己的能力。
再往底层看,这条路径也和海马云过去的技术积累有关。
海马云长期积累 GPU 容器调度、图形虚拟化、实时流媒体和云渲染能力,如今这套基础设施进一步延伸到 AI 推理和内容生产,形成「渲推一体」能力:渲染和 AI 推理共享底层调度体系,再向上支撑 RunningHub 等内容生产工具。
从 RH Enhanced、RH Lightning 到 RH Upscale,这条路径越来越清楚。当 AI 视频真正进入生产,需要被解决的,远远不止「生成」本身。
会「变」之后,更难的是保持「不变」
过去几年,AIGC 最显眼的能力,几乎都和「变化」有关。
人物和场景可以换,原本不存在的细节也可以被重新生成。让画面发生变化,已经越来越容易。
但越往下走越发现,保持「不变」是「变化」里最难做到的一环。
人物、构图和色调要尽量保持稳定,新增的细节也要在连续帧里保持稳定。对视频超分来说,画面更清楚只是第一步,真正难的是在增强之后,人物还是那个人物,场景还是那个场景,运动过程也没有被重新改写。
这也是 RH Upscale 所强调的「放大而不改内容」真正指向的东西。
当生成模型越来越擅长创造变化,视频生产接下来要解决的,或许正是如何守住那些不该变化的东西。
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com