研究定位LLM中的稀疏奖励神经元,并用于置信度估计和推理步骤选择。
冷月清谈:
怜星夜思:
2、置零1%的价值神经元就让准确率大幅下降,能否证明奖励功能真的集中在这些神经元里?
3、价值神经元能否真正用于线上模型的置信度评估,减少幻觉或错误回答?
4、如果模型内部已经存在奖励信号,未来还需要单独训练外部奖励模型或流程奖励模型吗?
原文标题:清华与斯坦福团队在LLM内部发现两种神经元,定位奖励子系统
原文作者:数据派THU
原文内容
来源:ScienceAI本文约2000字,建议阅读5分钟斯坦福与清华大学在一项研究中出了一种更细的观察方式。
大型语言模型的隐藏状态里,早已被发现包含一些与答案正确性、模型置信度和奖励相关的信息。但此前的研究通常直接对完整隐藏状态训练一个探测器,只能说明这些信息「能够被读出来」,却很难进一步回答究竟是模型中的哪些神经元在编码这些信号?
斯坦福与清华大学在一项研究中出了一种更细的观察方式。他们发现,与奖励相关的信息并没有平均分散在整个隐藏状态中,而是集中在一小部分神经元里,并将其称为 reward subsystem,即奖励子系统。
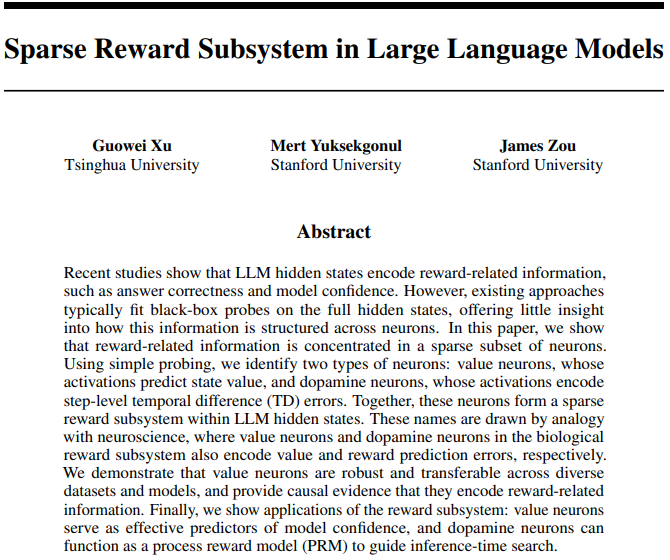
论文链接:https://arxiv.org/abs/2602.00986
模型中的神经元
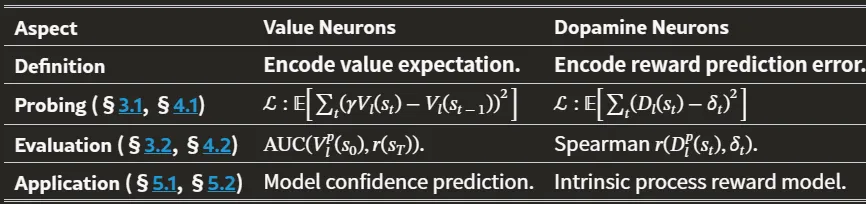
论文最终找到的两类神经元,分别对应状态价值和逐步奖励预测误差。
第一类是 value neurons(价值神经元)。它们编码当前状态的预期价值,也就是从当前推理状态继续生成下去,最终得到正确答案的概率。
第二类被称为 dopamine neurons(多巴胺神经元)。它们编码的是逐步的时分误差(TD error),反映某一步推理之后,模型预期获得正确答案的概率发生了多大变化。
表 1:奖励子系统的概述。
价值神经元
想要找到这些神经元,研究团队首先训练一个简单的价值探针,从模型隐藏状态预测当前状态的价值。随后,他们逐渐剪掉探测器输入中的神经元,只保留最重要的部分。
结果显示,即使只留下不到 1% 的神经元,模型依然可以较好地预测状态价值。这个现象不仅出现在 Qwen-2.5-14B 模型和 GSM8K、MATH500 任务中,研究人员还在 ARC、MBPP+ 和 IFEval 等不同任务,以及 Qwen、Phi 和 Llama 等不同模型中观察到了类似的稀疏价值神经元。
他们随后对这些神经元进行直接干预,在 Qwen-2.5-7B-SimpleRL-Zoo 上,原始 MATH500 准确率为 75.2%。研究人员只将某一层中排名最高的 1% 价值神经元置零,平均准确率下降到 20.3%;而随机置零同样比例的神经元时,准确率基本保持不变。
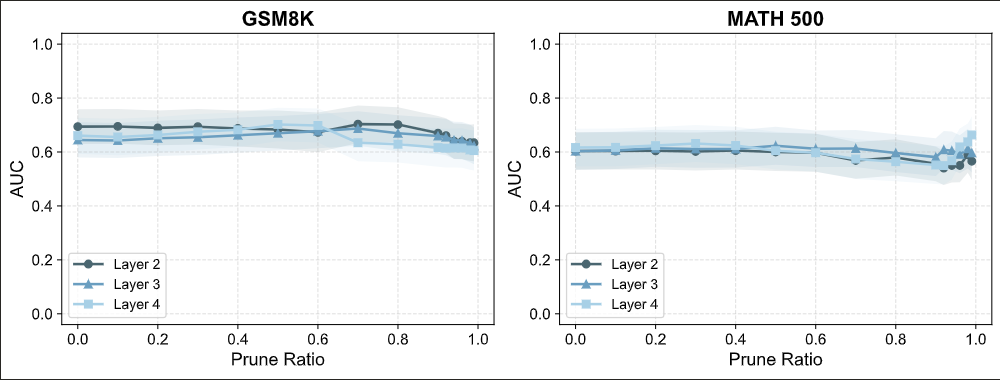
图 1:GSM8K 和 MATH500 数据集上 Qwen-2.5-14B-SimpleRL-Zoo 模型第 2–4 层的 AUC 曲线。
不同于一般意义上的「重要神经元」,这些价值神经元被破坏后出现的巨大性能下降,为它们确实承担奖励相关功能提供了因果证据。
多巴胺神经元
价值神经元关注的是当前状态最终能否成功,多巴胺神经元关注的则是刚刚发生的这一步,让成功概率发生了什么变化。
研究人员按照推理段落计算 TD 误差。当某一步让模型最终答对的可能性高于此前预期时,误差为正;如果某一步让情况变差,则为负。对应的神经元也呈现出明显的峰值和低谷。
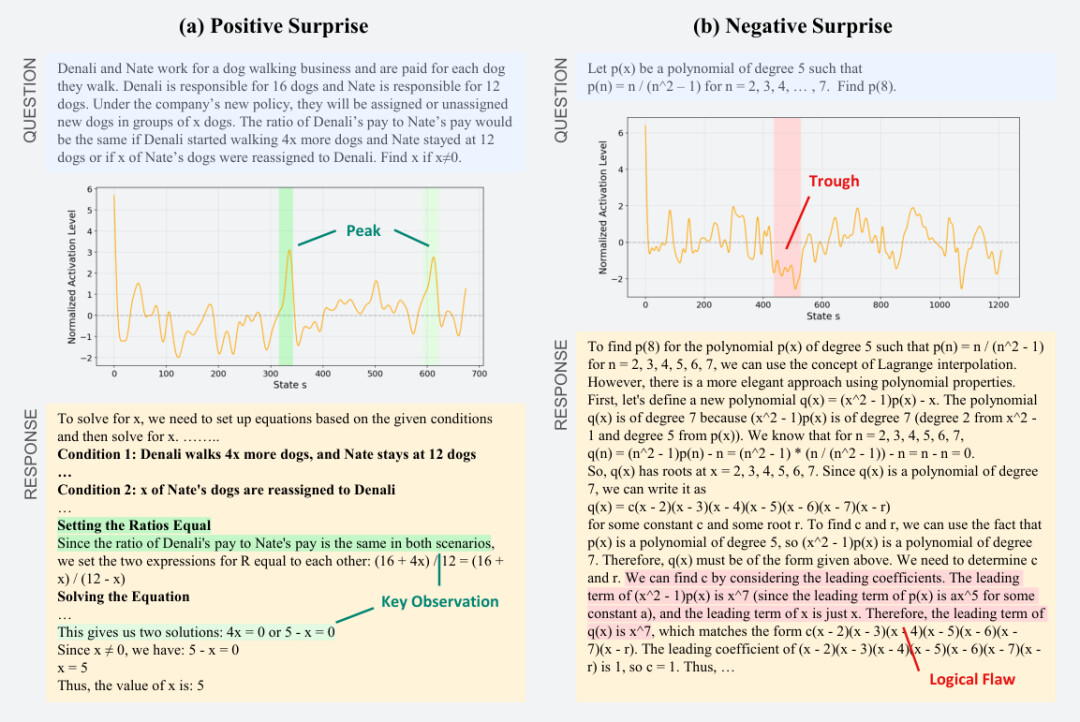
图 2:多巴胺神经元编码模型当前状态预测误差的信息。
论文展示的一个例子中,模型原本并没有太大把握,但随后找到了关键逻辑步骤并最终解题成功,多巴胺神经元在这些关键节点出现明显峰值。反过来,当模型原本信心较高,却在中途出现逻辑错误时,相应神经元会在错误出现的位置形成低谷。
类似的剪枝实验表明,TD 误差信息同样集中在一小部分神经元中。
神经元的应用
这套奖励子系统还有一个实际用途。
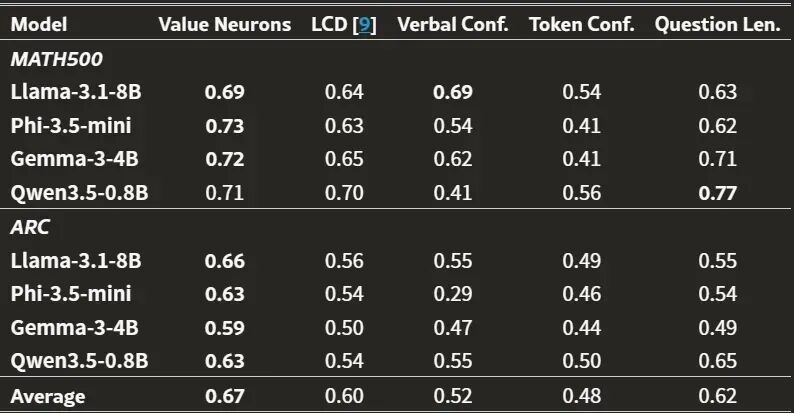
价值神经元在模型开始生成答案之前,就已经能够从初始隐藏状态中提供一定的价值信息。因此,它们可以被用作一种轻量级的模型置信度估计器。在 MATH500 和 ARC 两个任务上,价值神经元方法平均 AUC 达到 0.67,高于论文比较的完整隐藏状态探测器等方法。
表 2:不同模型和基准对不同置信预测方法的 AUC 比较。
多巴胺神经元则可以进一步充当流程奖励模型(PRM)。研究人员让模型每次产生 4 个候选推理步骤,再根据多巴胺神经元预测的奖励变化为它们评分,选择得分最高的一项继续推理。在 MATH500 上,这种方法的准确率达到 77.8%,高于贪心解码和随机选择的 72.2%,也高于论文中的隐式 PRM 方法 75.0%。
这项研究因此把一个比较模糊的问题进一步具体化:大模型内部确实存在与奖励相关的稀疏结构,而且至少有一部分可以被定位、干预和利用。对于理解 LLM 推理而言,研究者开始走出模型黑箱,观察这些信息究竟集中在哪里,以及这些神经元如何参与模型对自身推理过程的评价。
编辑:文婧