Mira-Scene以像素对齐的稠密对应提升单图3D场景重建与编辑能力。
冷月清谈:
怜星夜思:
2、用大量物体级数据预训练、少量场景数据微调,真的能减少对昂贵场景级3D数据的依赖吗?
3、3D IoU和投影2D IoU提升明显,但这两个指标足以说明场景能用于机器人操作和物理仿真吗?
4、如果要把Mira-Scene真正接入Blender、游戏引擎或具身智能系统,最需要补齐的环节是什么?
原文标题:GPT6-Astra搭的3D场景总和原图对不齐?Mira-Scene来解决!
原文作者:机器之心
原文内容
本文的主要作者包括香港大学博士生孙阳天,刘天嘉和 VAST 黄泽桓;通讯作者为 VAST 首席科学家曹炎培和香港大学副教授齐晓娟。
现在的大模型如 GPT-6 Astra,已经越来越会 “搭 3D 场景” 了。但真正把结果拿来用时,却发现前景物体的几何形状、相对尺度与 layout 仍与输入图像存在偏差。香港大学和 VAST 推出了 Mira-Scene: 通过 pixel-aligned 的 layout 表示,保证重建出的 3D 场景和原图严格一致。
从左至右,分别为 Condition 图像、Mira-Scene + GPT-6 Astra 和 GPT-6 Astra From Scratch。
近来,单图 3D 生成模型在 object-level generation 上取得了令人瞩目的进展。给定一张物体图片,生成模型如 Tripo 已经能够恢复出相当精细的三维几何。然而,当问题从 “生成一个物体” 进一步扩展到 “重建整个场景” 时,需要解决一个新的难题:物体生成出来以后,到底应该放在哪里?
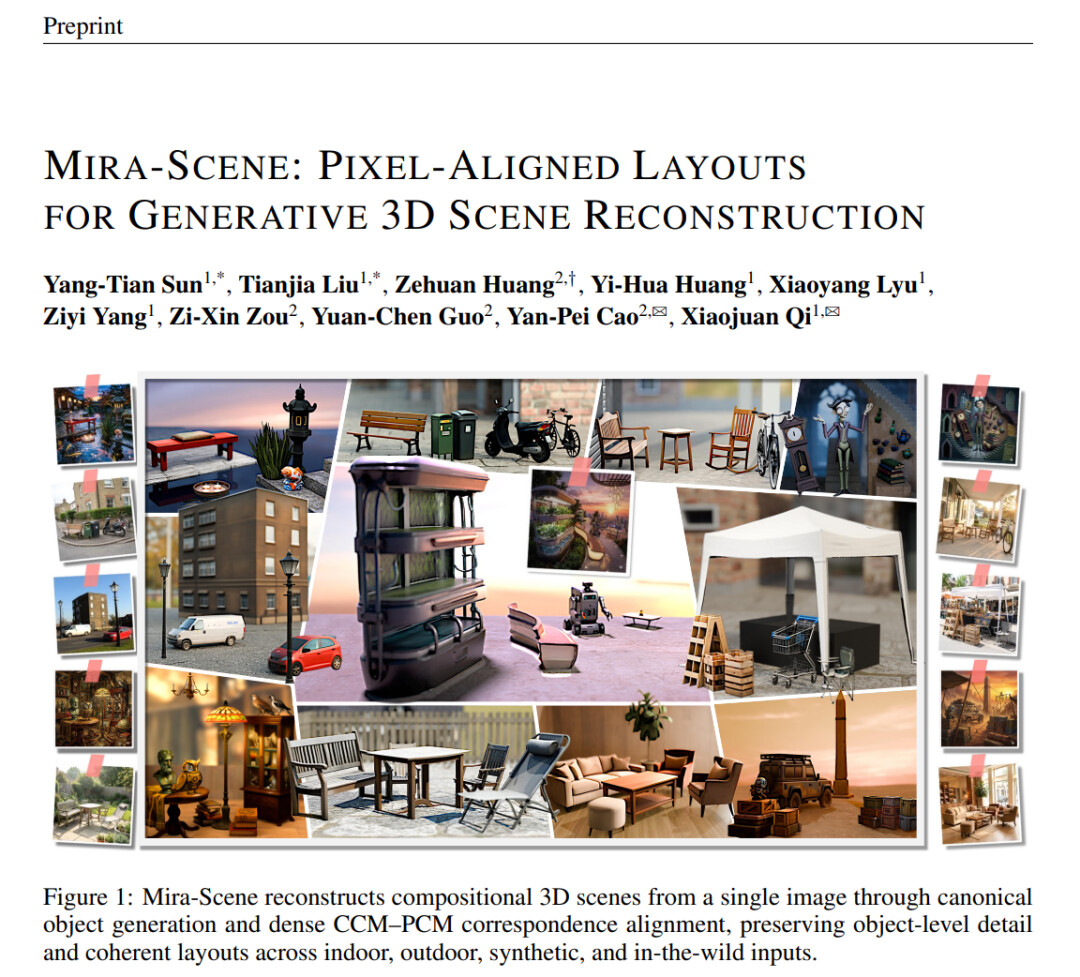
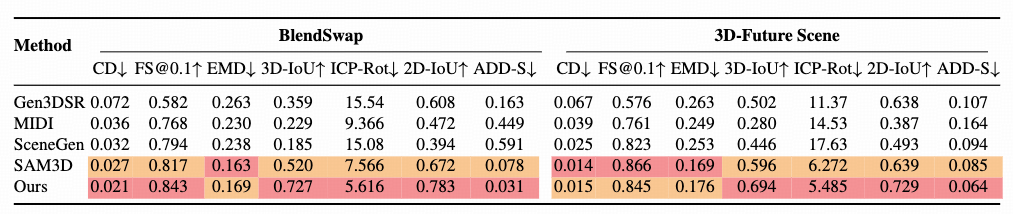
针对这一问题,论文 Mira-Scene: Pixel-Aligned Layouts for Generative 3D Scene Reconstruction 提出了一种新的生成式 3D 场景重建框架。它不再直接回归物体的旋转、平移和尺度,而是将场景布局转化为一个稠密、像素对齐的 3D 对应关系恢复问题。仅仅使用 80k 开源数据,Mira-Scene 相比 SAM3D 取得了 39.8% 的 3D IoU 精度提升和 16.5% 的投影 2D IoU 提升。
-
论文:https://arxiv.org/abs/2609.23796
-
项目主页:https://vast-eden.ai/?p=mira-scene
-
代码:https://github.com/VAST-AI-Research/Mira-Scene
全新的 Layout 表示
Mira-Scene 的核心思想在于提出一种更加易于学习和泛化的 layout 表示。
之前常见的做法,是让神经网络直接预测 translation + rotation + scale. 尽管看起来非常简洁,这种表示实际上有两个问题:1) sparse 以及 unbounded. 一个物体所有复杂的空间信息,最后都被压缩成少数几个 pose 参数;同时 translation 等参数又直接定义在开放的 scene coordinate system 中,数值变化范围很大。在遮挡、透视歧义和复杂空间关系存在时,让网络直接从一张图片准确回归这些全局参数并不容易. 2) 这类表示非常依赖带有精确 Layout annotation 的 scene-level 3D data, 而现实中高质量 3D scene 数据远远没有 object-level 3D asset 那么充足。
Mira-Scene 则将 object 在 3D 空间中的 layout 通过 Canonical Coordinate Map (CCM) 和 Point Cloud Map (PCM) 进行表示,如下图 (a) 所示:
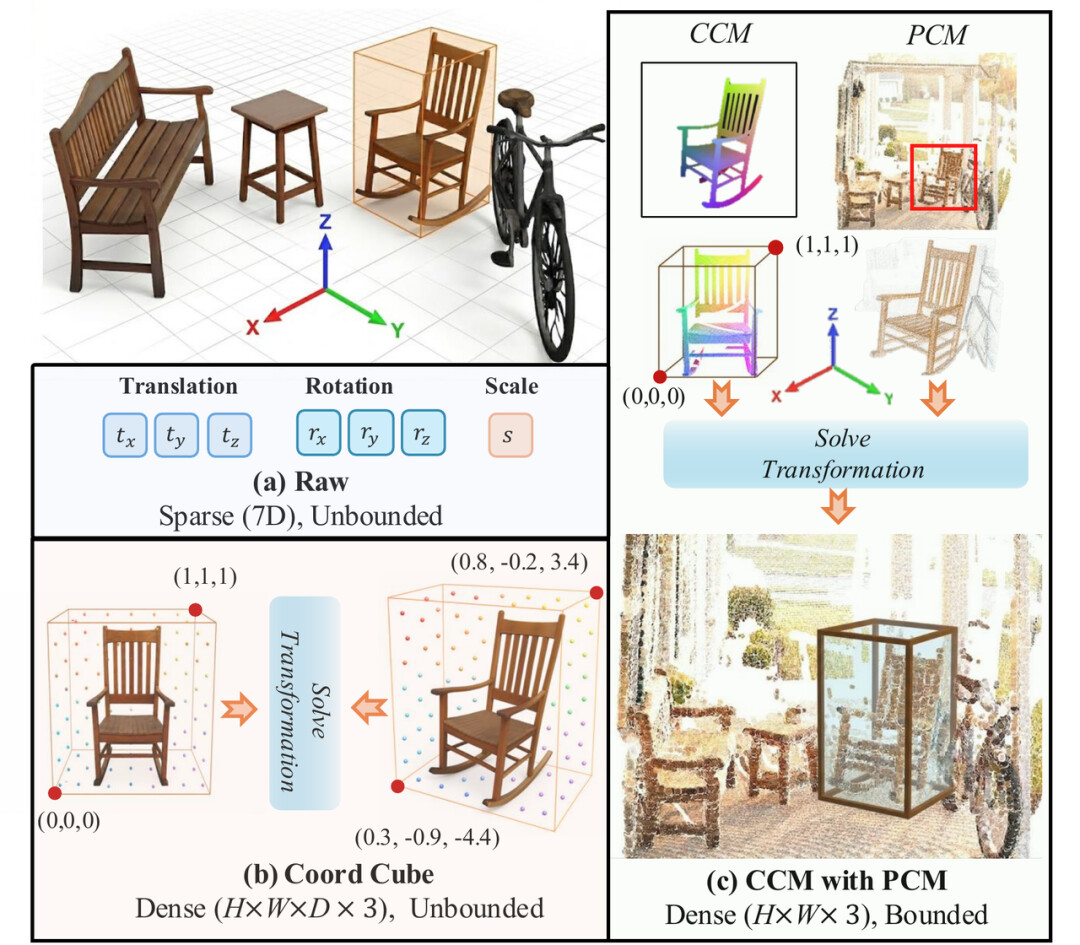
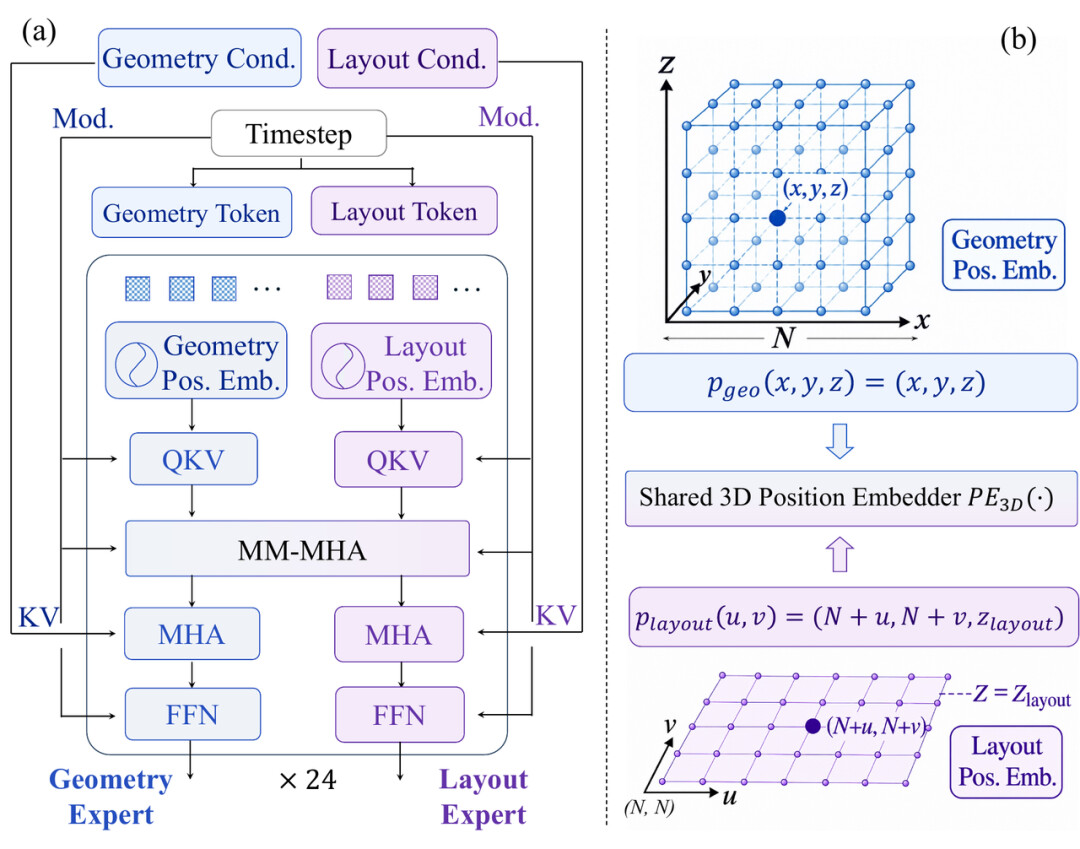
上图左:(a) 不同 Layout 表示对比;右:(b) Geometry&Layout Expert 结构
其中,CCM 记录每个像素对应椅子 canonical 3D model 上的 (x,y,z) 坐标,而 PCM 则给出该像素在当前 camera/scene coordinate system 中对应的 3D 坐标,二者天然形成了稠密的 3D-3D correspondence. 有了这样的对应关系,便可以通过 RANSAC + Umeyama alignment 得到最终 transformation,再将生成的 canonical geometry 放回整个场景。这使得一个原本困难的 sparse pose regression 问题,被转换成了一个具有大量几何约束的 over-determined alignment problem。
Geometry & Layout 联合生成
为了保证生成的 3D 形状和 CCM 能够更好地对齐,Mira-Scene 进一步提出了一个 Geometry-Layout Co-Generation 框架。 如上图 (b) 所示,Geometry Expert 负责在 3D voxel latent space 中生成物体几何,Layout Expert 负责在 2D pixel space 中生成 CCM. 两种模态分别保留自己的网络参数和表示形式,通过 shared multimodal self-attention 进行信息交互。同时 Mira-Scene 还为 geometry token 和 layout token 构造了一个 shared 3D positional space,进一步增强两种模态之间的对应关系。整体的训练流程如下图 (c):
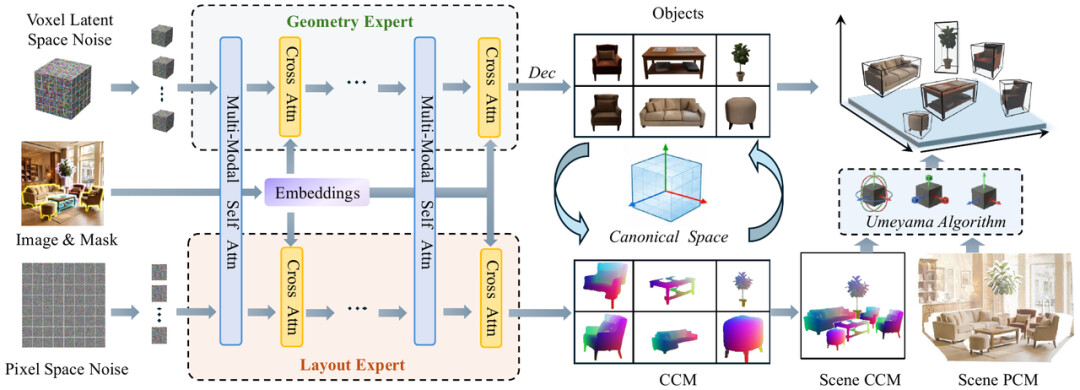
(c) Mira-Scene Training Pipeline
两阶段训练范式
由于定义在标准化 canonical object space 中,CCM 带来的另一个优势是,模型的训练并不要求必须拥有大量带精确 Layout 标注的完整 3D scene,普通 object-level 3D asset 就可以产生 CCM supervision. 因此,论文采用了一个两阶段训练方案:第一阶段是 Object-level Pre-training, 作者使用 60K 个 3D objects 渲染出 100 万个 object-centric views, 让模型首先学习 object geometry 和 CCM 的联合生成。第二阶段进入 Scene-level Fine-tuning,利用利用约 20K 个 3D-FRONT scene views 让模型进一步适应真实场景里的遮挡、透视变化,以及 amodal object reconstruction. 训练策略可以总结为,大量 object-level data 学 “geometry + ccm 一致性”,少量 scene-level data 学 “真实场景中的遮挡和上下文”,如下图 (d):
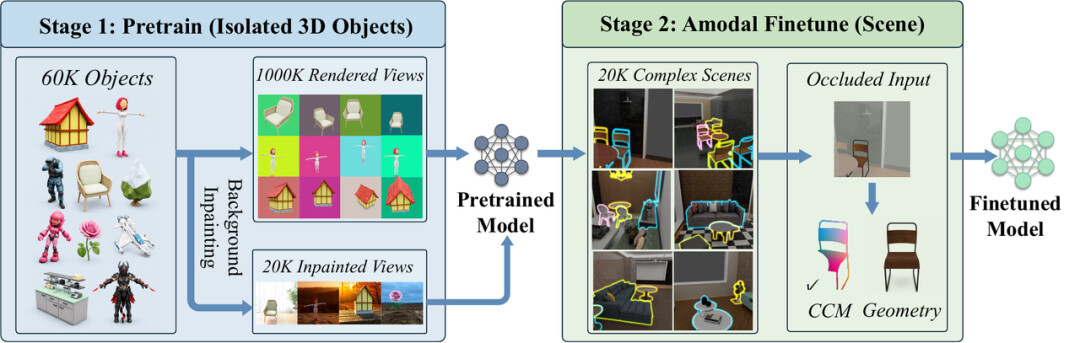
(d) 2-Stage Training Paradigm
场景重建结果
Mira-Scene 能够从单张图出发,生成 3D 物体并还原对应的场景布局,效果如下:
得益于 Mira-Scene 的 CCM- PCM layout 表示,生成的 3D 场景可以直接和单张图片的点云估计结果对齐,效果如下:
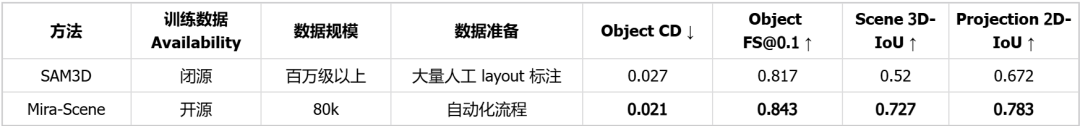
与现有方法相比,Mira-Scene 展现出了显著的优势。在 BlendSwap 和 3D-Front benchmark 上都取得了大幅的提升:
下面展示了与 SOTA 方法对比的可视化结果:
应用:从场景重建到编辑与交互
作为一个组合式场景生成方法,Mira-Scene 的结果可以直接用于物体级编辑、动画与仿真。比如移除物体、调整物体位姿或重新组合场景资产,并将资产接入后续绑定与动画制作流程。下面的结果展示了在 blender 中进行场景编辑,机械臂抓取,重力模拟和碰撞的效果:
此外,Mira-Scene 的结果还可以直接用于具身交互。下面展示了 Robot 使用 GPT6 产生的 action policy,在 Mira-Scene 的场景下进行仿真交互的结果:
除了Mira-Scene的训练/推理,该代码库还包含了一套从单张图恢复完整3D场景的pipeline, 支持全流程自动化运行,欢迎关注试用:

展望
Mira-Scene 希望不仅提供一个更准确的 3D 场景重建方法,也进一步推动社区从一种更加 scalable 的视角重新思考 compositional scene generation: 相比单纯依赖不断扩大的场景级数据,通过合理的表示设计,规模更丰富的 object-level 3D 也可以有效提升场景重建质量。为促进后续研究,团队已经开源完整代码、预训练模型权重以及训练数据样例和评测 benchmark,希望为 3D 场景重建、可编辑 3D 内容生成以及具身智能等方向提供一个开放、可复现的研究基础,并与社区共同探索更加通用、可扩展的 3D 场景生成范式。
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com