用三种注意力热力图追踪词语、图像区域与内部结构的关联。
冷月清谈:
怜星夜思:
2、把不同层、注意力头和去噪步骤直接平均,会不会把重要信息冲淡?
3、这些热力图能怎样反过来改进Prompt或模型,而不只是做展示?
4、如果把注意力可视化放进线上文生图产品,成本和体验上会遇到什么问题?
原文标题:扩散模型的注意力热力图:从生成黑箱走向可解释性
原文作者:数据派THU
原文内容
来源:DeepHub IMBA本文约2500字,建议阅读5分钟本文讨论模型可解释性(model interpretability),也就是解释训练好的网络为何产生当前输出。
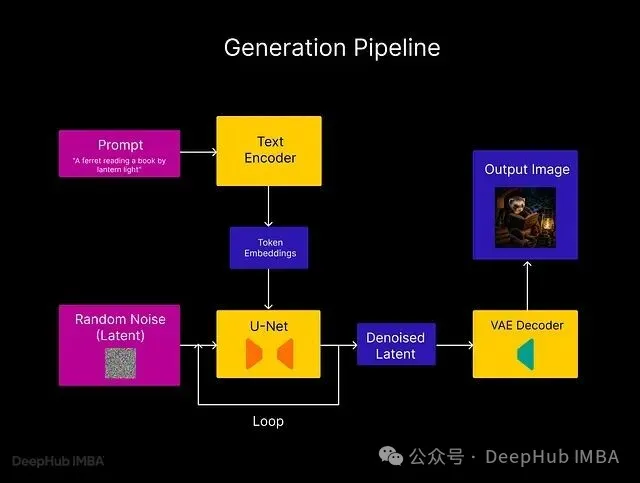
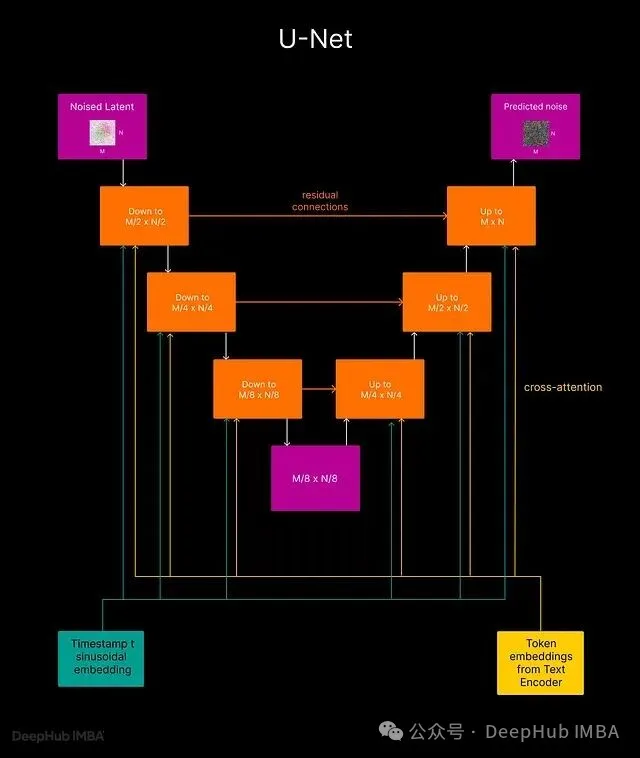
文生图扩散模型(text-to-image diffusion model)一般都包含三个工作组件:CLIP 文本编码器(text encoder)负责把 Prompt 转成 Token Embedding;U-Net 逐步对潜在图像去噪;VAE 将最终的潜在表示解码为像素。
本文讨论模型可解释性(model interpretability),也就是解释训练好的网络为何产生当前输出。在实际工作中,它可以帮助定位属性绑定错误和对象缺失等 Prompt 问题,也能揭示模型重点关注的内容,让隐藏其中的偏差浮现出来。注意力正好特别适合承担这些任务:大多数隐藏激活难以直接理解,注意力本身却是一张经过归一化、可供人阅读的“什么关注了什么”关系图,几乎不增加成本便能看到 Transformer 推理过程的少数线索。
下面基于同一份注意力数据构建文到图(text-to-image)、图到文(image-to-text)和图到图(image-to-image)三个互补视图,给出每种分数的计算方法,并介绍支持交互查看的 Web 服务。
计算聚合分数矩阵
计算从注意力概率张量开始。每个注意力层中的 U-Net 都会构造查询 Q、键 K 和值 V,计算过程为:
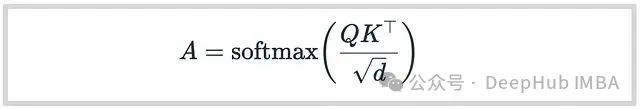
其中d 是每个注意力头的维度,softmax 沿键轴计算。
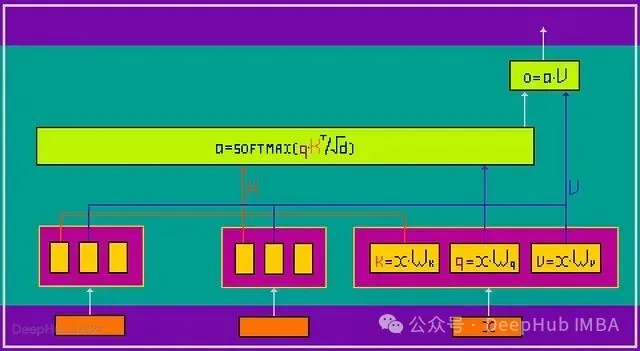
注意力有两种形式。自注意力(self-attention)的查询和键都来自图像潜在表示,A 把每个 Patch 映射成它在其他 Patch 上的分布,结果是 P×P 矩阵。
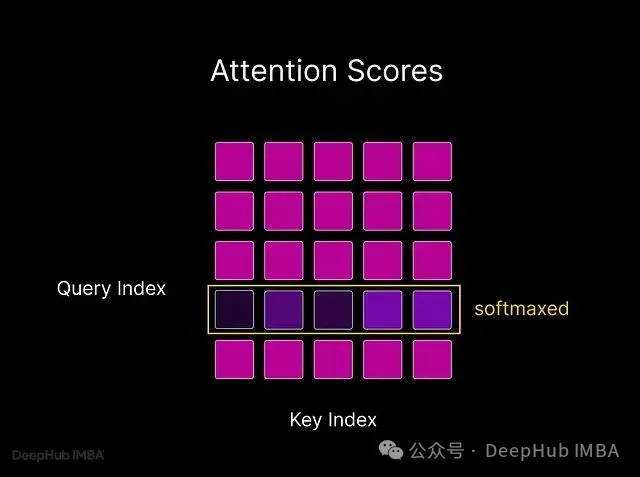
交叉注意力(cross-attention)则使用来自图像潜在表示的查询,以及来自 CLIP 文本 Token 的键。A 把 P 个图像 Patch 分别映射成其在 T 个 Token 上的分布,得到 P×T 矩阵。
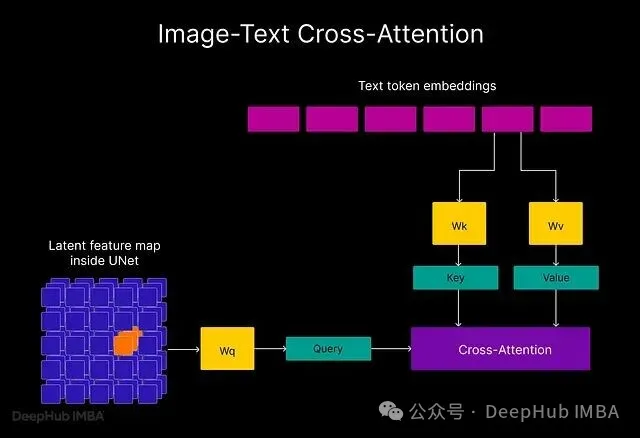
现代版本的 diffusers 在融合内核中计算 softmax并不暴露 A。处理时需要用经典方式重新计算注意力,留下相应矩阵;softmax 前的 logit S = QKᵀ/√d 也要保存,它记录的是 softmax 之前的原始分数。
单个步骤中单层的结果噪声较多,需要取平均值。U-Net 内部以多种特征图分辨率计算注意力,只有尺寸一致的图可以放在一起求平均。
聚合按分辨率 r 分别进行,平均范围包括注意力头 H、步骤 𝒯,以及该分辨率下的层 Lᵣ:
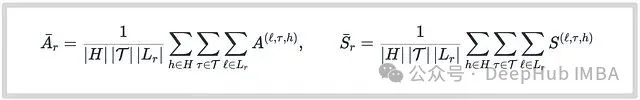
交叉注意力中,Āᵣ(以及 S̄ᵣ)的形状为 r²×T;自注意力中则为 r²×r²。不同分辨率不会合并,使用时选定一个 r,在对应分辨率下处理。
方法 1:图到文
固定图像 Patch p₀,再沿 Āᵣ 的一行读取数据,可以得到该位置在文本 Token 上的分布:
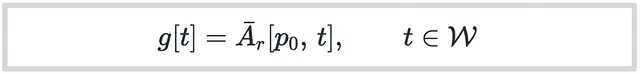
这里只保留真正的单词 Token。
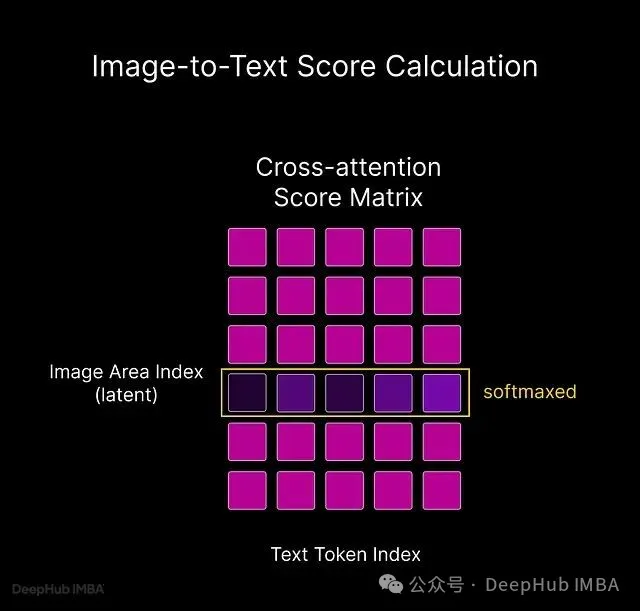
随后在这些单词 Token 之间归一化,并按权重给每个 Token 标签着色。呈现出的结果回答了一个问题:模型渲染当前 Patch 时参考了哪些单词?
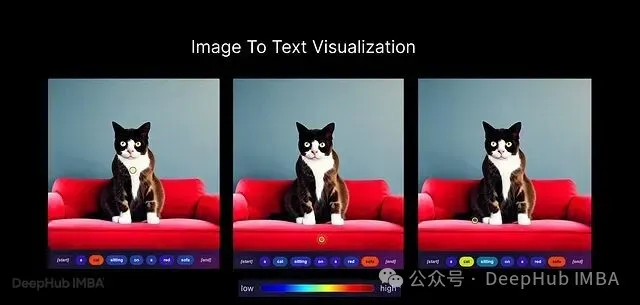
左:点击猫的胸部,“cat”是热度最高的标签。中:点击沙发坐垫中央,“sofa”变成热度最高的标签。右:点击猫的下半身与沙发边缘附近,即使落点在坐垫上,“cat”和“sitting”仍有较高热度。
以 Prompt “A cat sitting on a red sofa”为例。图中的圆圈标出选定区域,Token 的颜色表示它对该区域的影响强度,属性影响清晰可见。
方法 2:文到图
换一个方向读取数据。固定 Token t₀,沿它所在的列扫描全部图像 Patch,相当于对方法 1 做转置。此处读取 softmax 前的图 S̄ᵣ,而非 Āᵣ。softmax 会针对每个查询 Patch 归一化;固定 Token 后,原始 logit 更适合比较不同 Patch。
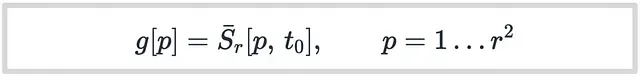
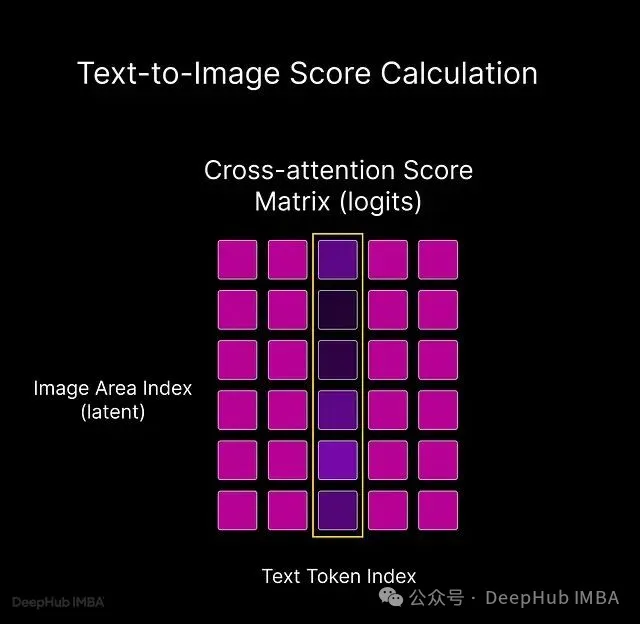
所得切片为每个潜在单元保留一个值,可以重塑为 r×r 网格。经过最小—最大归一化映射到 [0, 1] 后,再用双线性插值上采样至图像尺寸,最终以热力图形式混合到图片上,具体绘制过程将在三个方法之后说明。人们熟悉的“单词 cat 点亮猫”热力图就此产生。Token 的注意力确实集中在局部空间,所以结果很容易解读。
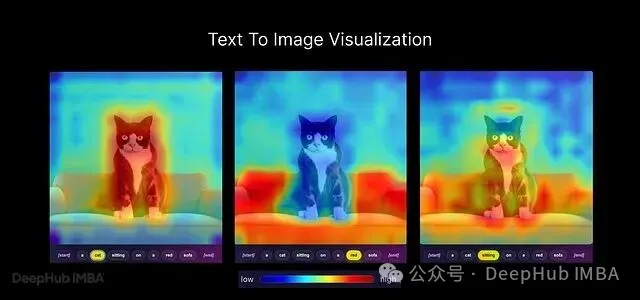
左:Token “cat”,热度集中在猫的身体和轮廓。中:Token “red”,沙发区域亮起。右:Token “sitting”,热度覆盖猫及其下方的沙发表面。
方法 3:图到图
自注意力只在图像内部工作。选定查询 Patch p₀,读取自注意力图中的对应行,再把它映射回图像空间:
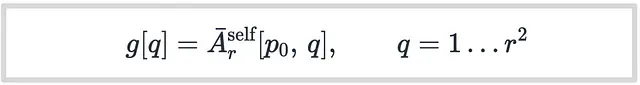
该切片仍是每个潜在单元对应一个值,空间热力图的渲染方式与方法 1 完全相同。
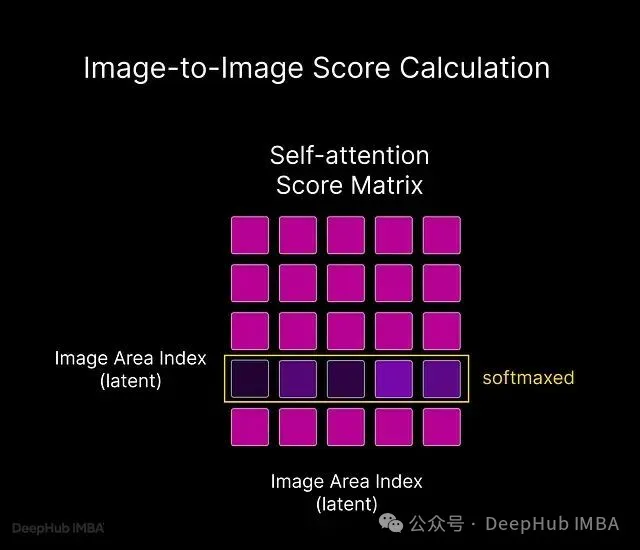
图中可以看到模型对内部结构的判断。点击一只眼睛时,另一只眼睛往往也会亮起;点选墙面,墙的其他部分会随之发亮。原因在于自注意力会把同属一个对象或同一种纹理的 Patch 归为一组。
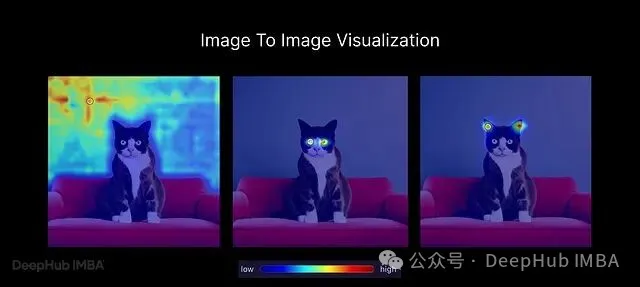
左:选中背景点,整面墙或整个背景发亮,猫和沙发保持低温。中:选中一只眼睛,两只眼睛都亮起。右:选中一只耳朵,两只耳朵都亮起。
绘制热力图
三种方法涉及的所有数值,包括分数、各分辨率的平均值 Āᵣ 和 S̄ᵣ,以及最小—最大归一化结果都在原生潜在分辨率(native latent resolution)下计算,不作任何缩放。
这套转换用于文到图和图到图两个空间视图。两者最终都会得到切片 g,每个潜在单元占一个值。按行排列到 r×r 网格后,便得到图 M。若要将 M 覆盖在完整图像上,需用双线性插值(bilinear interpolation)把它放大到图像的 N×N 尺寸。每个输出像素 (i, j) 按比例 s = N/r 映射回小网格中的 (i/s, j/s),再对周围四个单元加权混合:
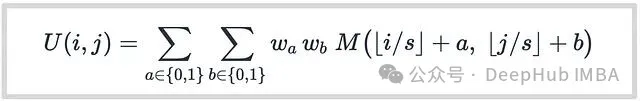
小数部分为 fᵢ = i/s − ⌊i/s⌋ 和 fⱼ = j/s − ⌊j/s⌋,对应权重为:
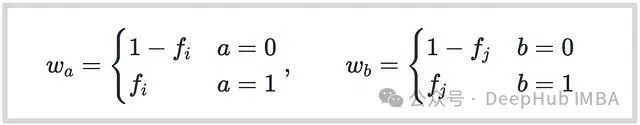
四个权重相加等于 1,每个像素都是距离最近的四个单元的凸组合,之后再用色图着色。上采样不会补充细节,只负责平滑各单元中心之间的区域。低分辨率层产生的图较为柔和,呈现块状;高分辨率层的结果更清晰,也更贴合边缘。
Web 服务
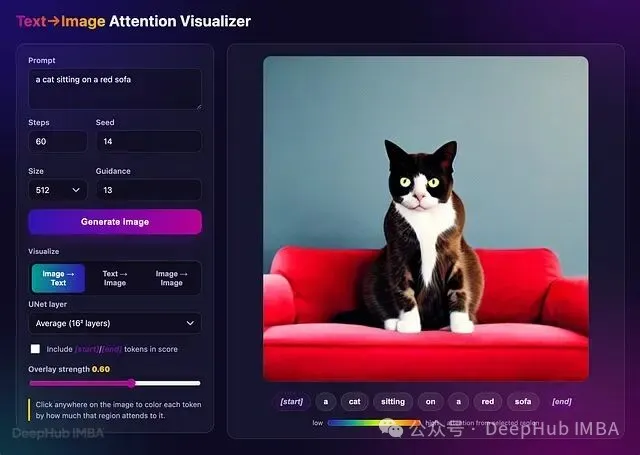
我还特意做了一个小型 Flask 应用。Image → Text 模式下,点击图片中的位置,Token 标签会按照注意力权重重新着色;Text → Image 模式下,点击 Token 标签即可显示热力图;Image → Image 模式下,点击一个位置,与之相关的区域就会亮起。
总结
让这些图变得可见,所需工作不多,换来的却是具体的诊断依据。Prompt 生成失败时,无论颜色绑定到了错误对象,还是要求的对象完全缺失,热力图都会直接指向相关 Token 或区域,把模糊的“生成错了”落实成明确的问题。图中还能看出模型依赖了哪些信息。在生成模型部署给用户以前,这类直观、可检查的证据也是建立信任的基础。
本文代码:https://github.com/Oxotall/Text2ImageAttnVisualization
编辑:文婧
