V-Rubrics用35万条原子准则细化视觉推理奖励,改善信用分配。
冷月清谈:
怜星夜思:
2、verifier训练时不看原图,只根据自包含准则判分,这种做法会不会丢掉关键视觉上下文?
3、相对答案级GRPO的部分增益只有零点几分,算上35万条准则的生成和验证成本,这套方案值不值得用?
4、把rubric奖励分配到证据句之前的回复前缀,能否真正定位错误?遇到反思、改口或跨段推理怎么办?
原文标题:答案正确,推理就可靠吗?V-Rubrics用35万条细粒度准则细化多模态强化学习奖励
原文作者:机器之心
原文内容
核心结论:V-Rubrics 将 50,248 个视觉样本拆成 352,938 条可逐项检查的准则,让图像中的事实、推理步骤和任务要求分别参与奖励计算。基于同一 SFT 起点和同一批 RL 数据,rubric GRPO 在通用与知识评测中的 Overall Avg. 达到 68.04。
多模态模型给出的推理过程即使连贯,也可能读错图表数字,或写入画面中不存在的物体。如果最后的答案恰好正确,按结果评分的训练方式就可能把这些“看似结果正确”但“实际推理错误”的情况也一并奖励。
反过来,最终答案错了,也不意味着此前的观察都错了。那些有依据的正确观察,仍然是有价值的训练信号:保留并强化这些观察,可以帮助模型在此基础上修正后续推断。但这也引出了一个关键问题:当正确的观察与错误的推断交织在同一段回答中,reward 应当如何分配,才能鼓励做对的部分,并引导模型纠正出错的环节?
来自南洋理工大学 S-Lab、A*STAR 和 UIUC 的研究团队提出了 V-Rubrics,用逐项评分(rubrics)来处理“信用分配”(credit assignment)问题。视觉事实、推理步骤和任务要求分别列为评判的准则,而这些单项的得分则会被用于后续的 GRPO 强化学习。该论文已被 EMNLP 2026 主会接收,代码与数据现已开源。
-
论文标题:V-Rubrics: Visual Faithfulness via Rubric-Based Reinforcement Learning
-
作者团队:Shulin Tian、Minglun Li、Yuhao Dong、Hao Ding、Jiarui Yao、Haiwen Diao、Jingkang Yang、Hongyuan Zhu、Ziwei Liu
-
论文地址:https://arxiv.org/abs/2608.25580v1
-
项目主页:https://shulin16.github.io/v-rubrics/
-
代码仓库:https://github.com/shulin16/v-rubrics
-
数据集:https://huggingface.co/datasets/v-rubrics/v-rubrics-50k
正确的观察与错误的推断
为什么要分别评价?
论文给出了一个直观例子。面对“图中有多少人出生于二战结束之后”的问题,答案级 GRPO 模型准确识别出 4 个人,却随后凭其中一名男子的外貌估计其年龄超过 70 岁,并据此断言他出生于 1945 年以前,最终回答 3 人。人数识别本身没有出错,问题出在后续的年龄与出生年份推断上。
如果只按最终答案计分,训练只能知道整道题没有答对,却得不到更具体的判断:识别出“4 人”是有图像依据的,后续推断则需要修正。对于图表、几何题或文档问答,这类混合情况同样常见,一处错误读数或不成立的推导,就可能改变最终结果。而 V-Rubrics 将人数识别、出生年份推断和最终作答分别列为检查项,训练时再使用这些逐项判断。
把视觉证据写进奖励
围绕一条视觉回答的形成过程,V-Rubrics 将准则分为三个维度:
-
视觉忠实性(Visual Faithfulness,VF)检查事实依据。回复中提到的物体、属性、关系、数量、可见文字和图表数值,都应能在图像中找到支持。
-
推理一致性(Reasoning Consistency,RC)检查推导是否成立。即使图像信息读取正确,后续结论也需要能够从这些事实中推出。
-
指令遵循(Instruction Following,IF)检查任务是否完成,包括回答形式、题目要求和其他明确约束。
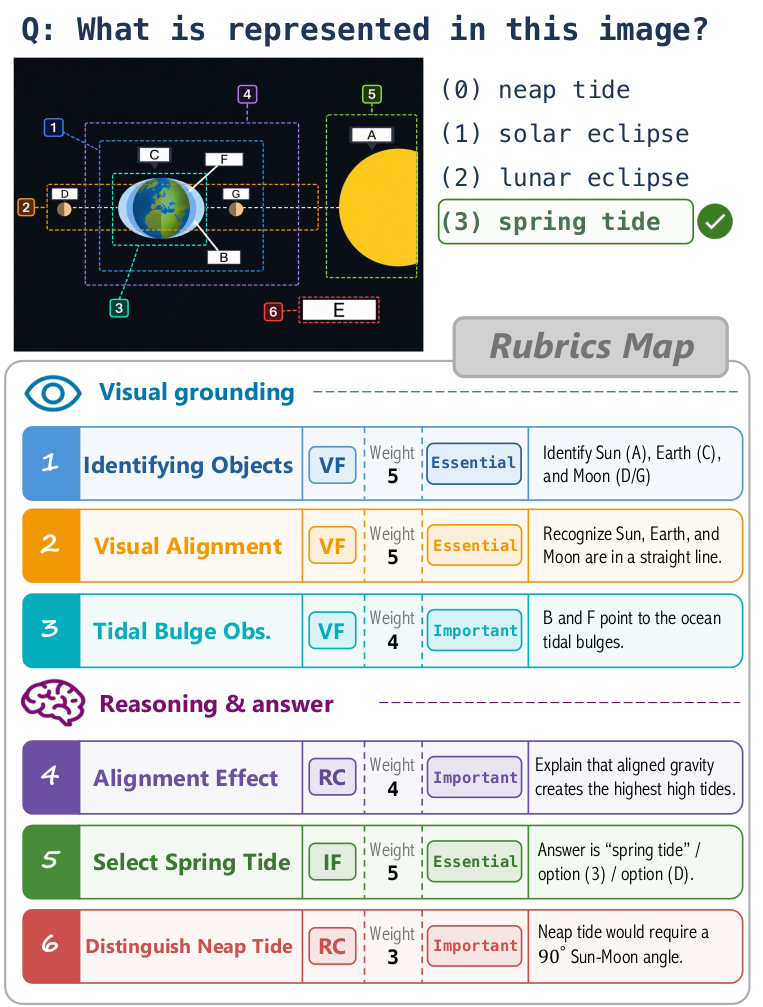
同一个视觉问题被拆成 VF、RC、IF 三类原子准则,每条准则均可独立判断并带有权重。
rubric 的设计也很重要:每条 rubric 都只检查一个原子项,同时要求表述尽量简短,单独拿出来也能看懂,并配有重要性标签和相应权重。Essential、Important、Optional 分别对应必须答到、重要但非必需,以及可作为补充的内容;Pitfall 则专门标出常见的幻觉和推理错误。这样一来,模型答对了什么、又在哪一步出了错,都可以分别计分。
怎样让自动评分有据可查?
以几何题为例,“回答应当正确”并没有给评分器提供多少额外信息;如果分别写明应读取的边长、适用的公式和目标面积,检查对象就明确了。论文要求 rubric 指向具体可见的事实,并在单条准则中写清对象和成立条件,同时覆盖关键观察与中间推理。
这些检查项也有重要程度之分。视觉问答采用 VF ≫ RC > IF 的优先级,将视觉事实放在首位,再考虑推理与指令约束;Essential、Important、Optional 的正向权重为 1 到 5,Pitfall 则标记为 -1 或 -2。
生成准则时,模型读取原图、指令和参考回答,将需要核查的事实写入 rubric;训练时,verifier 只读取生成回复与这些自包含准则(self-contained criteria),不直接读取原图。
5 万道题
如何提供 35 万条具体反馈?
V-Rubrics 50K 从 17 个公开视觉数据源中选取样本,涵盖图表与文档问答、示意图、视觉数学、计数、教育问答和通用视觉推理,并按有效性、内容质量与重复性进行了初步筛选。
为判断题目是否还有训练价值,团队让监督微调(SFT)后的模型对每个候选样本回答 8 次:全部答对的题目会被剔除,因为最终答案奖励已难以在这些回答之间提供区分;其余样本则根据答对比例划分难度。这里衡量的是模型的实际表现,难度标签用于组织固定的训练数据组合。
最终保留的 50,248 个样本中,hard 级别的问题占 36.1%,medium 占 50.4%,simple 占 13.6%。
随后,Gemini-3-Pro 按照统一的图像条件化协议(image-conditioned protocol)生成 VF、RC、IF 准则,共得到 352,938 条 rubric。其中,VF 为 209,436 条(59.3%),RC 为 101,369 条(28.7%),IF 为 42,133 条(11.9%)。接近六成准则用于检查视觉事实,使“是否准确理解图像”成为最主要的监督内容。
每个样本都包含图像、题目、参考回答和对应准则,训练时可以分别检查各项要求的满足情况。
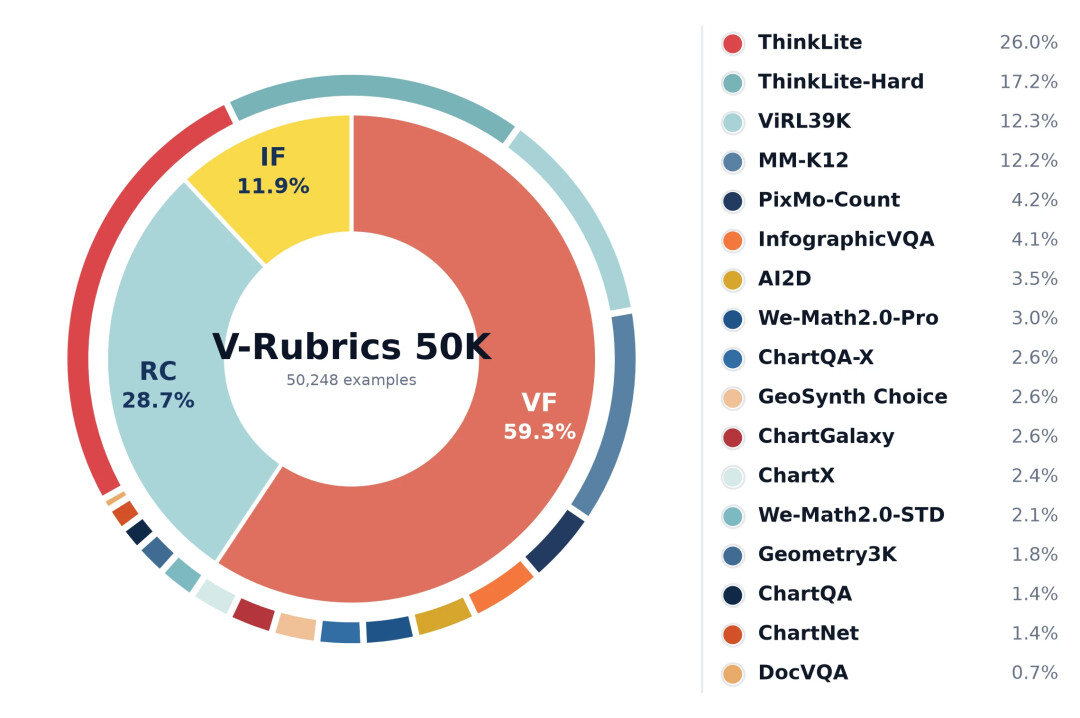
V-Rubrics 50K 的数据来源与 VF、RC、IF 准则分布
评分拆开之后
怎样进入强化学习?
逐项打分还只是第一步。如果立即把所有准则合成一个总分,再用这个分数更新整段回复,各项判断之间的区别仍会在信用分配时被压缩。为了解决这个 reward 的坍缩问题,V-Rubrics 因而同时调整了奖励内容与信用分配方式。
在主实验中,答案正确性和 rubric 满足度各以 0.5 的权重计入语义奖励,同时保留标准格式奖励。答案奖励检查任务是否完成,rubric 奖励检查回答是否满足各条准则,后者逐项给出“满足”或“不满足”的判断。
对于同一道题,系统分别比较多条生成回复的最终答案和各条 rubric 得分。例如,一组回答可能都没有得到正确结论,但只有部分回答准确读出了图表数值;逐项比较就能保留这项差异。反之,若所有可评分回答在某条准则上得分相同,这一项便不产生组相对梯度。
让训练信号与证据所在的回复前缀对应
在构造训练优势(advantage)时,答案得分与各条正向 rubric 得分分别在同一组 rollout 中标准化。最终答案的信号覆盖整段回复,而每条 rubric 保留独立的优势信号,按照对应权重参与更新。
接下来,verifier 会为每项判断返回对应的原文证据句,系统再通过模糊匹配,在生成回复中定位这些句子。每项 rubric 的 advantage 仅作用于从回复开头到对应证据句末尾的前缀,后续内容不再使用这一 advantage。若无法可靠定位证据句,则仍按 rubric 逐项计算 advantage,但将其作用范围回退到整条 response。
对于已确认触发的幻觉或推理陷阱,Pitfall 会启动语义奖励的否决机制,取消相应回复的答案信用与正向 rubric 信用。正向检查项用于提供部分得分,负面检查项则用于约束已知错误。
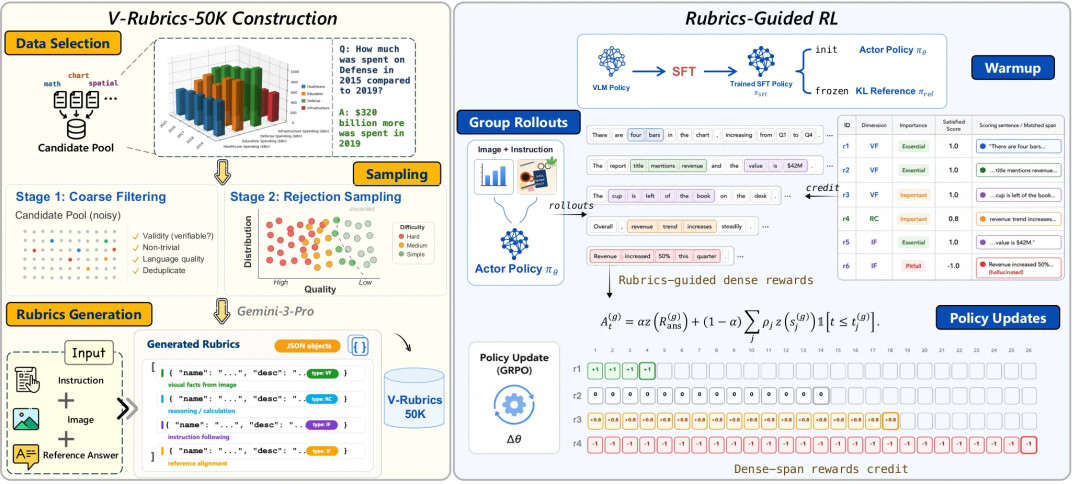
V-Rubrics 的数据构建与强化学习流程
逐项反馈
带来了哪些能力提升?
在两组主评测中,rubric GRPO 都取得了高于 SFT 和答案级 GRPO 的平均分。其中,通用与知识评测的 Overall Avg. 达到 68.04,视觉数学、图表与逻辑评测达到 62.45。
为让比较聚焦于奖励机制的差异,两种 RL 方案采用了相同的训练起点:我们先以 Qwen3-VL-8B-Instruct 作为 base model,使用 OpenMMReasoner-SFT-874K 进行监督微调,再从同一个 SFT checkpoint 出发,分别训练答案级 GRPO 和 rubric GRPO。两者均使用同一批 V-Rubrics 50K 数据,并保持相同的采样预算与优化器设置。
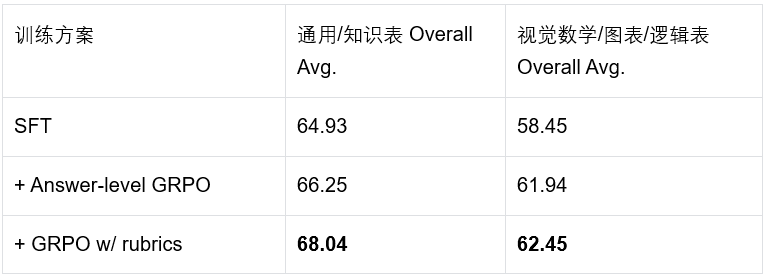
相较于 SFT,两组评测的总体表现分别提高 3.11 个百分点和 4.00 个百分点;与答案级 GRPO 相比,则进一步提高 1.79 个百分点和 0.51 个百分点。两个 Overall Avg. 按各自表中的所有评测的 benchmark 计算。
先改变“评什么”,再改变“怎样分配奖励”
消融实验进一步拆开了这两个环节。在通用与知识评测中,仅加入 rubric 评分、仍将各项得分合成序列级标量(scalar sequence-level aggregation)时,Overall Avg. 就从 66.25 升至 67.74,提高 1.49 个百分点。这一步改变的是评分内容,训练仍使用序列级奖励。
在此基础上,分别标准化各项得分,并将信号分配到对应的回复前缀,平均分进一步达到 68.04。新增的 0.30 个百分点反映了组件级标准化(component-wise standardization)与前缀定位的共同作用。
MMMU 系列:知识推理是主要增益来源
细分成绩后,通用与知识评测中的提升主要来自 MMMU 系列。这类题目需要模型将图像中的局部信息与学科知识连接起来,一次正确回答往往包含多个相互依赖的判断,也为细粒度反馈提供了明确的检查对象。
相较于答案级 GRPO,MMMU Val、MMMU-Pro 和 MMMU-Pro Vision 分别提高 2.56、2.43 和 2.60 个百分点,Knowledge Avg. 从 59.35 升至 61.88。相比之下,MMBench-Dev 保持接近的水平,得分分别为 86.94 与 86.51。
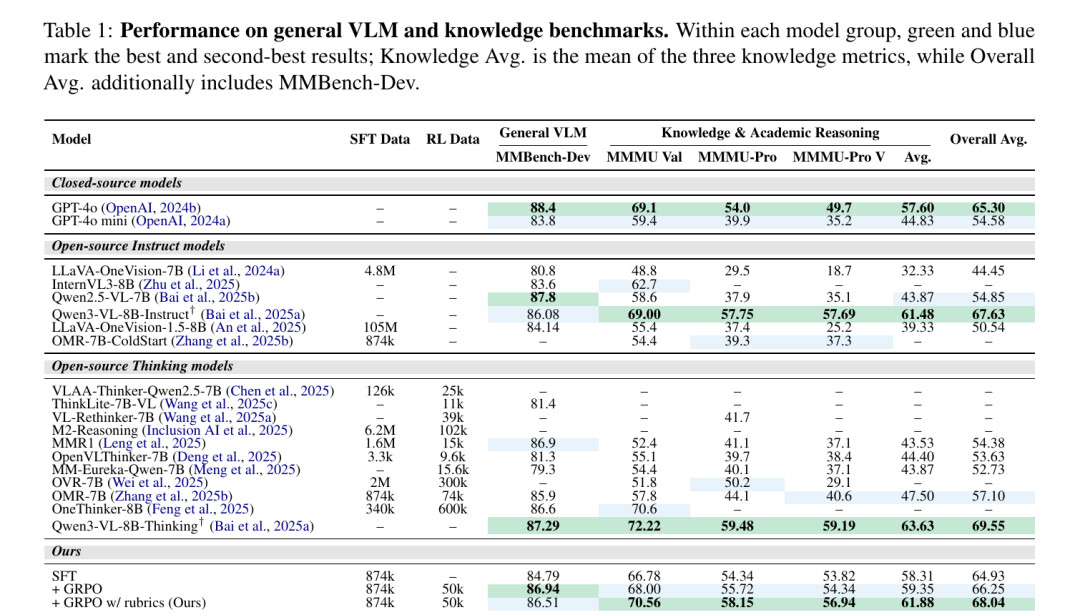
论文 Table 1:通用视觉能力与知识、学术推理基准完整结果
视觉数学、图表与逻辑:进一步提升至 62.45
视觉数学与逻辑任务中,MathVision 从 56.71 提高到 58.88,LogicVista 从 60.63 提高到 62.42;DynaMath Worst 与 WeMath Loose 也分别提高 1.20 和 1.43 个百分点。
综合各子任务,Math Avg. 从 63.19 提高到 63.63,Chart Avg. 从 58.81 提高到 59.51,Overall Avg. 则从 61.94 提高到 62.45。单项上,MathVista 小幅提升,MathVerse V/O 与 CharXiv Reasoning 有所回落,完整结果见下表。作为同表参考,Qwen3-VL-8B-Thinking 的 Overall Avg. 为 62.22。

论文 Table 2:视觉数学、图表与逻辑推理基准完整结果
回到具体回答,差异发生在哪里?
前文的人像问题中,rubric 训练后的模型补出了年龄与出生年份之间的推算;在另一道函数图像题中,答案级模型将函数值首次达到 2 的位置误读为 x = 4,而 rubric 训练后的模型重新逐段读取图像,得到 x = 2。
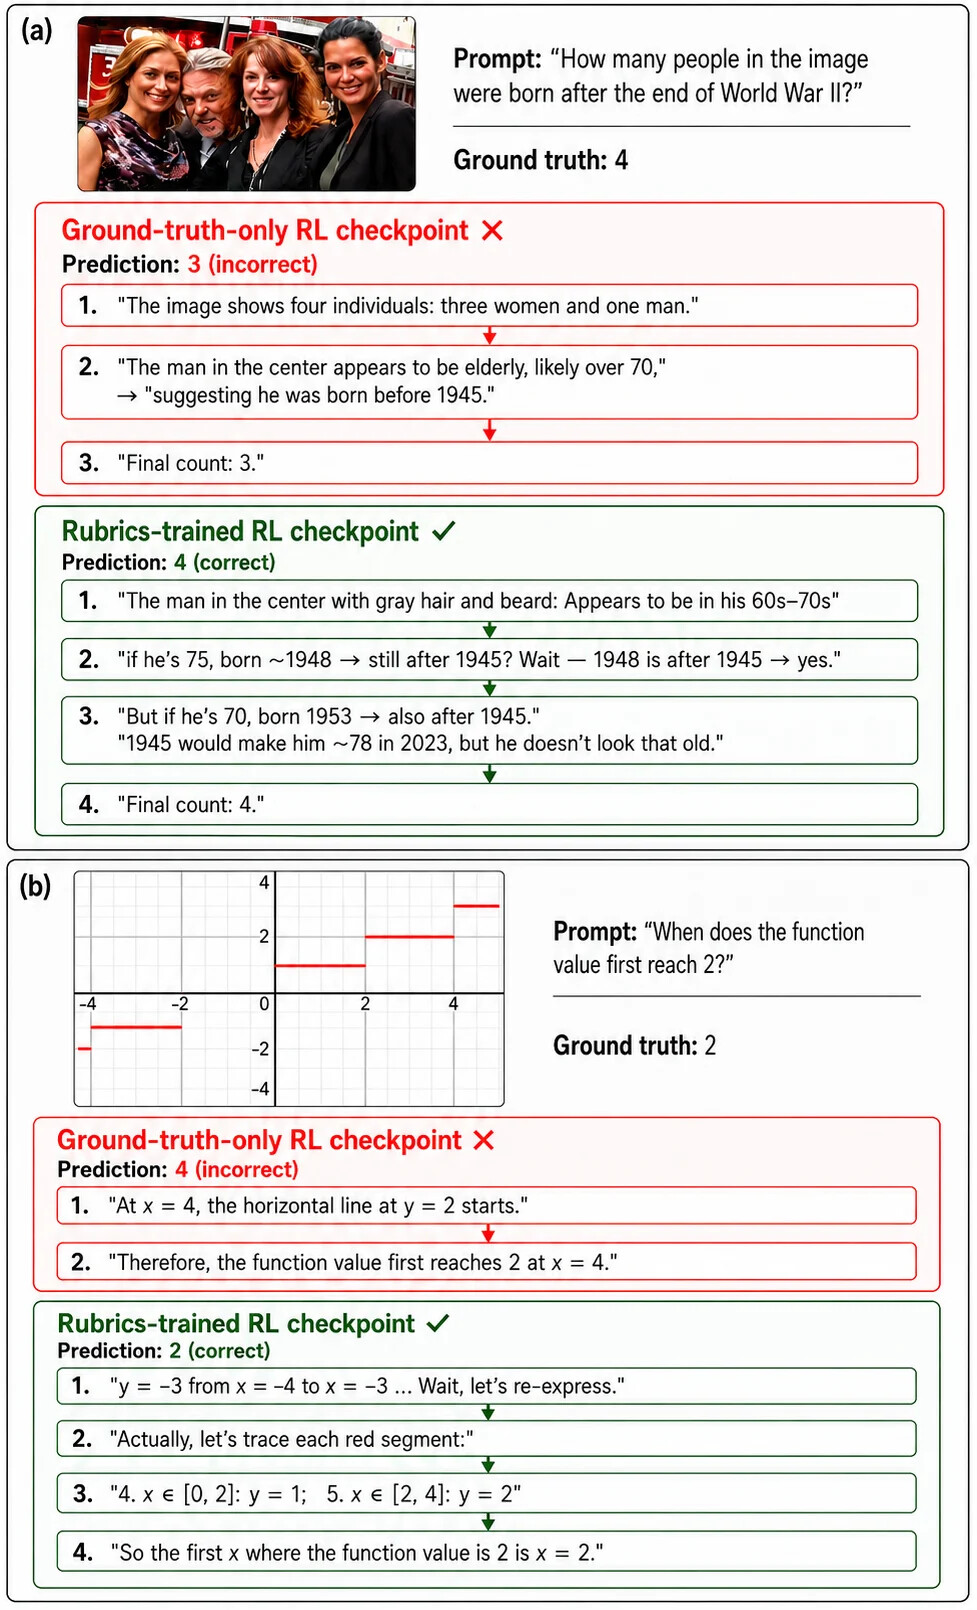
两类示例:从不受支持的年龄推断与错误图像读数中纠正中间推理
代码与训练数据均已开源,欢迎大家来一起讨论。
作者简介
田淑琳目前是南洋理工大学计算机科学博士生,导师为刘子纬教授和朱宏远博士。她的研究聚焦于多模态智能体与视觉推理,尤其关注长时程多模态理解和工具增强推理。她曾获 A*STAR 计算与信息科学奖学金支持,并获评 CVPR 2026 和 ICLR 2025 SCOPE Workshop 杰出审稿人。

© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com