通用时序模型擅长聚类和异常检测,但仍受不规则采样制约。
冷月清谈:
怜星夜思:
2、Chronos-Bolt在天文OOD检测中的优势,能否直接迁移到医疗监测或工业传感器数据?
3、把真实时间戳加入位置编码,是否就足以解决不规则时序建模问题?
4、领域专用的Astromer反而落后,这说明专用模型路线有问题,还是评测方式对它不利?
原文标题:ICML 2026 | 用时序大模型提炼天文数据中的有效信息
原文作者:数据派THU
原文内容
本文约4000字,建议阅读5分钟通用时序基础模型,到底能不能从天文时序这种"不听话"的数据里提取有效信息?
【论文标题】StarEmbed: Benchmarking Time Series Foundation Models on Astronomical Observations of Variable Stars
【论文地址】https://arxiv.org/abs/2510.06200
【论文代码】https://github.com/skai-institute/StarEmbed
【HuggingFace】https://huggingface.co/datasets/StarEmbed/ZTF_40k
为何要用天文时序测TSFM?
TSFM 语料与真实时序的"数据鸿沟"。主流 TSFM 预训练语料(如 Moirai 用的 LOTSA)几乎只包含规则采样、不含目标不确定性、少有单条多变量的序列。但以天文光变曲线为代表的真实科学数据,天然带有四类 TSFM 很少见过的特征:多变量(同一颗星在g、r等多个波段同时观测)、不规则时间采样(地面望远镜只在夜间观测,两次观测间隔从几小时到几天不等)、规则与不规则缺口(天气、观测计划造成)、异方差不确定性(不同星等、不同观测条件下的测量误差差异可达多个数量级)。
图1 本研究数据中体现的天文时间序列典型数据挑战
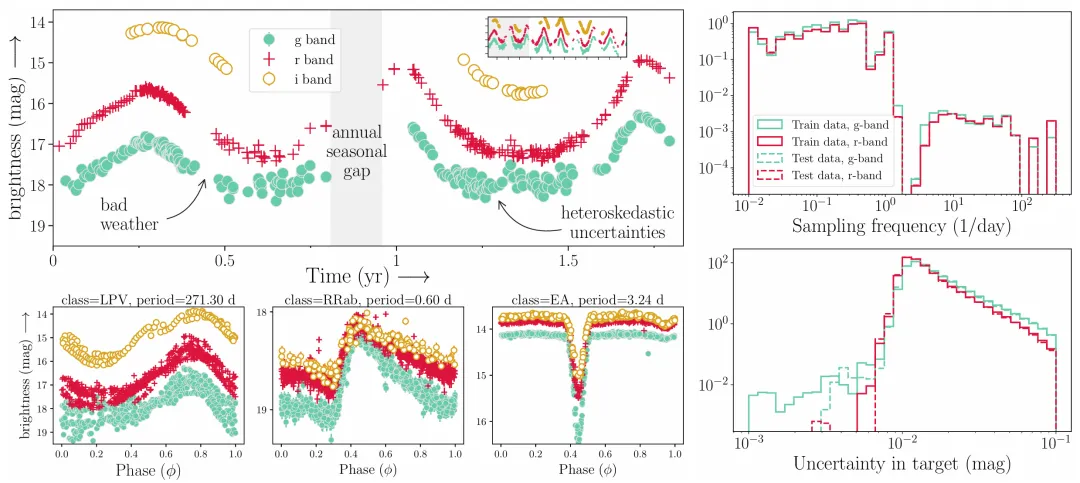
论文聚焦"周期变星",即亮度随固定周期变化的恒星。这类恒星是研究恒星内部结构、银河系结构的重要探针,而且因为它们周期性强、类别清晰,特别适合检验模型能否从数据中捕捉物理结构。
StarEmbed基准与三类评测
01 数据构成
数据取自 ZTF 第23次数据发布(DR23),覆盖约6.5年全天北天球观测。恒星类别标签来自 Catalina 勘天周期的周期变星目录(CSPVS,人工标注目录),论文为每颗星提取 ZTF 光变曲线,并做了严格清洗:剔除标记为"bad"的观测、观测总数不足32条的曲线、缺少g或r波段观测的曲线、以及样本量过少的类别。最终得到约4万条专家标注的光变曲线,覆盖7个天体物理类别:EW、EA(两类食双星)、RRab、RRc、RRd(三类天琴座RR型脉动星)、RS CVn(猎犬座RS型双星)、LPV(长周期变星)。由于天然类别不平衡,数据按类别独立抽样,以7:1:2划分训练/验证/测试集。
02 评测的模型与基线
论文评估了三个通用 TSFM 家族——Moirai(1.0/2.0)、Chronos(Bolt/2)、Time-MoE;两个领域专用 Transformer——Astromer-1/2(用天文光变曲线预训练);以及天文领域沿用多年的强基线——手工特征提取(用 FATS 和 light curve 软件包,每个波段提取69个特征,两波段共138维,包括 Lomb-Scargle 最佳周期、散布、偏度、峰度等)。作为对照,还加入了一个"随机嵌入"基线——从均匀分布随机生成256维向量,作为性能下限的参照,判断其他模型是否真的学到了有用信息。为统一比较,除 Moirai(384维)外所有模型嵌入统一为256维。
03 三类下游任务
聚类用 K-means 和 Ward 层次聚类(各生成7簇),以归一化互信息 NMI、调整兰德指数 ARI、宏平均F1衡量;分类用四种分类头(k-NN、逻辑回归、随机森林RF、MLP)评估嵌入作为特征输入的有效性;OOD 异常源检测把那些因样本过少而未能进入训练/测试的罕见恒星类别(β-Lyrae、Blazhko、天琴座RR异常型等)定义为OOD源,与测试集混合后通过"多类隔离森林"(MCIF)打分,用"Top N% 选出的源中真实 OOD 的比例"(OOD纯度)衡量。
实验结果:
TSFM 的亮点与天花板
01 聚类:Chronos与手工特征分庭抗礼
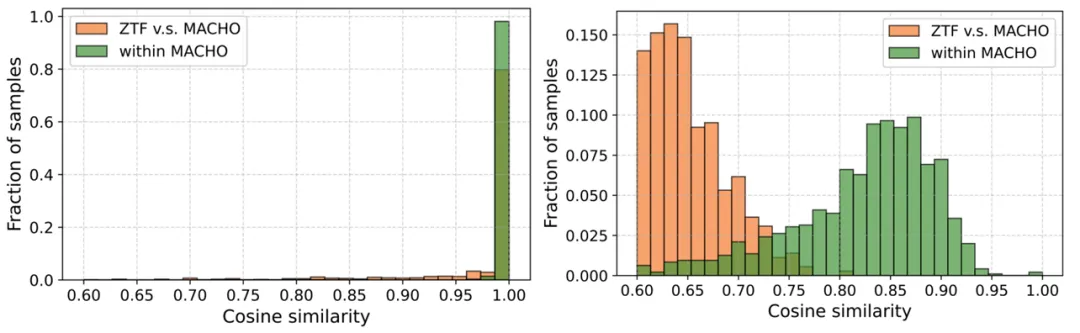
在无监督聚类上,Chronos 系列几乎包揽各指标第一或第二,且始终优于 Moirai 和领域专用的 Astromer。但两类方法的优势维度不同:手工特征在全局可分性(NMI)上最优,Chronos 则在配对一致性(ARI)上领先,说明 Chronos 的嵌入形成了小而纯的局部簇,而手工特征对应的是较粗的类别对齐。值得注意的是,领域专用模型 Astromer 反而表现最差,甚至不如从未训练过光变曲线的通用TSFM,论文分析 Astromer-1 的嵌入发生了坍缩(多个方向趋于一致)。
图2 本研究分析所涉及的各嵌入模型在测试集上的UMAP降维投影结果
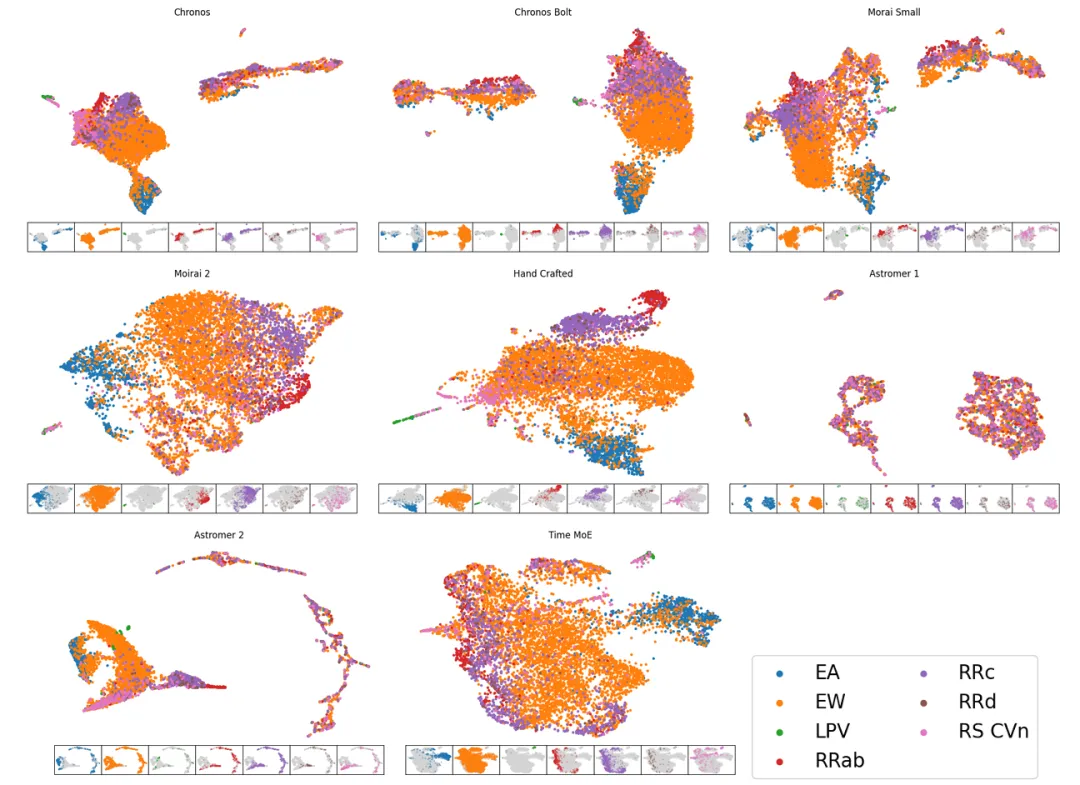
图3 Astromer-1(左)与Chronos(右)的嵌入对齐效果对比
02 分类:手工特征仍是SOTA,Chronos稳定第二
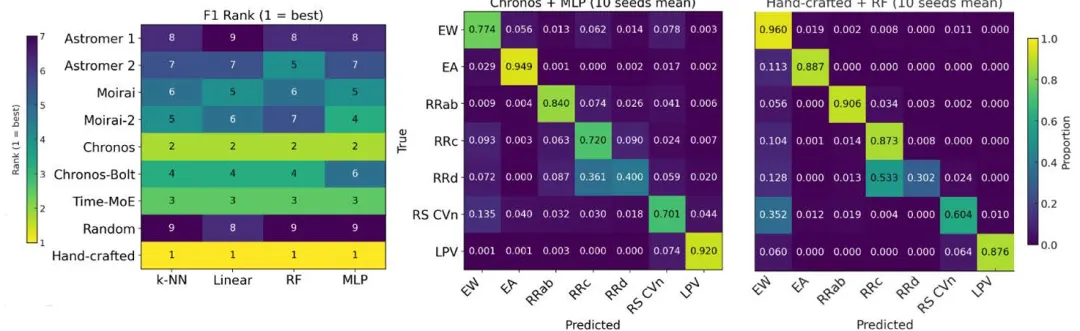
在监督分类上,没有任何 TSFM 能超越手工特征基线(随机森林下宏F1达0.804),Chronos 以第二名的成绩(k-NN下宏F1 0.672)紧随其后。论文的混淆矩阵分析显示:Chronos 在多数类别(EA、RRd、RS CVn、LPV)上优于手工特征,但在样本量最大的 EW、RRab、RRc 上输给手工特征更多,最终整体落后。这印证了 TSFM 确实能从未见的天文数据中提取出有效信息,但尚不足以取代概念上简单的领域基线。
图4 左图:不同分类器头下各基线模型的F1值排名;右图:两组方案的混淆矩阵
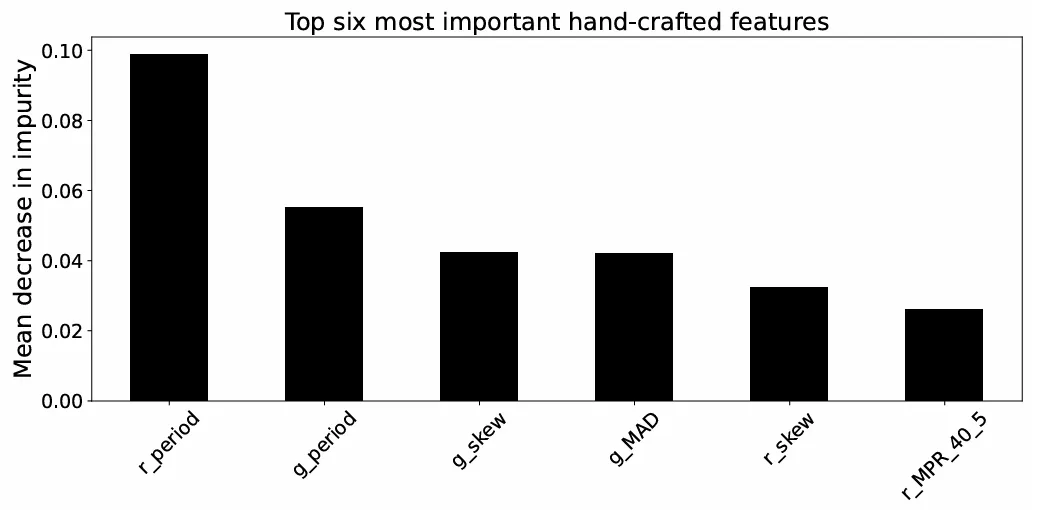
手工特征为何仍是天花板。 下图展示了随机森林分类中最重要的六个手工特征:两个波段(g、r)推断出的变星周期排名最高,其次是幅度百分位比、绝对偏差等散布度量。这说明在变星分类这类依赖物理周期的任务上,领域专家精心设计的特征依然携带着模型难以替代的关键信息。
图5 随机森林分类中最重要的前6项人工构造特征
03 OOD检测:Chronos-Bolt
一枝独秀,显著超越所有方法
这是全篇最突出的结果。在检测稀有/异常变星源时,Chronos-Bolt 的 OOD 纯度远超其他所有模型:Top1%纯度0.569、Top5% 0.532、Top10% 0.519,而手工特征作为第二名仅0.213,其余模型都接近随机水平0.116。在全部样本中约有11%是OOD 源的情况下,用 Chronos-Bolt 的嵌入只需评估10%的数据,就能找回约一半的 OOD 源——相比随机嵌入约5倍的搜索效率提升。论文认为这源于 Chronos-Bolt 的基于 patch 的多步生成训练,对单步级变化不敏感,从而在罕见形态上形成更紧的边界。
04 注意力机制分析:
tokenization是周期信息的关键
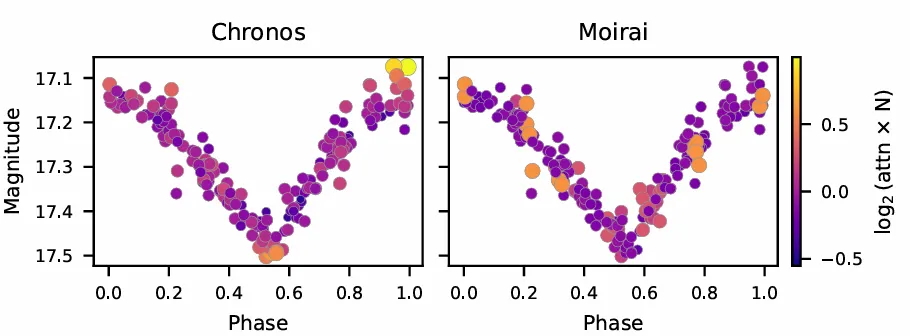
论文用注意力分数可视化解释了两类 TSFM 的差异。Chronos 采用逐点(point-wise)tokenization,注意力集中在亮度极值上,能捕捉光变曲线的完整波动范围(包括快速和慢速变化);Moirai 采用分块(patch-wise)tokenization,在不规则采样下每个 patch 可能对应时间基线差异极大的观测,反而加剧了不规则采样的困难。在不规则时序中,逐点 tokenization 比分块 tokenization 更少破坏信息。
图6 以星表周期完成相位折叠的一颗RRc型变星光变曲线的注意力得分可视化
05 失败分析:
TSFM把不规则当成规则
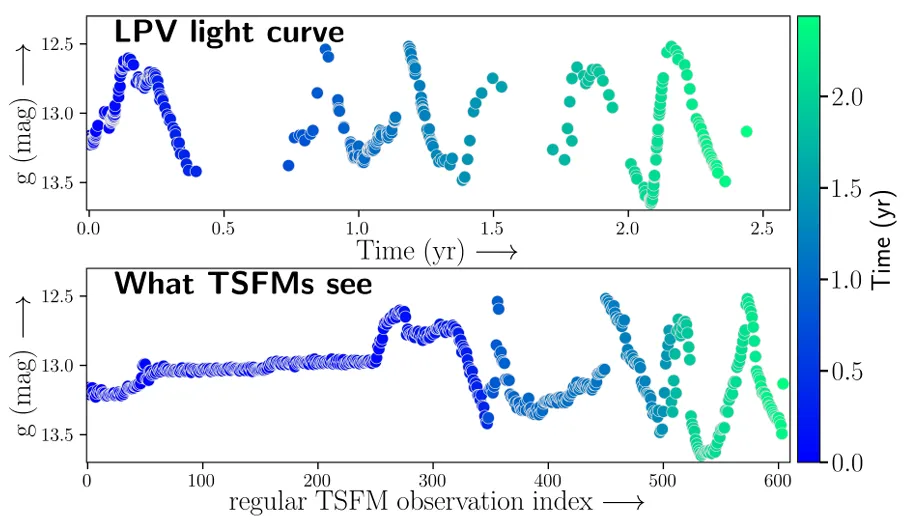
论文揭示了一个根本问题——被测 TSFM 都把不规则采样的数据当作规则采样处理。由于位置编码基于规则的 token/patch 序号,相对时间戳信息被丢弃,模型对光变曲线的周期结构产生了"扭曲的视图",无法正确解释数据的物理周期性。
图7 一颗长周期变星(LPV)的光变曲线:上图为采用真实物理时间索引的展示结果,下图为按观测顺序重新索引的非物理时间索引展示结果
06 微调实验:
目标选择比方法更关键
在微调 Chronos 时,用分类目标做端到端微调(Chronos-FTcls)明显优于沿用预测目标微调(Chronos-FTfcst,后者甚至不提升下游分类)。在参数高效微调对比中,用 MLP 分类头时 LoRA 与全微调表现相当(尽管 LoRA 只更新不到1/7的参数),而仅微调 LayerNorm 效果最差;用线性头时全微调最优。
总结
编辑:文婧
