解析线程并行上限、CFS运行队列及多核负载均衡的关系。
冷月清谈:
怜星夜思:
2、怎样判断进程的16C上限来自线程数量,还是来自cgroup或容器CPU配额?
3、把线程固定到指定CPU,性能一定会比让CFS自动调度更好吗?
4、40个逻辑CPU是否等价于40颗物理核心的计算能力?
原文标题:Linux下并发线程与CPU调度机制
原文作者:牧羊人的方向
原文内容
一台40核Linux服务器上运行着一个16并发线程的进程A。监控数据显示进程A的CPU占用上限为16C(约1600%),与线程数吻合;但系统级观测显示,CPU0至CPU39每核利用率均在40%左右,没有任何一颗核被打满,也没有任何一颗完全空闲。从进程视角看,其CPU占用已触及16C的并发上限;从系统视角看,40颗核均处于半负载状态。两个观测结果单独看均正确,合并分析则呈现出非线性关系:16个线程为何会均匀分布于40颗核之上?
这其中涉及到Linux 线程调度与CPU负载均衡机制,本文分层次展开分析。
1、并发上限和CPU均衡分摊
进程的并发上限锁定了CPU消耗总量,而负载均衡决定了算力的空间分布。进程CPU使用总量为16C,分摊至40颗CPU核,每颗核平均即为40%。
-
"最多16C"由进程自身的可运行线程数决定。16个线程同时最多占用16颗CPU,这是并行度上限,与系统CPU核总数无关。即使系统拥有128核,该进程仍最多使用16核的算力。
-
"每核约40%"由调度器的负载均衡机制决定。内核默认的CFS调度器会将线程分摊至所有核,因此16份算力被40颗核平均瓜分,每核分得16/40≈40%。
以下给出最小复现示例,便于验证(16个CPU密集线程+40核服务器):
// 示意:16个CPU密集线程 pthread_t t[16]; for (int i = 0; i < 16; i++) pthread_create(&t[i], NULL, busy_loop, NULL); // while(1){}观测命令
mpstat -P ALL 1 # 每核使用率 → 全部 ≈ 40%
top -H -p <pid> # 每个线程 CPU → 16 个线程各约 100%
ps -eLf | grep <pid> # 确认线程数 = 16
下文从"调度的最小单位"开始,逐层分析至负载均衡机制。
2、调度的最小单位线程
“进程"常被直观理解为调度对象,但是在Linux中能够被调度器安排至CPU中执行的最小单位是线程(内核中称为task)而非进程。进程仅是"一组线程的集合”(内核中称为线程组 thread group),其自身不占用CPU、也不参与调度排队。进程的CPU占用为其名下所有线程占用的总和。16并发线程对应16个可运行task,因此进程A的总CPU消耗上限为16颗核的满负荷,即16C。
底层实现上,线程通过clone()系统调用创建,携带CLONE_THREAD等标志,与同组线程共享地址空间mm、文件描述符表files、信号处理signal等资源;但每个线程拥有独立的task_struct(任务描述符),内含独立的调度信息,如调度策略、优先级/nice值、以及CFS用于记账的vruntime。调度器视角下不存在进程A,而是16个独立的调度实体。
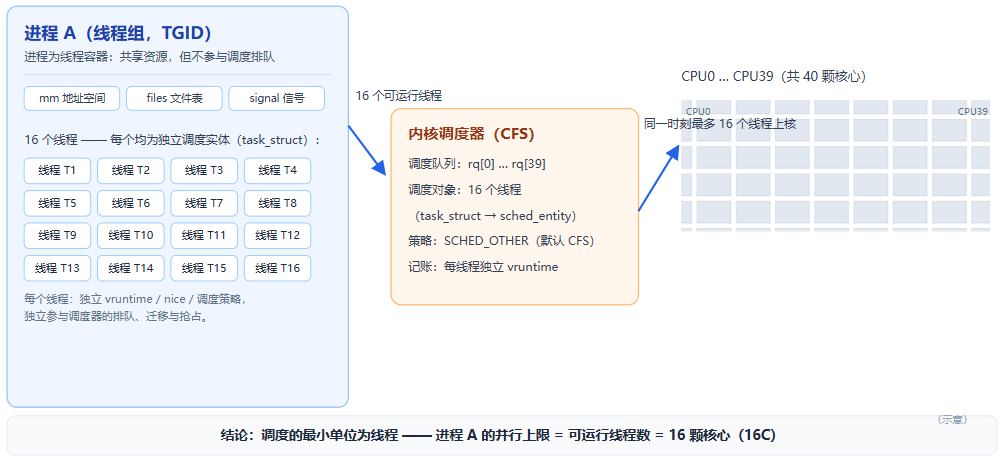
单个线程在任一时刻仅能运行于一颗CPU,16个线程即构成16个并行位,系统CPU核总数再多也无法增加并行度。但为何不是16颗CPU核打满24颗核空闲,而是40颗核均处于40%?这需要深入调度器内部机制。
3、per-CPU运行队列机制
Linux调度器(CFS,完全公平调度器)采用每颗CPU一个运行队列的设计(runqueue,内核中称为 rq),而非全局队列。
-
队列结构:每个rq内含一个cfs_rq,使用红黑树按虚拟运行时间vruntime组织所有可运行线程。vruntime越小,表明该线程累积的CPU欠账越多,优先级越高。
-
选择线程:调度时调用pick_next_task_fair(),直接选取红黑树最左节点(最小vruntime)上核运行。
-
记账与抢占:每次时钟中断tick,内核执行update_curr()累加当前线程的vruntime,再通过check_preempt_tick()判定是否触发抢占(上下文切换switch_to())。
-
结构约束:单个线程在任一时刻仅可挂载于一颗CPU的rq上排队或运行,不可能同时存在于两颗CPU核。
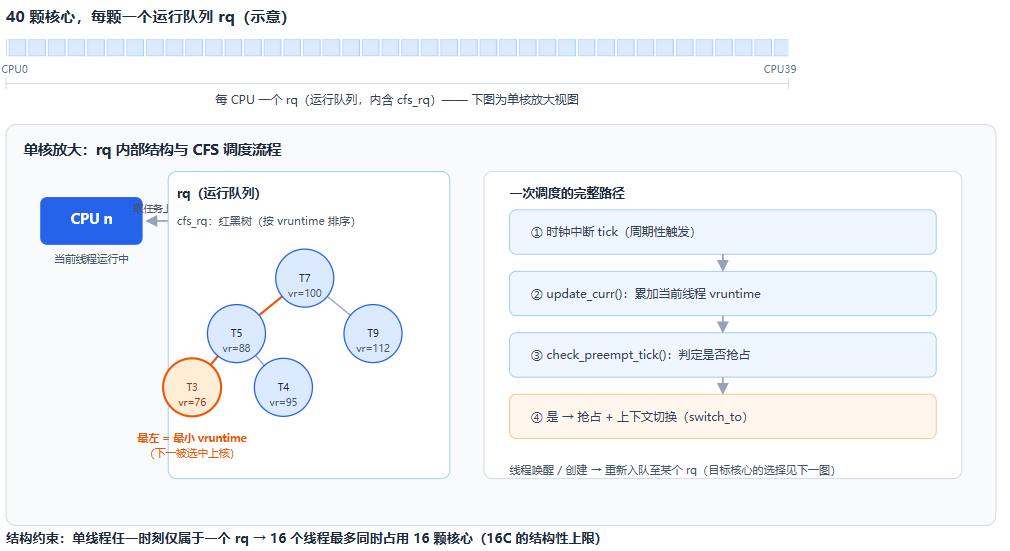
按照16个线程 × 每线程同时仅占一颗CPU = 16个并行位。那么16份算力会均匀分布于全部40颗CPU核,而非集中于16颗CPU核?答案在于内核的负载均衡器。
4、CPU负载均衡机制
若调度器将16个线程固定绑定于16颗CPU,观测结果应为"16颗CPU核100%、24颗核0%"。但默认CFS的设计目标恰好相反,CFS使负载在CPU核间尽可能均匀,因此线程会在 40颗核之间持续迁移。内核主要包含三条均衡路径:
-
唤醒均衡(wake-up balancing):线程被唤醒或新建时,select_task_rq_fair()结合wake_affine()选择目标核,优先选择空闲核、或与唤醒者缓存关系更近的核。
-
周期均衡(periodic balancing):调度器按调度域(SMT → 同簇 → NUMA 节点 → 全系统)周期性执行 run_rebalance_domains(),通过find_busiest_group()/find_busiest_queue()定位最繁忙的队列,将线程迁移至较空闲队列。
-
空闲均衡(idle balancing):CPU核即将空闲时执行 idle_balance()(含nohz下的空闲均衡),主动从其他队列拉取线程;若无法拉取,则通过active balance借助stopper线程强制迁移。
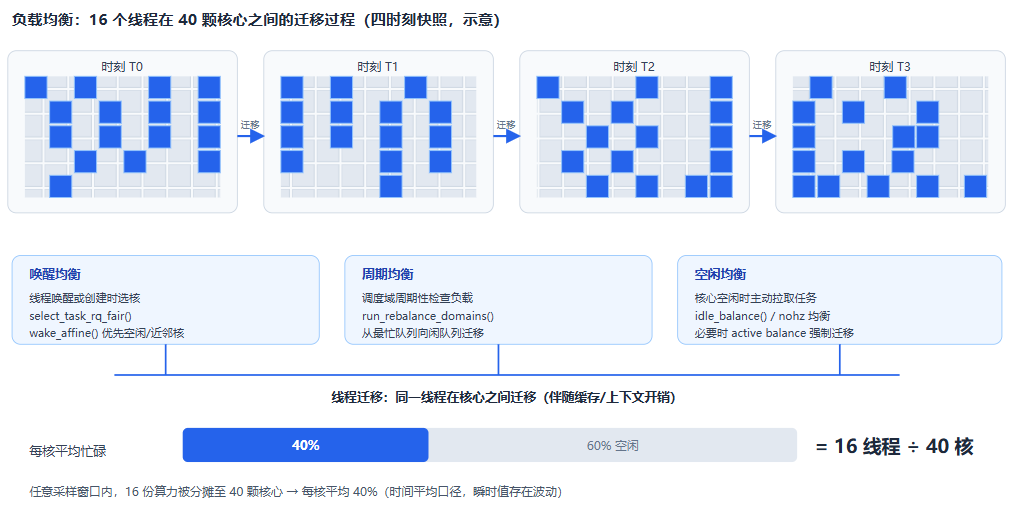
16个CPU密集线程(持续运行,无睡眠、无IO等待)保持可运行状态,负载均衡器将其运行机会轮流分配至40颗核。因此在任何采样窗口内,每颗核均在忙碌与空闲之间被均匀分摊。不过真实内核中的负载均衡还受调度域层级(SMT/同簇/NUMA节点)、迁移代价、超线程共享等约束影响,并非理想的绝对平均。
Linux中通过sched_domain 的层次结构做负载均衡,粒度从细到粗:
SMT 域          (同一物理核内的2个逻辑CPU)
  └→ MC 域     (同一LLC内的核)
      └→ DIE 域 (同一芯片内的多个LLC)
          └→ NUMA 域 (同一NUMA节点)
              └→ GLOBAL域 (跨节点)
每层域有自己的 load_balance() 触发条件和迁移成本:
|
域
|
触发频率
|
迁移代价
|
典型行为
|
|---|---|---|---|
|
SMT
|
每次tick
|
极低
|
把任务从忙的兄弟核拉到闲的兄弟核
|
|
MC
|
定期(sd->balance_interval)
|
低
|
迁移到同LLC的空闲核
|
|
NUMA
|
低频
|
高(跨内存控制器)
|
迁移到同节点的空闲核
|
|
GLOBAL
|
极低频
|
极高
|
尽量避免
|
5、总结
假设16个线程均为CPU密集型(持续运行,无sleep、无IO等待),则每秒总需求16个线程 × 每线程满负荷100% = 16核·秒/秒。此即进程A的CPU占用上限16C(top显示约1600%)的物理含义,每秒消耗相当于16颗核满负荷运行一整秒的CPU时间。而系统具有40颗核,每秒提供40核·秒的算力。负载均衡器将需求分摊至所有核,每颗核每秒被占用16 ÷ 40 = 0.4 核·秒,即利用率40%。
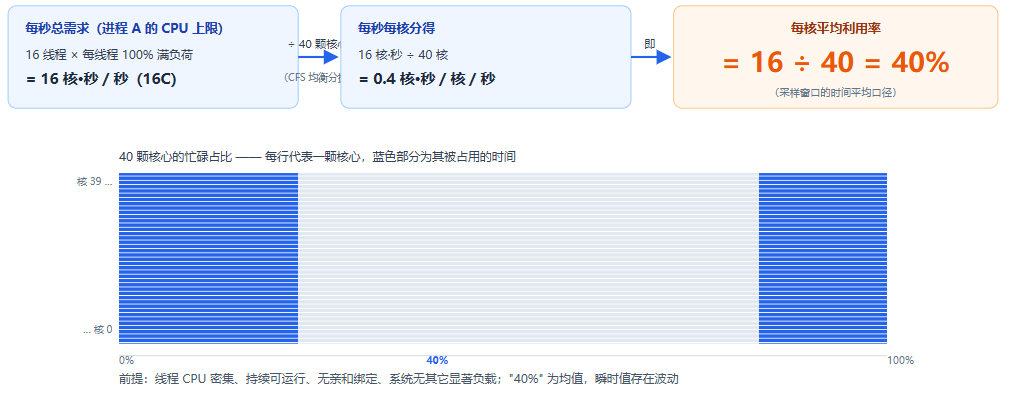
该40%为时间平均口径:mpstat、top等工具按固定周期采样/proc/stat,以窗口内忙碌时间除以墙钟时间计算。16个线程轮流在CPU核间迁移,每个采样窗口内每核约有40%的时间执行该进程的线程,因此既不会出现16核打满,也不会出现任何一颗核完全空闲。
本文推导成立的前提为:CFS(SCHED_OTHER)默认配置、线程无CPU亲和绑定、无cpuset约束、无实时线程抢占、无cgroup配额、线程CPU密集且持续可运行、系统无其它显著负载。以下情况需调整结论: