李博杰开源AI Infra新书,并披露Agent协作调研、验证与写作流程。
冷月清谈:
怜星夜思:
2、如果要判断一个大模型应用为什么慢,普通开发者应该先查算力、显存,还是数据搬移?
3、让Agent连续调研几天、产出几十GB资料,怎样避免资料很多但结论不可靠?
4、技术书先开源初稿、边收反馈边修订,会不会比闭门写完再出版更合适?
原文标题:开源首日破 2k Star!李博杰又出手了
原文作者:图灵编辑部
原文内容
9 月 14 日,李博杰老师的新书《深入理解 AI Infra:量化分析与系统设计》(图灵待出版)在 GitHub 开源。发布当天,Star 数就突破了 2000,比上一本《深入理解 AI Agent》涨得还快。截止发文,已有 3.9k Star!
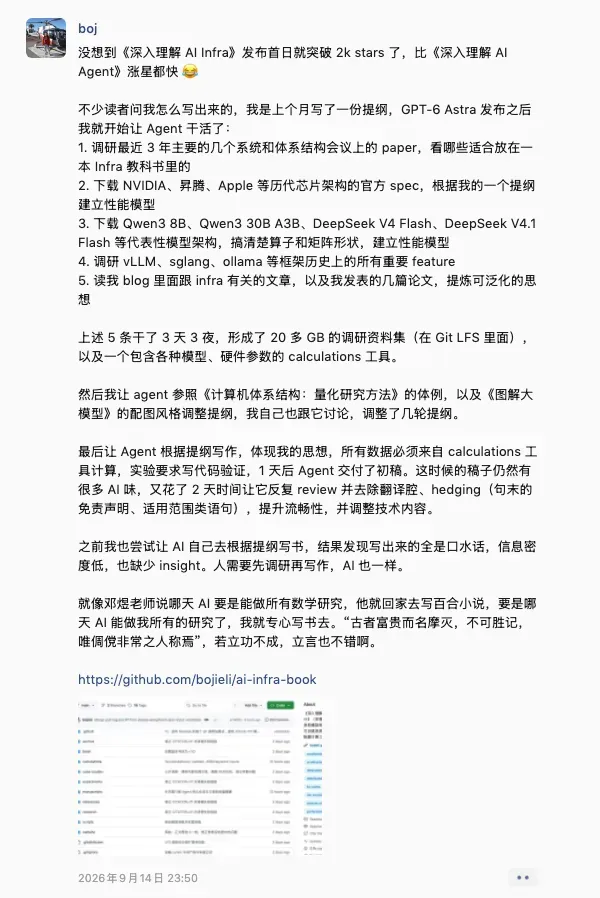
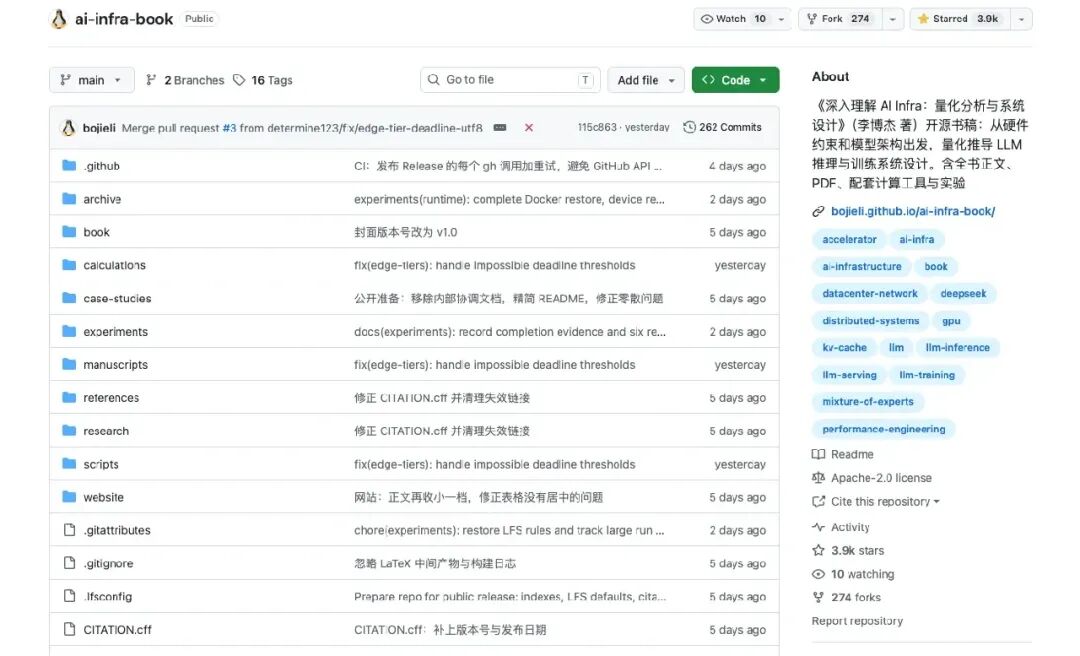
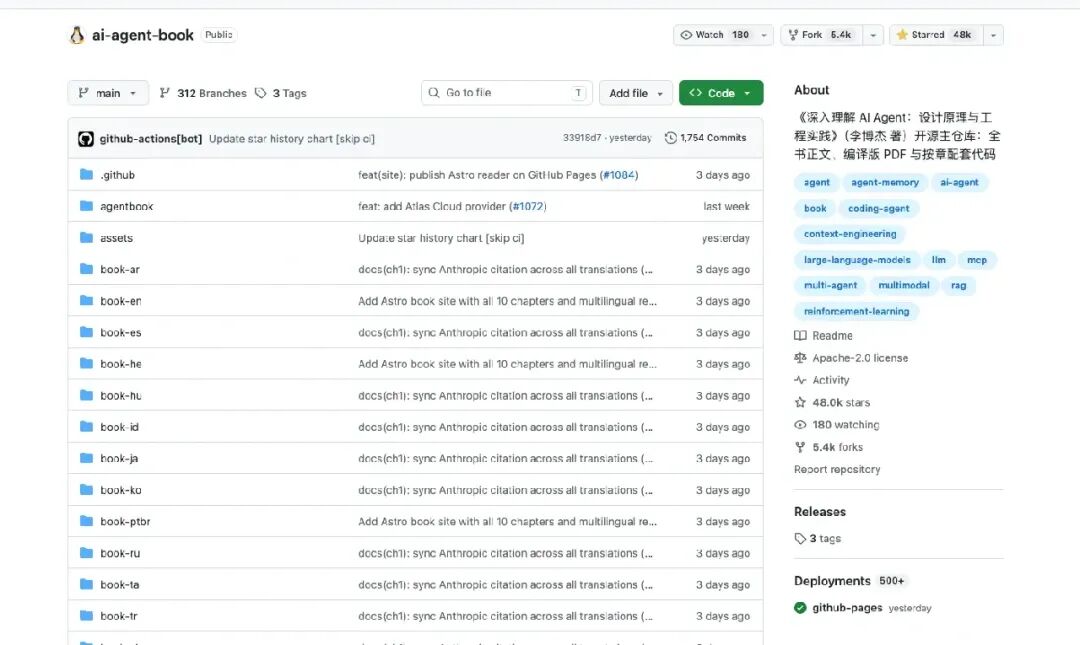
《深入理解 AI Agent》(图灵待出版)在 GitHub 上已经有 48k+ Star,是很多人学习 Agent 的入门读物。这本新书是它的姊妹篇。
更让人好奇的是它的写法。博杰老师从开始调研到交出打磨好的初稿,大量工作是带着 Agent 一起完成的。今天就和大家聊聊这本书,以及它背后的写作方法。
这本书讲什么
写完《深入理解 AI Agent》(图灵待出版)之后,博杰老师在和读者交流时越来越感到,想把模型应用做好,还需要理解模型背后的运行基础。
这就像大多数软件工程师不用亲手写操作系统、造芯片,却依然要学操作系统和计算机体系结构。因为每一次读文件、调函数,背后都有时间和资源的代价。用模型做应用也是一样:响应速度差几倍,产品体验就完全不同;成本差一个数量级,能支撑的商业模式也会跟着变。
博杰老师有一个很形象的说法:在大模型时代,模型就像操作系统,AI Infra 就像计算机体系结构。他入门体系结构靠的是《计算机体系结构:量化研究方法》(图灵待出版),而 AI Infra 领域还缺一本类似的书。这就是他写这本书的初衷。
一条贯穿全书的主线
全书的思路是“从限制条件出发推导设计”。先搞清楚任务要求,再对照硬件的容量、带宽和算力做估算,看看理论上限在哪里,实际表现离上限还有多远。
在多年的研究和工程实践中,博杰老师反复遇到同一条线索:数据搬移。所以书里反复追问五个问题:搬什么、搬多少、搬几次、经过哪里、谁必须等它。
内容和读法
全书共 12 章,从模型结构、芯片、网络,一直讲到推理、训练和部署。每章围绕一个具体问题展开,比如第 1 章讨论的就是:模型生成一次内容,到底需要多少显存、计算和数据读写?
如果你调用过模型,或在自己的电脑上跑过模型,想弄清楚模型为什么慢、成本怎么降,这本书就是一个好起点。博杰老师建议先读前 3 章,再根据自己的方向挑重点:
-
做模型应用和推理服务,重点读第 8、9 章
-
做系统或网络,重点读第 5–7 章
-
做芯片与体系结构,重点读第 4–7 章
书里还配有计算工具和实验。遇到书中的算例,可以先自己估一估,再看推导;也可以换成自己正在用的模型和硬件,重新算一遍。
目前书稿还是初稿,仍在持续修订,欢迎大家一起参与勘误。
这本书是怎么写出来的
这样一本 12 章、带计算工具和实验的书,很多读者问博杰老师是怎么写出来的。他分享了完整的过程。上个月,他先写好一份提纲,等新模型一发布,就开始让 Agent 干活了。
第一步:让 Agent 做调研
博杰老师给 Agent 布置了五项调研任务:
-
梳理近三年几个重要学术会议上的论文,挑出适合写进教科书的内容
-
下载英伟达、昇腾、苹果等历代芯片的官方资料,按提纲建立性能模型
-
拆解 Qwen3、DeepSeek 等代表性大模型的结构,建立性能模型
-
梳理主流推理框架历年来的重要功能
-
读博杰老师自己的博客文章和论文,提炼出可以复用的思想
这五项任务,Agent 连续干了 3 天 3 夜,整理出 20 多 GB 的调研资料,还做出了一个包含各种模型和硬件参数的计算工具。这些资料和工具后来也随书一起开源了。
第二步:一起打磨提纲
调研完成后,博杰老师让 Agent 参照《计算机体系结构:量化研究方法》的体例,以及《图解大模型》的配图风格,重新调整提纲。他自己也和 Agent 一起讨论,前后改了好几轮。
第三步:写作、审读、再打磨
提纲定下来后,Agent 开始写作。博杰老师定了两条规矩:书中所有数据都必须由计算工具算出来,实验都要写代码验证。同时,写作要体现他本人的思考。
1 天后,Agent 交出了初稿。之后博杰老师又花了 2 天,带着 Agent 反复审读,让文字更自然流畅、表达更干脆,同时调整技术内容。
整个流程可以概括成这样:
|
阶段
|
博杰老师做什么
|
Agent 做什么
|
用时
|
|---|---|---|---|
|
调研
|
写提纲、布置任务
|
读论文、查资料、做计算工具
|
3 天 3 夜
|
|
定提纲
|
指定参考书、参与讨论
|
按参考书调整提纲
|
多轮
|
|
写初稿
|
定规矩:数据要算、实验要验
|
按提纲写作
|
1 天
|
|
打磨
|
审读、调整技术内容
|
按意见反复修改
|
2 天
|
博杰老师的写法,给我们的三点启发
把 Agent 用到能合写一本书的程度,靠的是一套清晰的做事方法。从博杰老师的分享里,我们总结出三点。
1. 先调研,再写作
博杰老师也试过让 AI 直接根据提纲写书。后来他发现,调研做得越扎实,写出来的内容信息量越足,洞见也越多。他的总结是:人需要先调研再写作,AI 也一样。
这个道理不止适用于写书。写方案、做分析、开发功能,先让 Agent 把资料收集齐、把情况摸清楚,后面的工作就会顺得多。
2. 给 Agent 可以检验的标准
“数据必须由计算工具算出来,实验必须写代码验证”,这两条规矩让每一个结论都有据可查。
这对 AI Infra 这样的主题尤其重要。博杰老师在书里提到,这类估算人容易出错,AI 也一样,漏掉一项,结论就可能差出几倍。有了可以检验的标准,人和 Agent 都能随时核对。
3. 人来定方向,Agent 来执行
在整个过程里,博杰老师一直在场:写提纲、布置任务、指定参考书、定规矩、审读修改。大量繁重的阅读、计算和写作,则交给 Agent 完成。
人负责判断和把关,Agent 负责执行,这就是博杰老师几天内完成一本书初稿的关键。
博杰老师在分享最后引了司马迁的一句话:“古者富贵而名磨灭,不可胜记,唯倐傥非常之人称焉。”他说,如果有一天 AI 能做完他所有的研究,他就专心写书,立言也不错。
想跟着博杰老师学 Agent?
博杰老师写书的过程,其实就是一次完整的 Agent 实战:拆解任务、准备资料、设定验证标准、一轮轮审阅和迭代。
如果你也想系统掌握 Agent 的设计与实践,让 Agent 真正帮你把复杂的事情做成,欢迎了解博杰老师亲自带队的【Agent 实战营 2.0】。
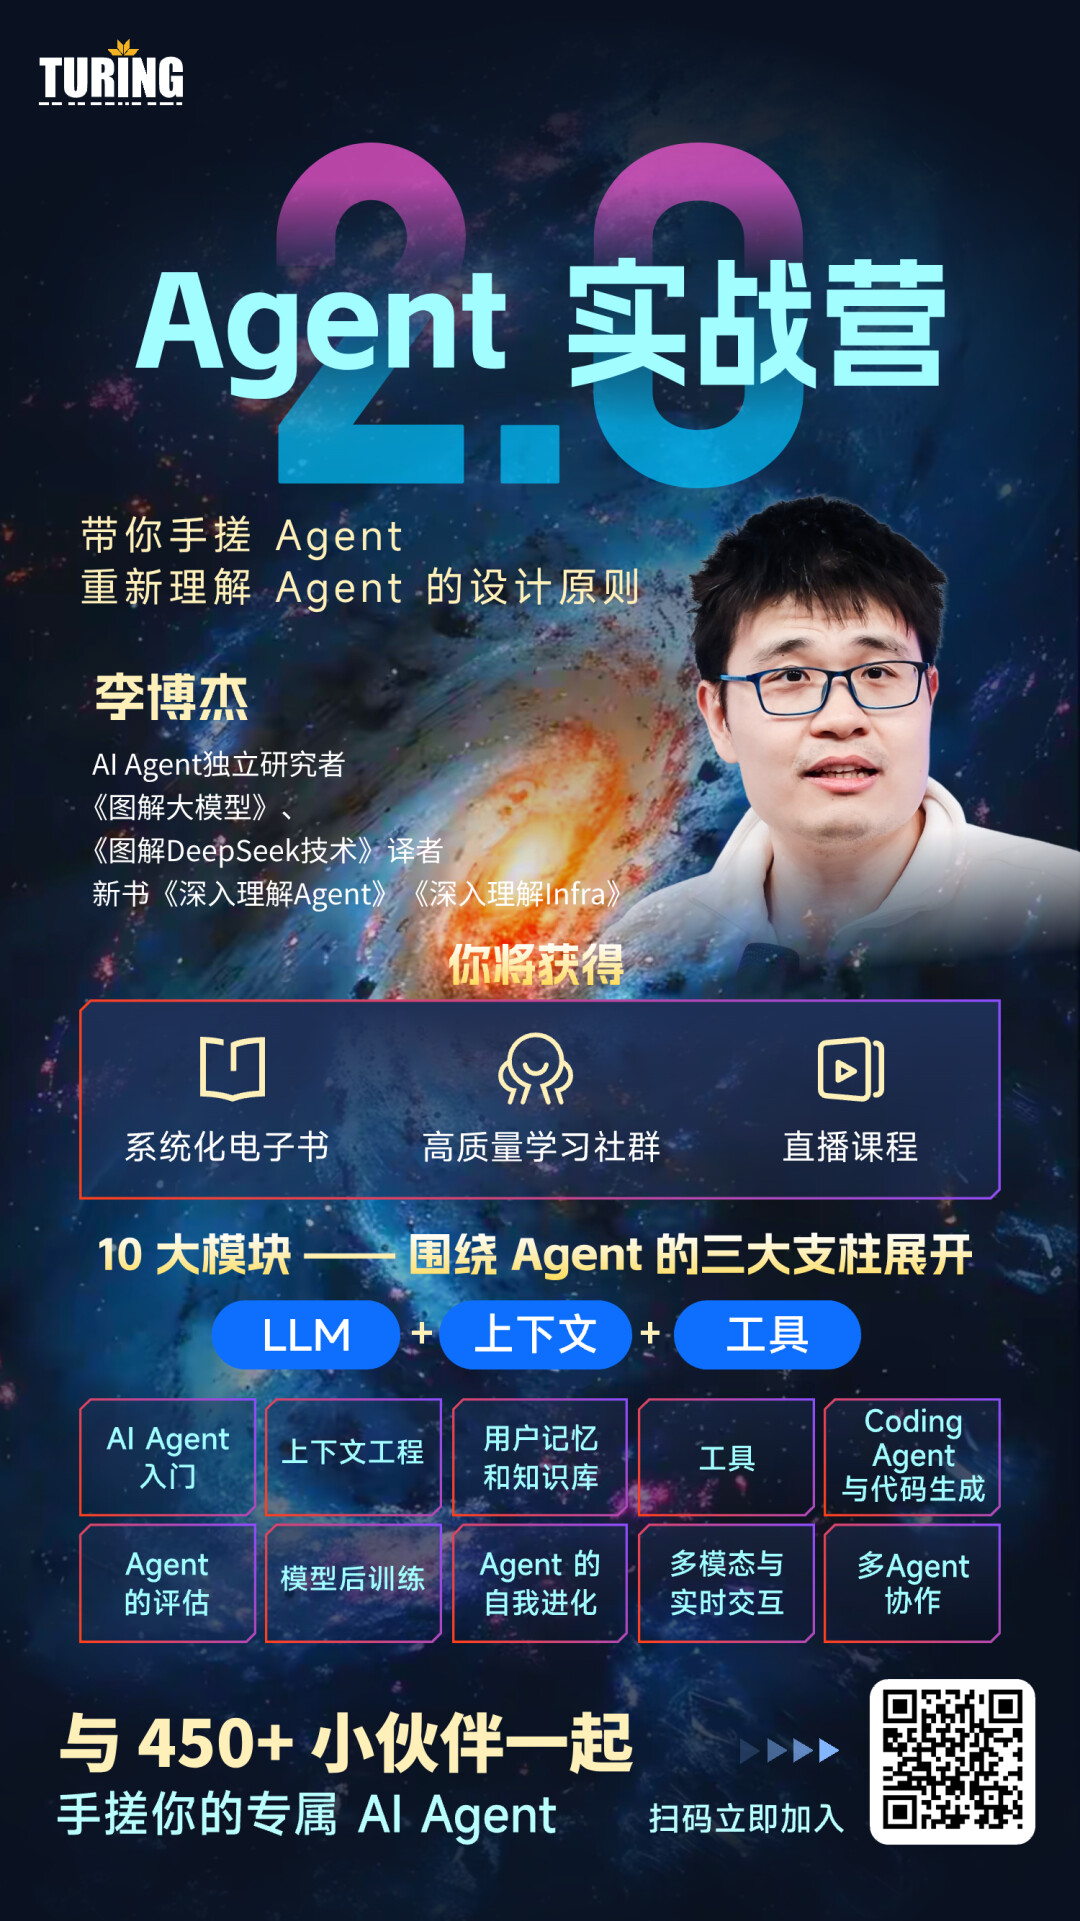
【Agent 实战营】已经开设一年了,《深入理解 AI Agent》这本书本身就是它的产物——博杰老师说过,这本书是伴随实战营 1.0 一整年的直播内容打磨出来的,年底才整理开源。现在反过来,这本书成了实战营 2.0 的教材:课程顺着书的章节往下讲,同时结合最新的行业动态持续加餐,比如这次讲的 Harness 与模型参数自动更新,就是书里第七到九章内容的现场展开。
亮点一:不是自己啃书,是跟着直播讨论
博杰老师自己在直播里说得很直接:课程比单看一本书更值,就在于你能直接向他提问、看他拆解案例,社群里同学也会分享自己做的项目——比如有学员在美国工作,做了一个 Agent 之后专门开了一场分享给大家看。
亮点二:不是听概念,是真的要上手做
每期实战营都配有实际案例,博杰老师提到大概有八十多个需要自己动手做的实验。他原话是:“如果你只是想看概念的,我觉得这个实战营就不适合你,因为实战营就是教大家去实战的。”
亮点三:不绑定某个框架,紧跟最新技术动态
课程不是照着某一个 Agent 框架讲的,只要有 Python 基础就能跟上;博杰老师也会根据行业里刚出现的新技术(这次是 Harness 自动更新)持续做专题加餐,内容会跟着 Agent 的演进一起更新。
适合谁
-
已经在做 Agent、想接着往深了学的开发者
-
最近总听到 harness、skill 这些词,但还没完全搞明白是怎么回事的人
-
需要和工程同事一起设计 Agent 规则、拿主意的产品经理——博杰老师直播里专门提到,这类规则设计“应该是产品经理自己想清楚”的事
-
只要求会写 Python,不要求精通某个特定框架
点击「阅读原文」,了解 Agent 实战营 2.0
《深入理解 AI Infra》开源地址(复制到浏览器打开): https://github.com/bojieli/ai-infra-book