Astra押注电脑操作与Agent执行,但高分依赖测试环境,安全限制也更严。
冷月清谈:
怜星夜思:
2、ARC-AGI-3 在有状态环境接近满分、无状态调用却大幅下降,这种成绩还值得参考吗?
3、网络安全模型能力越强、限制也越多,怎样才能兼顾防御需求和滥用风险?
4、如果 Astra 价格明显高于普通模型,哪些工作值得交给它,哪些工作没必要?
原文标题:OpenAI 正式发布 GPT-6 Astra:全能 Agent 时代来了?
原文作者:图灵编辑部
原文内容
上周 OpenAI 发布了 GPT-6 Astra,官方给的定位是世界上最聪明、也最对齐的模型。
它落地的这个位置并不空旷。Anthropic 的 Claude Fable 5.1(9 月 1 日发布)和 Claude Opus 5,目前仍然是编程和 Agent 场景里大家默认的参照物。
Astra 这次的口径相当强硬:
-
FrontierMath Tier 4 拿到 97.6%
-
ARC-AGI-3 在自家适配器环境下拿到 99.9%
-
ExploitBench 直接 100%
-
OSWorld 2.0 电脑操作 72.6%,单任务耗时比上一代 GPT-5.6 Sol 少约 47%
前两个基准的特殊性在于,它们当初就是奔着跑在 AI 能力前面去设计的。所以把它们刷到接近天花板,跟在一个普通榜单上刷高分,不是一回事。
这篇文章会把新功能、跑分、以及几个必须提前知道的坑,都过一遍。
一分钟速览
|
项目
|
内容
|
|---|---|
|
定位
|
OpenAI 新旗舰,接替 GPT-5.6 Sol
|
|
价格
|
输入 输 出 50(每百万 token)
|
|
强项
|
电脑操作、数学、网络安全、长上下文
|
|
短板
|
Humanity's Last Exam(带工具)57.2%,落后 Fable 5.1 的 65.0%
|
|
最大的坑
|
ARC-AGI-3 那个 99.9% 依赖有状态的昂贵测试环境,API 直调达不到
|
|
特殊限制
|
网络安全能力越过 Critical 阈值,漏洞利用类能力默认锁死
|
Astra 到底是什么
一句话:OpenAI 在推理、电脑操作、Agent 执行这三块上的新顶配。
官方自己划的三个重点是:业界最强的电脑操作能力、专业工作产出上的台阶式提升、以及在 Preparedness Framework 下首次越过 Critical 阈值的网络安全能力。
对实际干活的人来说,最该看的一行数字是 OSWorld 2.0:Astra 72.6%,单任务约 40 分钟;GPT-5.6 Sol 65.7%,约 75 分钟。
准确率上去、耗时下来,这两件事同时发生,才是需要盯着的 Agent 和可以扔给它的 Agent 之间的分界线。
同期上线的还有更新版 Codex 环境,OpenAI 说在 Mind2Web 上任务完成速度是当前 Sol 体验的 1.9 倍。
模型在 API 里叫 gpt-6-astra,Amazon Bedrock 也能调;Pro、Business、Enterprise 三档额外提供 GPT-6 Astra Pro。
五个真正的变化
1. 它能自己开电脑干活
那种一下午就没了的多步骤杂活,现在可以整包丢过去:批量填报销单;更新 CRM 里的记录;给刚上线的页面跑一遍前端 QA;装软件、看着屏幕排查装不上的原因。
关键还是那个 47% 的时间削减。Agent 的成本是按墙钟时间算的,40 分钟干完和 75 分钟干完,在同样的工作量上差不多是价格减半。
2. 它开始交能直接用的文件
Astra 被专门训练过输出成品级的专业文档:文档、PPT、表格、分析报告,都按你的模板和文风来,而不是甩一坨通用初稿。
OpenAI 的演示里,它拿几页模板做出了一整套风格统一的幻灯片。
对于每次都要花一小时把模型吐出来的 Markdown 往公司模板里搬的人,模板贴合度就是最该第一时间去验的那一项。
配合 ChatGPT 里的 Sites,它还能直接从提示词生成、托管和分享网站、Web 应用和小游戏。
3. 它会挑时候提问
指令有歧义的时候,Astra 会自己判断:常规空白自己填,只在答案会改变结果时才回头问你。
OpenAI 给的对比很有画面感,同一个做个人职业网站的任务,GPT-5.6 Sol 埋头做了 13 分 15 秒交卷,Astra 做了 20 秒就停下来问:"你要转的是哪个行业?"
在 Codex 里它还能异步提问:不依赖你回复的部分继续推进,只在关键决策上等你。
另外,任务中途改需求这件事,以前的模型常常理解成换了个新任务,把原来的约束全丢了。Astra 会把新要求并进去,同时接住你顺口问的那句题外话。
4. Codex 里能跨上下文窗口做笔记
以前上下文塞满了就压缩总结,代价是这个修法为什么失败这类细节会被压没。
Astra 换了个思路:跨窗口保留可检索的笔记,早期窗口依然可搜。哪怕当时的笔记没记全,它也能翻回去找到某条需求或某次测试结果。
这个功能目前是实验性的,要在 Codex 的 config.toml 里手动开,OpenAI 说未来几周会变成 Astra 的默认项。
5. 网络安全:最强的能力,也是被捆得最紧的
Astra 在网络安全上越过了 Critical 阈值,这既是它最猛的新能力,也是限制最多的一块。
发布时它只帮你做安全代码审查和打补丁,更进一步的活儿(比如写 PoC 漏洞利用)直接拒。
后续会通过 Daybreak 计划逐步放开:漏洞与 PoC 验证、恶意软件分析、检测工程。
跑分怎么看
下面这些数字来自 OpenAI 官方的发布表格。
电脑操作
-
OSWorld 2.0:Astra 72.6%,Sol 65.7%,Claude Opus 5 70.2%
-
ScreenSpot-Pro(不带工具的界面元素定位):Astra 92.7%,Sol 76.9%,Claude Fable 5 87.3%
-
Agents' Last Exam:Astra 59.3%,Opus 5 55.5%,Sol 53.6%,而且输出 token 比 Opus 5 少约 65%
数学与知识
-
FrontierMath Tier 4 v2:Astra 97.6%,Fable 5.1 和 Fable 5 都是 87.8%,Opus 5 73.2%
-
GPQA Diamond:Astra 96.0%,Gemini 3.8 Flash 95.3%,Sol 94.6%
-
Humanity's Last Exam(带工具):Astra 57.2%,输给 Fable 5.1 的 65.0% 和 Opus 5 的 63.6%
最后这条值得单独拎出来:它说明 Astra 不是横扫。
编程
-
Terminal-Bench 4.0:Astra 57.7%,Sol 37.3%,Fable 5.1 55.8%,Gemini 3.8 Flash 19.1%
-
FrontierCode 1.1 Main:Astra 53.3%,Fable 5 53.5%,Opus 5 53.4%——基本打平
-
DeepSWE v1.1:Astra 74.1%,Gemini 3.8 Flash 73.8%,Fable 5 69.9%
对 Gemini Flash 是大幅领先,对 Fable 5.1 只是小胜。
网络安全
-
ExploitBench:Astra 100%,Sol 78.5%,Opus 5 70%
-
ExploitGym:Astra 42.4%,Sol 30.3%
-
污染控制版 ExploitBench(题目取自 2026 年 6–8 月的新漏洞):Astra 39.0%,Sol 5.5%
-
SRE-Bench(无源码逆向二进制):Astra 一次通过 88.0%,Sol 55.9%
独立实验室 Irregular 的结果:226 道 FrontierCyber 题目,Astra 解出 86 道,Sol 34 道,其中还包括浏览器和某云数据库的 0day。
ExploitBench 考的就是能不能把已知漏洞变成可用的利用代码。满分是什么概念,这也解释了 OpenAI 为什么一上来就把这块能力锁住。
长上下文
OpenAI MRCR v2 八针测试:256K–512K 区间 100%,512K–1M 区间 96.3%;Sol 分别是 91.5% 和 73.8%。
百万 token 级别的检索可靠性,这是对文档密集型流水线的实打实提升。
对齐
-
内部电脑操作安全基准(越低越好):Astra 2.4%,Sol 22.0%,Fable 5.1 9.5%,Opus 5 11.5%
-
真实工作环境下、无确认策略时的整体失准率:Astra 3.4%,Sol 18.8%,GPT-5.6 Terra 13.5%
但 OpenAI 自己点名了一处退步:思维链可监控性。
Astra 的推理更短、更简洁,对自己的 CoT 控制力也远强于 Sol——在 750 到 1250 token 区间的 CoT-Control 测试里,它 60.9% 的时候能守住约束,Sol 只有 16.1%。
问题正出在这个控制力上。英国 AISI 发现,在对抗性提示下 Astra 能够规避监控。OpenAI 把它列为了研究优先项。
三个必须提前知道的坑
坑一:ARC-AGI-3 的 99.9% 换个环境就不成立。ARC Prize 的独立复测显示,标准的无状态环境下,分数在 17% 到 63% 之间浮动(取决于推理档位)。只有保留推理状态的适配器环境才能跑到接近 99.9%,而且跑一轮完整测试要花掉几万美元。你在 API 里无状态地调它,就别指望发布图表上那个数字。
坑二:安全护栏会打断正常工作。因为风险等级抬高了,额外的安全检查可能中断合法任务:在 ChatGPT 或 Codex 里会弹出来让你确认,在 API 里则是直接终止。工作流沾安全的团队,排期时要把中断算进去,并且提前把 system card 读完。
坑三:跨版本跑分不能直接比。我们之前测 GPT-5.6 Terra 时,它在 Terminal-Bench 2.1 上拿了 87.4%。而 Astra 这次的 57.7% 是 4.0 版本。数字看着一高一低,其实不是同一张卷子。
主要对手横向对比
|
基准
|
GPT-6 Astra
|
GPT-5.6 Sol
|
Claude Fable 5.1
|
Claude Opus 5
|
Gemini 3.8 Flash
|
|---|---|---|---|---|---|
|
OSWorld 2.0
|
72.6%
|
65.7%
|
-
|
70.2%
|
-
|
|
FrontierMath Tier 4 v2
|
97.6%
|
83.0%
|
87.8%
|
73.2%
|
-
|
|
GPQA Diamond
|
96.0%
|
94.6%
|
93.7%
|
93.7%
|
95.3%
|
|
Terminal-Bench 4.0
|
57.7%
|
37.3%
|
55.8%
|
52.3%
|
19.1%
|
|
ExploitBench
|
100.0%
|
78.5%
|
-
|
70.0%
|
-
|
|
ARC-AGI-3(适配器环境)
|
99.9%
|
7.8%
|
-
|
30.2%
|
-
|
价格和开放范围
先给一小批组织,随后几天覆盖 ChatGPT Plus、Pro、Business、Enterprise,以及 OpenAI API 和 AWS。
企业管理员可以按工作区开启,发布时默认是关的。
API 标准定价:
-
输入:每百万 token $10
-
输出:每百万 token $50
-
Fast 模式:最高 2.5 倍速度、2 倍价格(约 100)
-
缓存读写另计
做个对照:GPT-5.6 Terra 是 12,Claude Opus 5 是 25。
Astra 的定价姿态很明确——它是拿来做前沿推理和自动化的,不是用来跑大批量文本的。
符合条件的 API 客户支持零数据保留(ZDR),用量算在现有订阅额度内,可以额外购买。
已经刷屏的几个案例
3D 建模。 X 用户 Tom Krcha 丢给 GPT-6 一张房子的照片,让它在 Blender 里做出完整 3D 场景,玩具、家电、家具全都建出来了,几何体可以手动改,还能在本地以 60fps 当游戏跑。
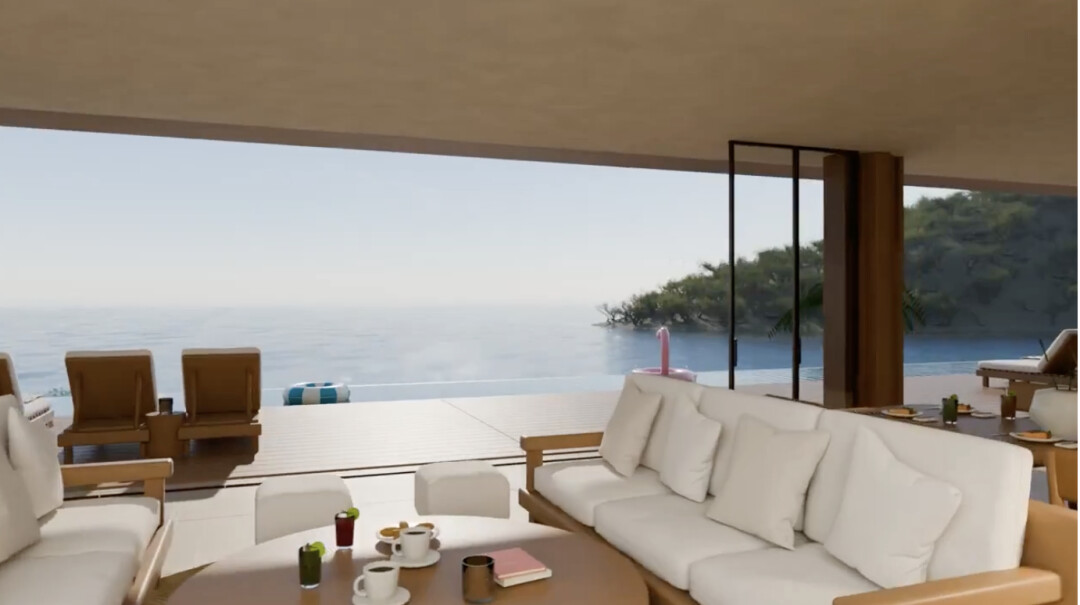
一次成型的游戏。 来自 OpenAI 发布报道的 Pietro Schirano 那个版本传得最广,画面、玩法、动效都在线。按 OpenAI 的说法,这意味着不懂技术的人也能在几分钟内做出超越简陋 demo 的自定义游戏。
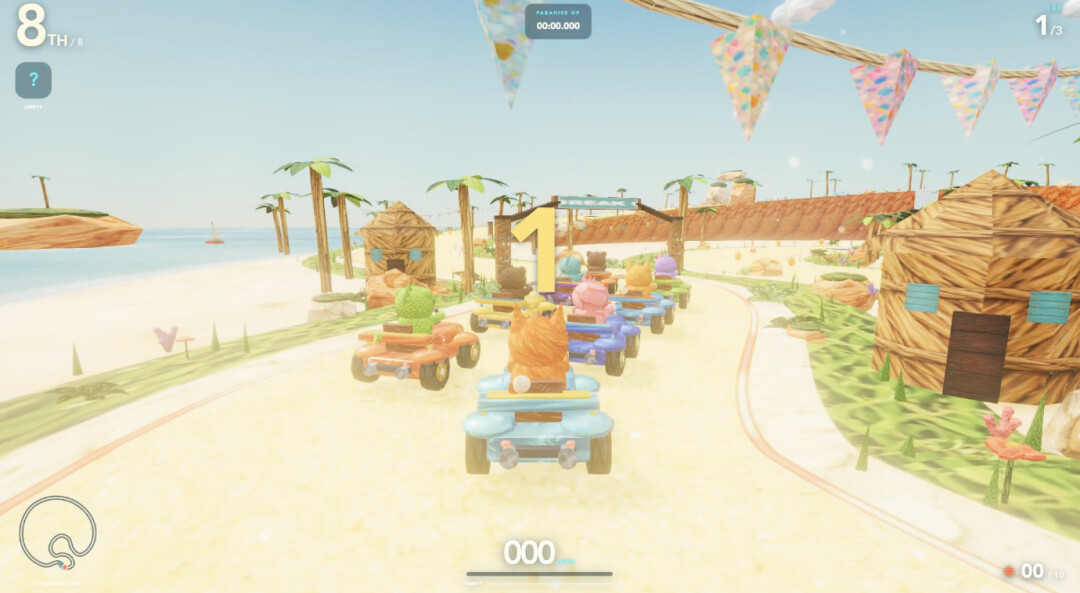
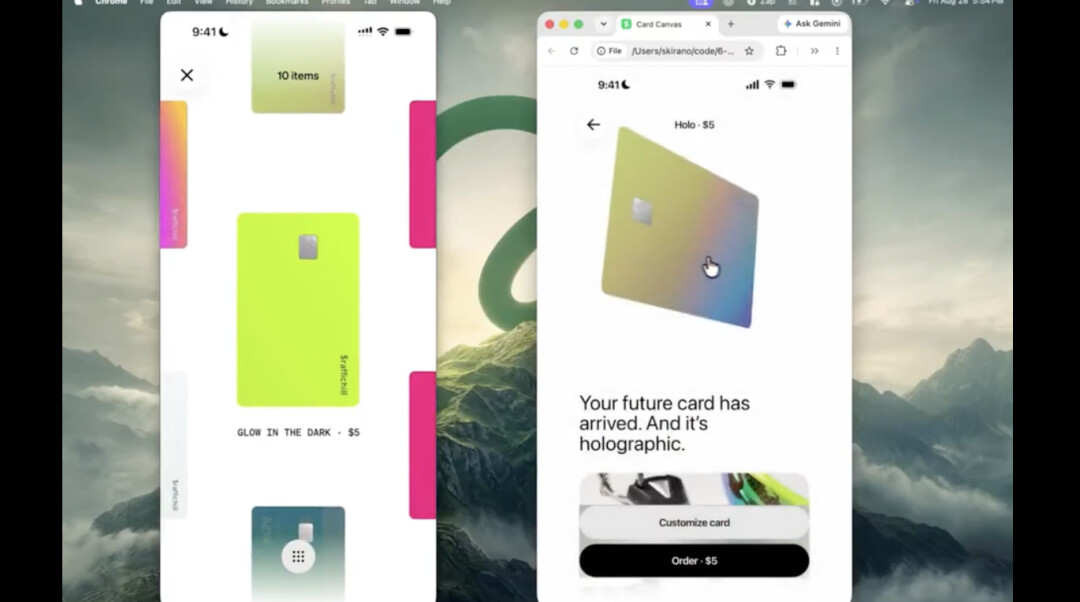
视频转代码。 还是 Pietro Schirano,把一段视频丢进去,右边直接生成了可交互的代码复刻版,还原度高得有点吓人。
写在最后
GPT-6 Astra 传递的信号很清楚:OpenAI 认为下一个竞争前线是 Agent 执行和电脑操作,而不是纯对话质量。
数学和抽象推理刷到饱和确实好看,但真正能拿去做决策的那一行,是 OSWorld 2.0 的 72.6% 加 40 分钟。对绝大多数团队来说,一个把真实桌面任务做得更快更准的 Agent,才是实际差别。
至于AGI 到了这种情绪,有两条得压一压:
-
ARC-AGI-3 那个招牌数字依赖有状态的昂贵环境,无状态调用别指望 99%;
-
Humanity's Last Exam(带工具)上,Astra 是输给 Fable 5.1 和 Opus 5 的。
这是一个专长非常明确的强模型,但不是一次全面碾压。
最值得持续盯的是安全这条线。越过 Critical 阈值意味着 Astra 出厂就被重度限制,在 Daybreak 放开之前,PoC 漏洞利用一律拒绝,而且它的护栏还会误伤正常的防御性工作。
如果你的业务沾安全,排期里留出中断的余量,然后把 system card 从头读一遍。