国内外大模型产品对比:国外侧重通用模型和生态,国内注重技术与应用融合。中国大模型API调用量崛起。
原文标题:国内外大模型产品一览
原文作者:牧羊人的方向
冷月清谈:
怜星夜思:
2、文章中提到了国内外大模型各有侧重,国外偏重通用性,国内强调应用落地。那么,这种差异未来会如何演变?是会趋同,还是会各自发展出独特的优势?
3、文章提到了大模型评测,SuperCLUE主要针对中文大模型,那么除了SuperCLUE,还有哪些比较权威的大模型评测标准或平台?它们各自的侧重点是什么?
原文内容
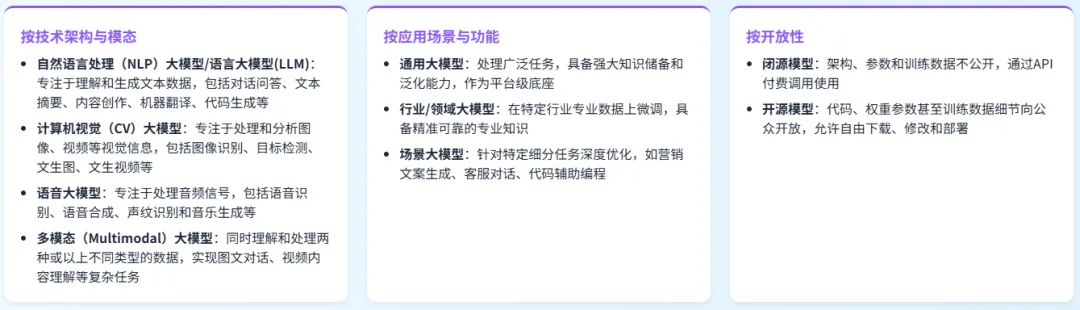
大模型产品矩阵通常可以从以下几个维度分析:
-
按技术架构与模态,包括自然语言处理、计算机视觉CV、语音大模型和多模态大模型
-
按应用场景与功能,包括通用大模型、行业领域大模型和场景大模型
-
按开放性:分为闭源模型和开源模型
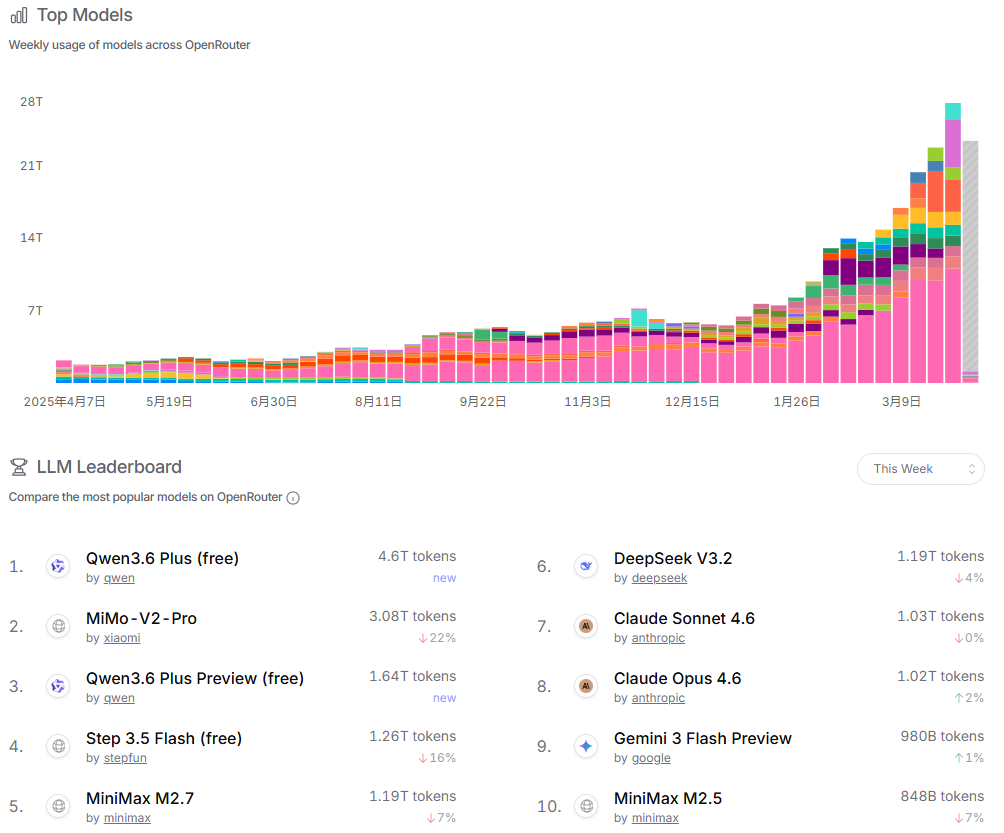
在[1]中列出了全球TOP大模型产品,可以看到国外Gemini、GPT和Claude,国内的MiniMax、MiMo、Kimi、Qwen和DeepSeek等产品。
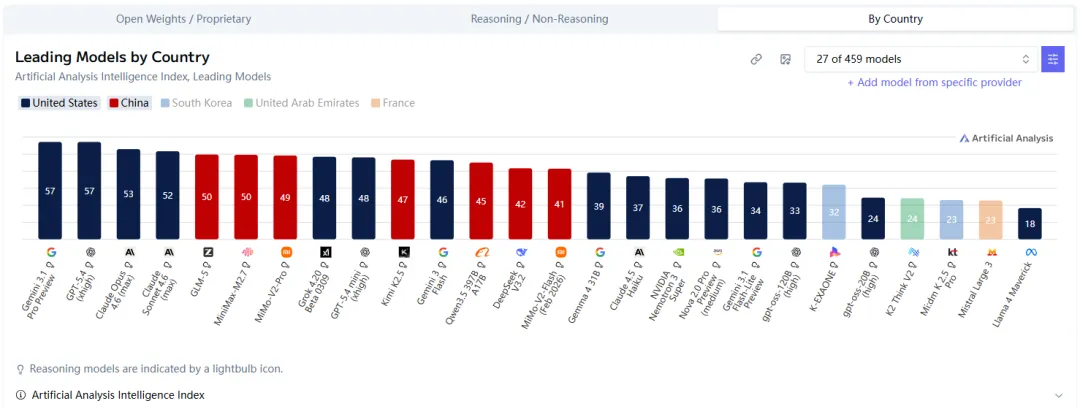
1、国外主流的大模型产品
美国作为本轮AI浪潮的发源地,凭借其深厚的基础科研实力、强大的资本市场支持以及顶尖的人才储备,在核心模型的技术创新上保持着领先地位。以OpenAI、Google、Meta、Anthropic为代表的头部厂商,持续在模型规模、多模态能力和通用智能(AGI)的探索上刷新纪录。美国的产业特点更侧重于打造通用性极强的“平台型”基础大模型,并通过API接口、插件系统和开发者社区,构建一个庞大而繁荣的生态系统,赋能全球开发者和企业进行上层应用创新。
1)OpenAI:OpenAI的产品线明确划分为"通用快思考"(GPT系列)和"深度推理慢思考"(o系列)两类

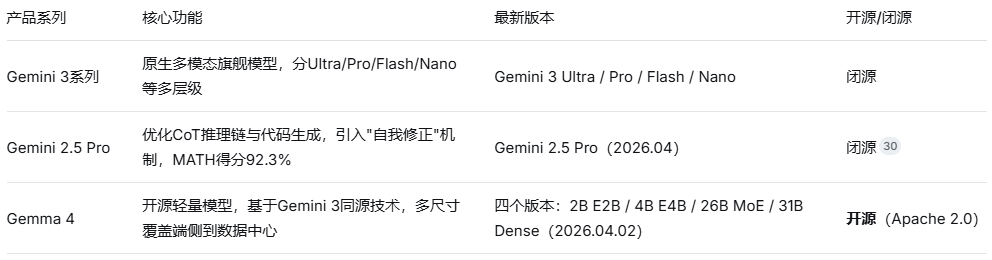
2)Google/DeepMind:Gemini 3是Google的闭源旗舰,通过分层设计覆盖从高复杂度到边缘计算的全场景;Gemma 4 则被称为"迄今最强的开源小模型"。
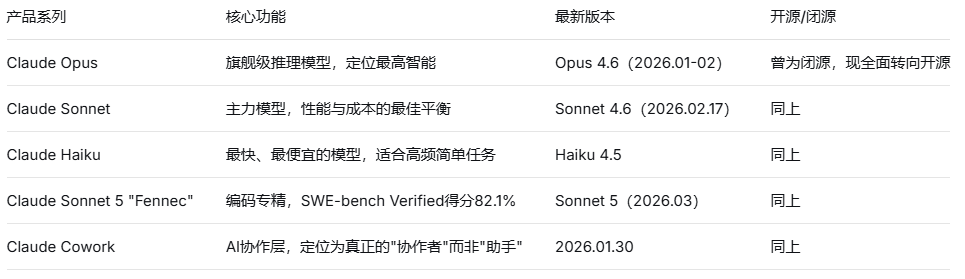
3)Anthropic:Anthropic的Claude系列在开发者社区和文字工作者中拥有极高口碑,尤其在代码生成、Bug修复和长篇写作方面被公认为行业顶尖
4)Meta:Meta的Llama系列曾是全球开源大模型的标杆,但在2025年的争议之后,其战略正在发生重大转变。

5)xAI:xAI的Grok系列与X平台深度整合,以"最懂当下、最有个性的AI伙伴"为核心定位
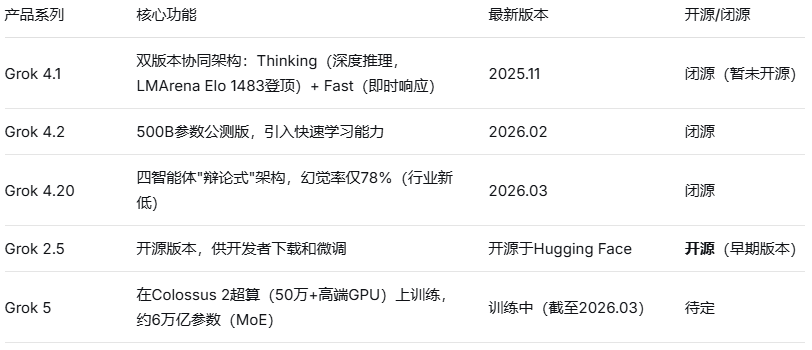
2、国内主流的大模型产品
国内则凭借庞大的数据资源、丰富的应用场景和积极的政策支持,迅速崛起为全球大模型领域的另一极。以阿里巴巴、字节、腾讯、百度、DeepSeek等为代表的中国厂商,在快速跟进国际前沿技术的同时,更展现出强大的应用落地能力 。中国的产业特点是“技术与应用”双轮驱动,更加侧重于将大模型技术与具体行业(如金融、医疗、教育、制造)深度融合,开发垂直领域的解决方案,并催生了大量面向消费者的AIGC内容应用。
1)阿里巴巴:千问系列覆盖文本、视觉、代码、视频、翻译等全模态。Qwen3.5-Plus于2026年2月发布,采用MoE架构,总参数3970亿,激活仅170亿;Qwen3.5-Max-Preview于2026年3月19日发布。
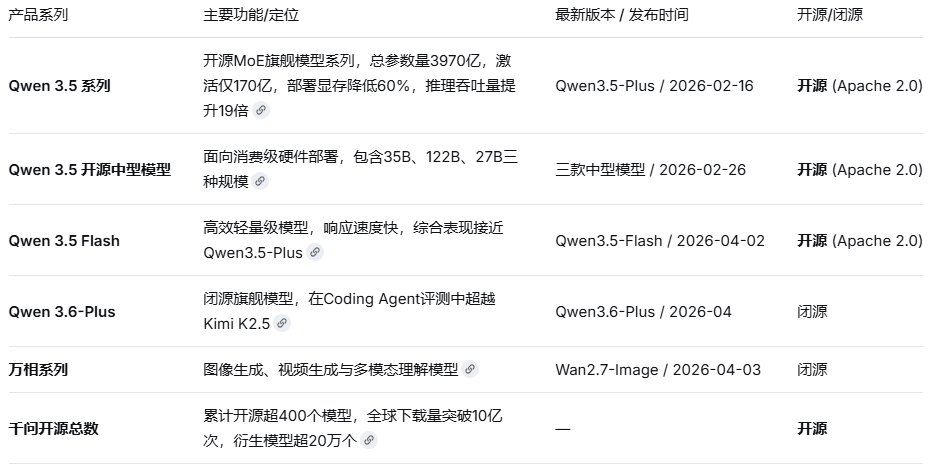
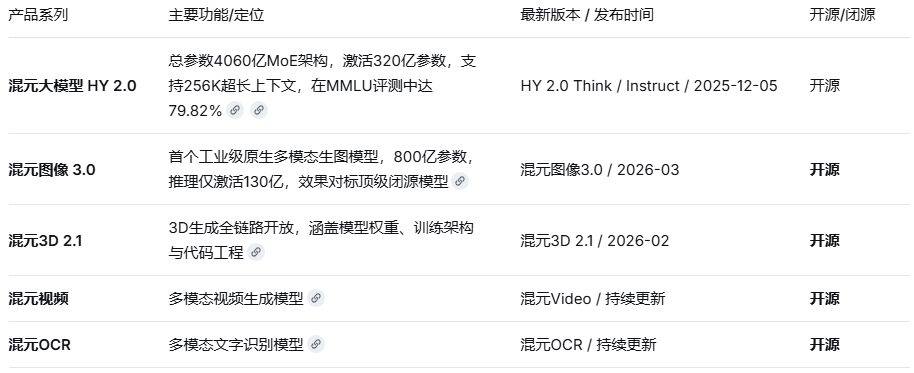
2)腾讯:混元模型在多模态领域发力
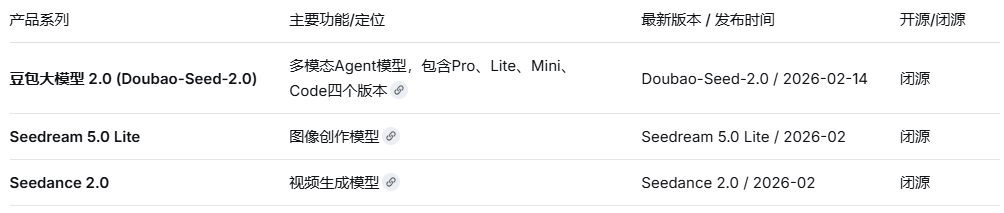
3)字节:豆包2.0 于2026年2月14日发布,包含Pro、Lite、Mini三款通用Agent模型和一款Code模型;Seedance 2.0视频生成模型发布后性能已“遥遥领先”。
4)百度:文心系列,2026年1月22日发布文心5.0,采用原生全模态统一建模技术
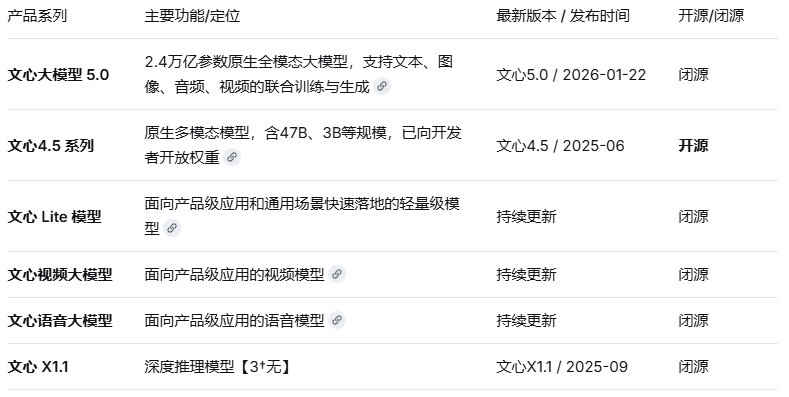
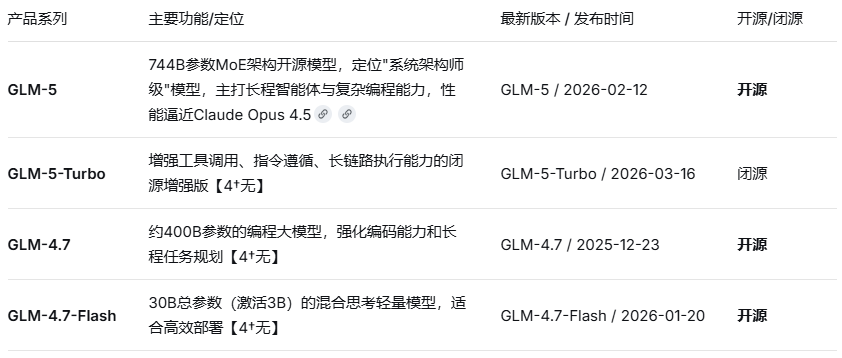
5)智谱AI:2026年2月12日开源GLM-5,744B参数,在权威编程基准测试中取得开源模型最高分,性能逼近顶级闭源模型Claude Opus 4.5
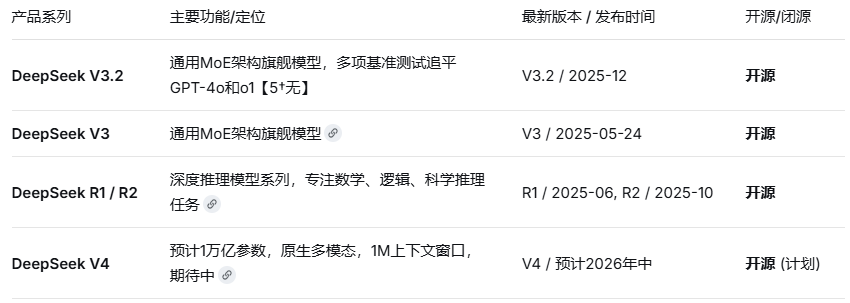
6)DeepSeek:DeepSeek-V3.2引入了DeepSeek稀疏注意力机制,大幅降低长文本推理成本
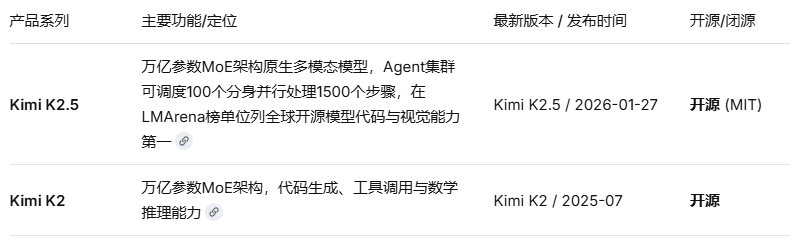
7)月之暗面:2026年1月27日发布Kimi-2.5,核心亮点是Agent集群功能
8)MiniMax:2026年3月18日发布M2.7,首次展示 “模型自我进化” 路径
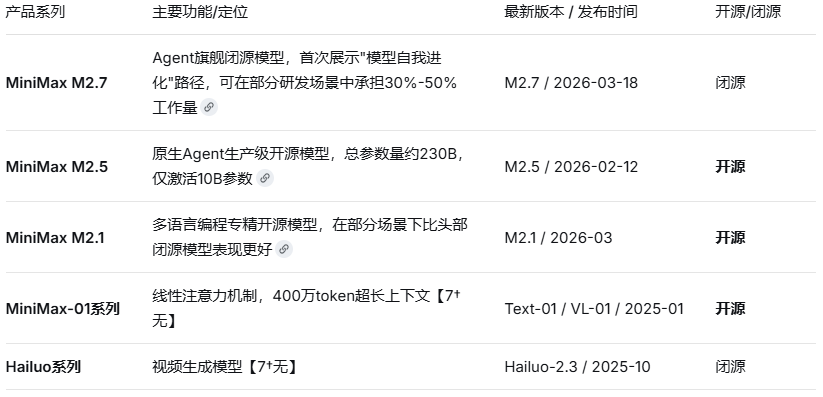
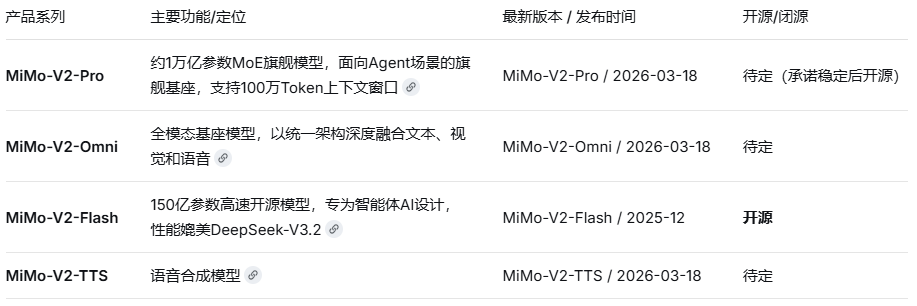
9)小米:推出了MiMo系列,2026年3月18日发布MiMo-V2-Pro,约1万亿参数,支持100万Token上下文窗口
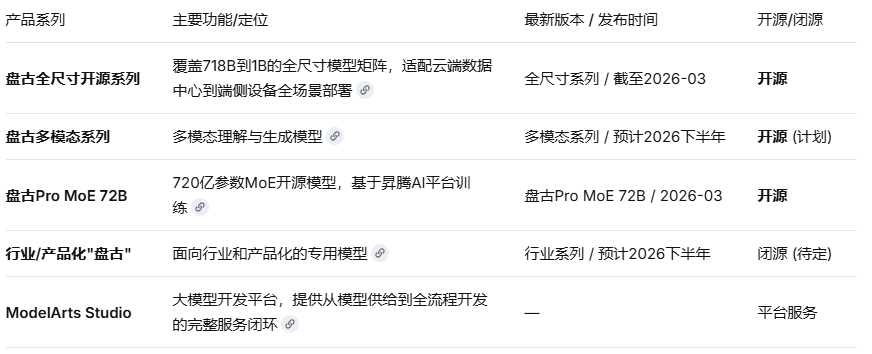
10)华为:以盘古大模型为核心,开源从718B到1B的全尺寸模型矩阵
3、大模型能力评测
1)大模型综合评测性能
在SuperCLUE中文大模型基准测评[2]中,测评涵盖了数学推理、科学推理、代码生成、精确指令遵循、幻觉控制、智能体(任务规划)六大任务,其中数学推理、科学推理、代码生成为推理能力,精确指令遵循、幻觉控制、智能体(任务规划)为应用能力。本次测评共702道新题,共测评22个国内外大模型。

2)全球API调用量排名:国内模型集体崛起
以全球最大AI大模型API聚合平台OpenRouter(数据截至2026年4月6日)的口径来看[3],全球调用量排名前六均为中国AI大模型。
参考资料:
-
https://artificialanalysis.ai/
-
https://www.superclueai.com/homepage
-
https://openrouter.ai/rankings