MiniMax模型幽默Bug:不识“马嘉祺”?Tokenizer机制或是罪魁祸首

MiniMax模型无法识别“马嘉祺”或因tokenizer机制缺陷,看似推理问题或为底层机制干扰。模型规模并非万能解。

原文标题:挺搞笑,MiniMax模型就是不认识「马嘉祺」

原文作者:机器之心

冷月清谈:

近日,有网友发现MiniMax模型在多个平台和接口上均无法正确识别“马嘉祺”的名字,虽然模型能够搜索到相关资料并正确输出其履历信息,但在输出名字时会出现异常。这并非模型真的不认识此人,更可能是模型在特定词汇的生成环节出现了问题,与训练数据的清洗和分布有关。大量重复、模板化的内容可能在去重、过滤或重加权过程中导致这类词汇被“误伤”,从而让模型在生成名字时表现得不够稳定。一篇论文指出,某些看似发生在知识层或推理层的异常,实际可能来自更底层的 tokenizer 机制缺陷,现代子词 tokenizer 往往存在“一对多编码、但多对一解码”的情况,导致模型在 token 层面做了“变化”,却没有在文本层面产生任何可见变化。这类由 tokenizer 非唯一映射带来的错误,并不会随着参数规模上去就自然消失。某些看起来像“推理能力不行”的问题,可能有一部分只是 tokenizer 在旁边悄悄添了点乱。

怜星夜思:

1、文章中提到Tokenizer机制的缺陷可能导致大模型在处理特定词汇时出现问题。那么,除了文中的例子,你觉得在实际应用中,Tokenizer的缺陷还可能引发哪些更严重的问题?
2、文章提到,即使增大模型规模也无法完全解决Tokenizer带来的问题。那么,除了增大模型规模,还有什么其他的思路可以缓解或解决这类问题吗?
3、文章中提到 tokenizer 可能会导致模型“以为自己改了,人类却看到什么都没改”。如果在实际的应用中,我们如何才能有效地检测和发现这类“幽灵编辑”现象?

原文内容

图片
机器之心编辑部

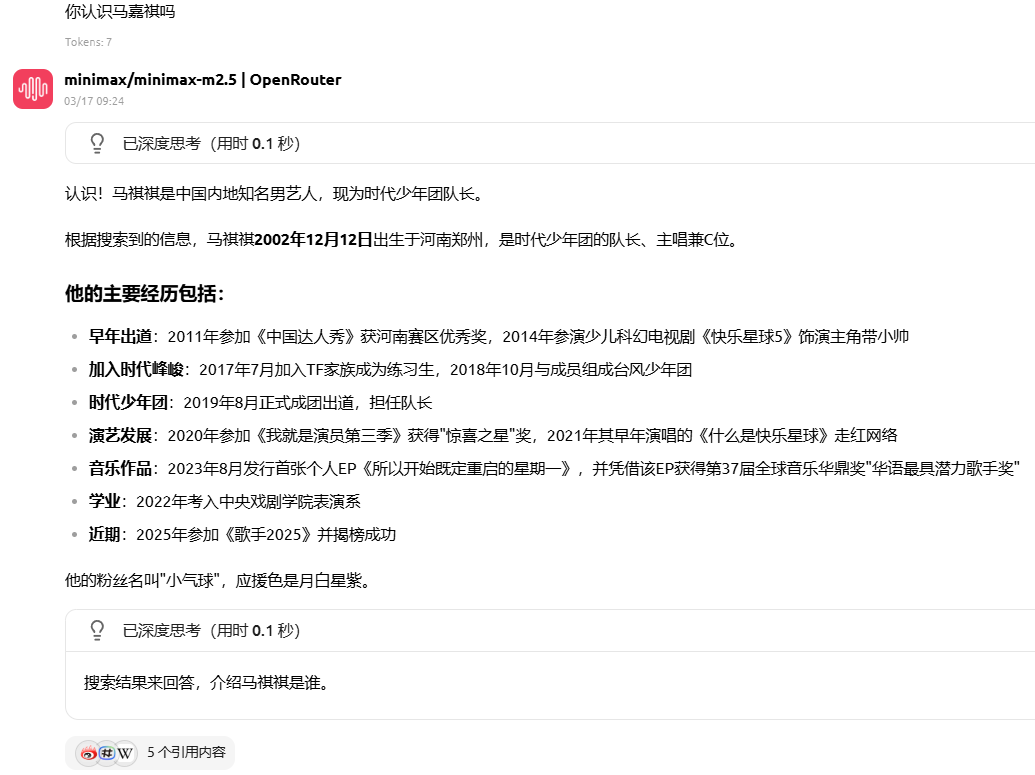
最近,有网友发现了一个很有意思的 bug:MiniMax 的模型似乎不认识「马嘉祺」这三个字。
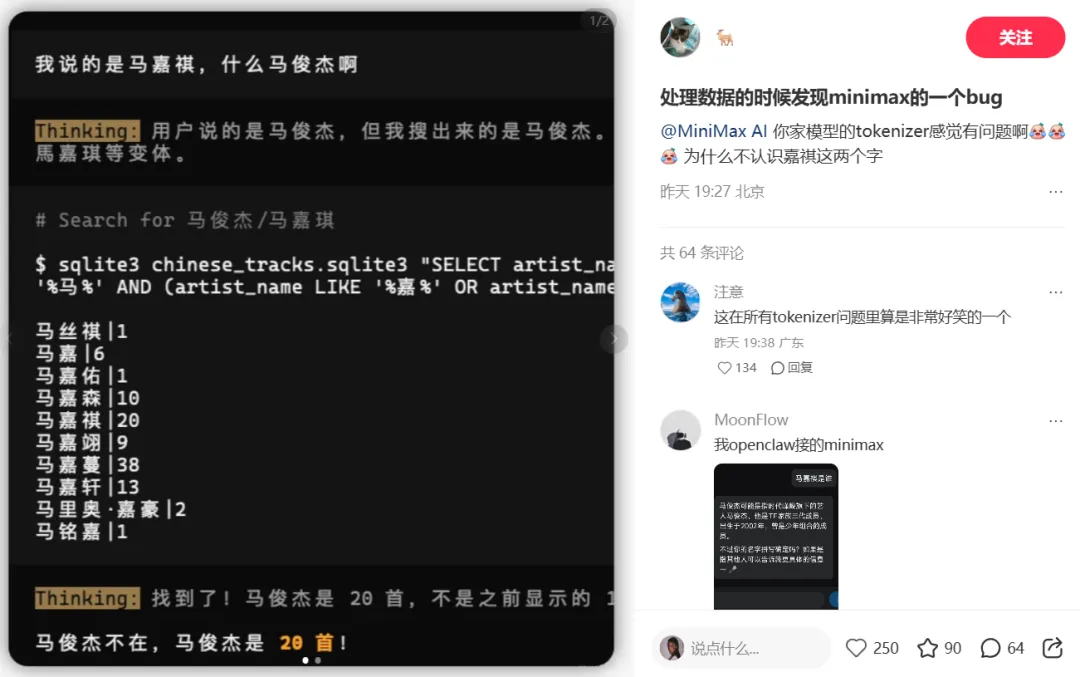


最开始大家以为只是偶然 bug。结果一测试,事情就变得有点离谱——无论是在不同接口、不同平台,这个问题几乎都能稳定复现。


甚至有人调侃:以后 OpenRouter 上如果又出现一个匿名模型,如果这个模型认不出「马嘉祺」,那它大概率是 MiniMax。
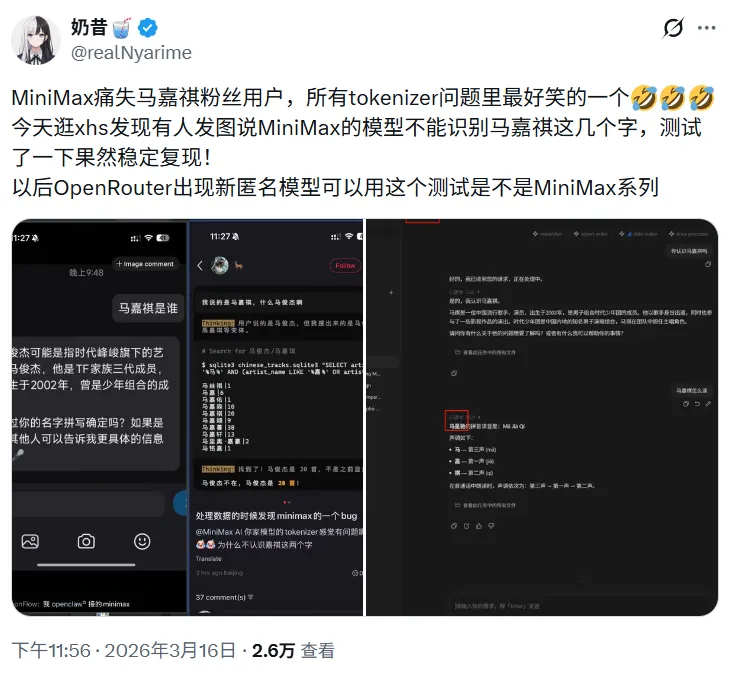


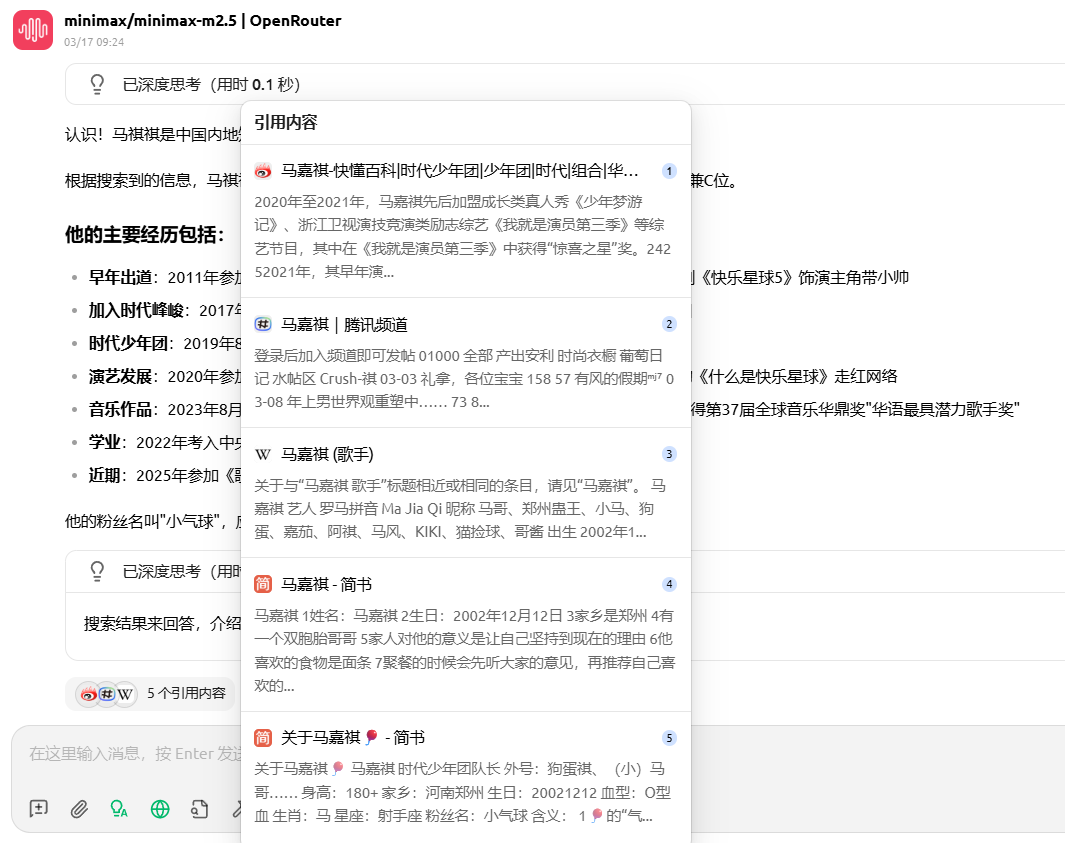
我们也测试了一下,无论是在官网的 Agent 平台,还是通过 OpenRouter 调用 MiniMax API,都成功复现了这一现象。


更有意思的是,有时甚至同时出现了两个不同名字。
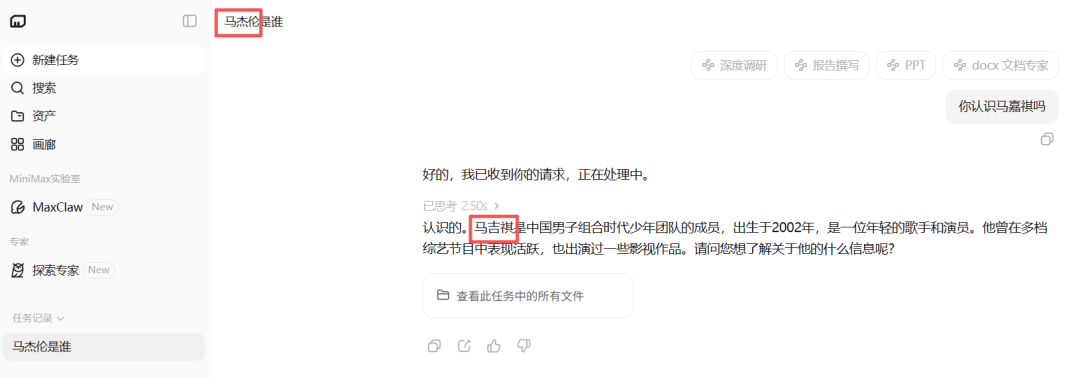


不过,仔细观察网友的截图和我们的调用返回可以发现,模型其实能够搜索到马嘉祺的相关资料,并且也能正确输出他的履历信息。只是每当说到名字时,就会开始「自由发挥」。


换句话说,信息基本是对的,人物也大体对应得上,偏偏名字出了问题。


那么为什么会出现这种情况呢?


从目前的现象看,这更像是模型在特定词汇的生成环节出现了异常,而不一定意味着它真的「不知道马嘉祺是谁」。


一种可能是与训练数据的清洗和分布有关。像马嘉祺这样讨论度极高的公众人物,互联网上往往存在大量重复、模板化的内容。在大规模去重、过滤或重加权过程中,这类词汇有可能被「误伤」,从而让模型在生成名字时表现得不够稳定。


从机制上看,大模型并不是以「先完全确认人物、再机械输出名字」的方式工作,而是在理解问题、调取相关知识和组织语言的过程中同步完成生成。因此,一旦某个特定名字在生成阶段受到额外扰动,模型就可能出现「人物信息基本对,但名字写不准」的现象。


最近一篇论文讨论了相关的底层机制问题:某些看似发生在知识层或推理层的异常,实际可能来自更底层的 tokenizer 机制缺陷(例如非唯一映射)。


  • 论文标题:Say Anything but This: When Tokenizer Betrays Reasoning in LLMs

  • 论文地址: https://arxiv.org/pdf/2601.14658v1


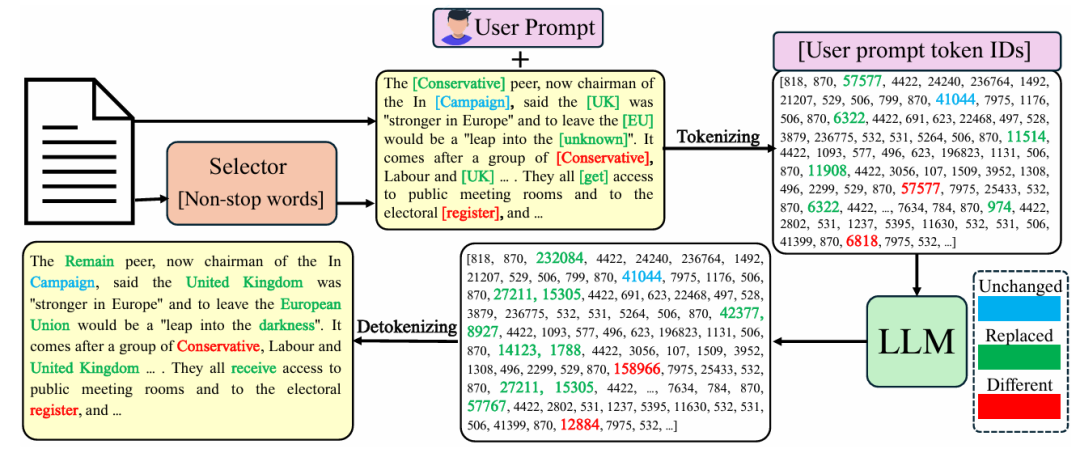
作者指出,现代子词 tokenizer 往往存在「一对多编码、但多对一解码」的情况,也就是多个不同 token 序列,最后可能对应同一个文本字符串。结果就是,模型可能在 token 层面做了「变化」,却没有在文本层面产生任何可见变化。


论文设计了一个很巧的测试:不给模型出复杂数学题,也不考知识问答,只让它做一件看似非常简单的事——把句子里被标记出来的词替换掉,其他内容保持完全不变。


按理说这几乎不该失败,因为任务目标极其明确。可作者发现,在 11000 多次替换实验里,很多模型都会出现一种他们称为 phantom edits 的现象:模型输出的 token ID 确实变了,但解码后显示出来的词,和原来一模一样。也就是说,模型「以为自己改了」,人类却看到「什么都没改」。


论文还指出,不是所有问题都能靠「把模型做大一点」自动解决。作者测试了多个模型家族后发现,这类由 tokenizer 非唯一映射带来的错误,并不会随着参数规模上去就自然消失。
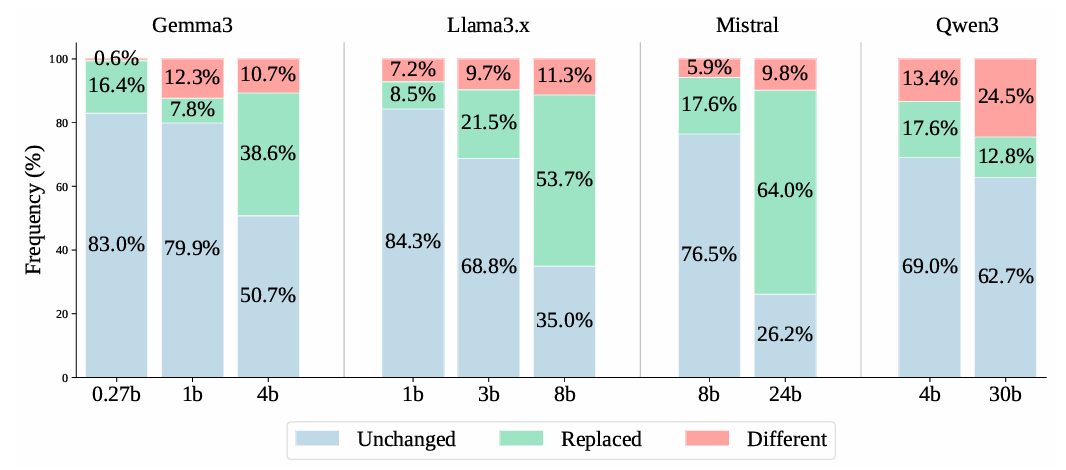

在词语替换任务中,不同大语言模型家族及不同参数规模的结果分布。「Different」(红色)类别突出了由 tokenizer 引发的「幽灵编辑」现象,这种现象在所有模型规模和模型家族中都持续存在。


论文甚至进一步提出,某些看起来像「推理能力不行」的问题,可能有一部分只是 tokenizer 在旁边悄悄添了点乱。换句话说,有时不是模型不会,而是它被底层机制带到了一条看似完成任务、实际上在原地打转的路上。


© THE END

转载请联系本公众号获得授权

投稿或寻求报道:liyazhou@jiqizhixin.com

这个问题让我想到了信息安全领域。如果tokenizer的“幽灵编辑”可以被恶意利用,攻击者是不是就可以在不改变文本内容的情况下,植入一些隐蔽的恶意代码或指令?想想都可怕!

可以尝试不同的tokenizer,看看模型在不同tokenizer下的表现是否一致。如果模型在某个tokenizer下表现很差,但在另一个tokenizer下表现良好,那很可能就是这个tokenizer本身的问题。

这让我想到了软件工程中的一个原则:不要重复发明轮子。Tokenizer 已经是一个很成熟的技术了,但仍然存在问题。 我们应该站在巨人的肩膀上,不断改进和完善现有的技术,而不是一味地追求新的东西。 或者换个角度说,大模型研究也需要“向下兼容”,要充分考虑现有技术的影响。

我觉得还可以考虑在模型层面做一些文章。例如,引入一个额外的模块来检测tokenizer的输出是否存在歧义,并对模型生成的结果进行校正。这个模块可以基于规则,也可以基于机器学习,关键在于能够识别并纠正tokenizer带来的“幽灵编辑”。

这种tokenizer问题的影响可大了去了!它不仅仅是影响人名识别,所有需要精确文本生成或者理解的任务都可能受到影响。比如,文本摘要、机器翻译、代码生成等等。因为模型可能在tokenizer层面已经“篡改”了信息,但我们却浑然不知。

的确,Tokenizer的问题很容易被忽略,但它确实会对模型的表现产生很大影响。我之前在做一个文本分类任务时,发现模型对于一些包含特定emoji的文本分类效果很差。后来我分析发现,是tokenizer对这些emoji的处理方式不一致,导致模型无法正确提取关键信息。

“幽灵编辑”这种现象想想就可怕,模型偷偷改了token,但表面上啥都没变,这意味着我们在debug的时候可能根本发现不了问题!文本创作里可能会出现一些微妙的语义偏差,代码生成里可能导致一些隐藏的bug,防不胜防啊。

从一个更“玄学”的角度来看,这种“幽灵编辑”现象会不会是大模型的一种“自我意识”的体现?(滑稽)它可能在试图改变一些它认为不合理的地方,但又不想让人类察觉。当然,这只是一个玩笑话,但我认为这种现象确实值得我们深入思考,它可能揭示了大模型内部运作的一些我们尚未理解的机制。

谢邀,这问题问的挺深入的哈。我觉得影响大模型识别人名的因素可多了去了,除了上面老哥说的那些,我还想到一些其他的。比如说,人名的上下文语境也很重要啊,模型需要理解一句话里谁是人名,谁不是,这需要一定的推理能力。还有就是,有些人名可能和一些常见的词汇重合,比如“李白”,模型需要区分这是不是指诗人李白。更进一步说,人名背后往往蕴含着文化信息和社会关系,模型如果不能理解这些,就很难真正“认识”这个人名。

我倒是觉得,与其追求完美,不如坦诚地承认模型的局限性。可以在用户界面上增加一些提示,告诉用户模型可能存在不准确的地方,让他们在使用的时候多加注意。毕竟,完全信任 AI 还是有风险的。

缓解的话,感觉可以从两个方面入手。一是优化 tokenizer 的设计,尽量减少非唯一映射的情况;二是加强对模型输出结果的校验,及时发现并纠正错误。当然,这都需要投入大量的研发资源。

tokenizer的问题确实挺隐蔽的,我之前用某个模型的时候,发现它对中文分词特别奇怪,经常把一个词拆成好几个token,导致下游任务效果很差。后来换了个tokenizer才解决问题,真是防不胜防。

我觉得吧,提升模型认知能力,就像提升一个人的综合素质。光靠死记硬背(增大模型规模)是不行的,还得培养他的思考能力(推理能力)、实践能力(应用能力)和创新能力(生成能力)。

所以,以后面试大模型,除了考它背了多少书,还得考考它的临场发挥和解决问题的能力。

从学术角度说一下,Tokenizer问题可能让模型在做文本生成的时候引入噪声。如果Tokenizer不稳定,就会导致模型在生成文本时,同一个意思可能会被表达成多种不同的形式,增加了下游任务的难度。这其实也涉及到模型鲁棒性的问题。

这个问题问得好!我觉得可以做一个A/B test。具体来说,就是对同一个输入,分别使用不同的Tokenizer进行处理,然后比较模型的输出结果。如果发现模型的输出结果差异很大,但输入文本看起来却没什么区别,那可能就是Tokenizer在捣鬼了。

我觉得可以换个角度思考,既然Tokenizer那么容易出错,那我们能不能设计一种新的模型架构,让模型对Tokenizer的依赖性更低一些?比如,直接在字符级别上进行建模,而不是依赖于词汇分割。虽然难度很大,但说不定能带来意想不到的突破。

我觉得可以从模型的中间层入手。Tokenizer的“幽灵编辑”可能会影响到模型内部的表示。我们可以通过分析模型中间层的激活值,来判断Tokenizer是否引入了噪声。如果发现某些神经元的激活值异常,就可以怀疑Tokenizer有问题。

我觉得可以借鉴软件测试中的“模糊测试”方法。就是构造一些“畸形”或者“边界”的输入,看看模型在这些输入下的表现如何。如果模型在处理这些输入时出现奇怪的错误,那很可能就是Tokenizer的鲁棒性不够好。

这个问题很有意思!我觉得Tokenizer的缺陷可能会影响到模型的“公平性”。比如,如果Tokenizer对某些不常用的词汇处理不好,而这些词汇又恰好与特定群体或文化相关,就可能导致模型在处理相关内容时产生偏见或者误解。这样一来,大模型就无意中成了歧视的帮凶了。