Sand.ai 发布 MagiAttention v1.1.0:重新定义分布式 Attention 性能上限

Sand.ai 发布 MagiAttention v1.1.0,优化分布式 Attention 性能,适配 Blackwell 架构,提升超长序列训练扩展性,已应用于大规模视频生成和多模态大模型训练。

原文标题:Sand.ai重磅更新MagiAttention,正在定义分布式Attention性能新标杆

原文作者:机器之心

冷月清谈:

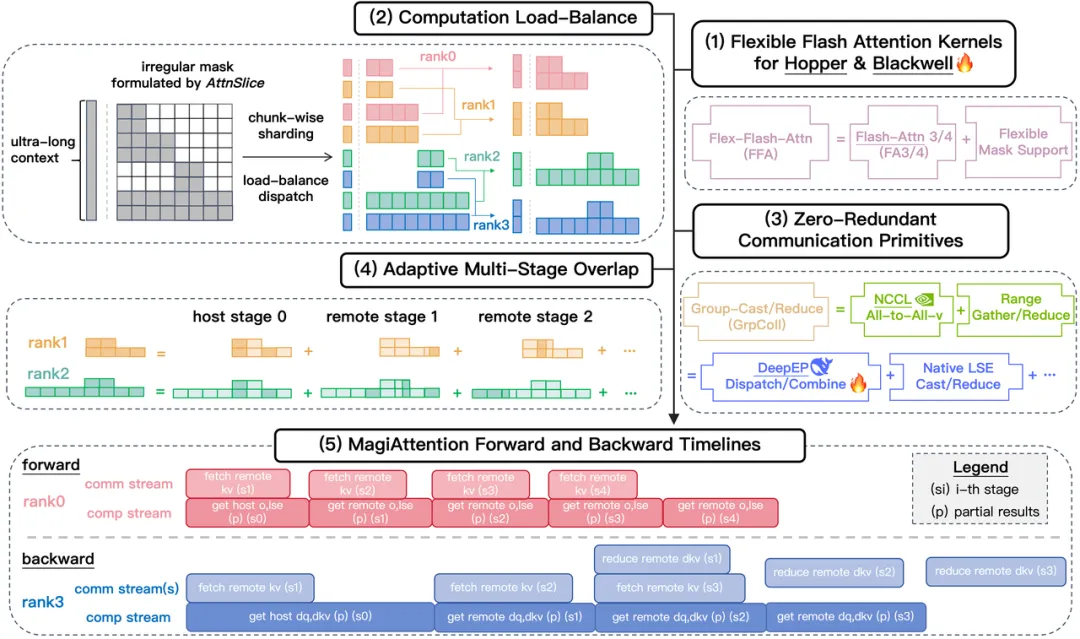
Sand.ai 发布 MagiAttention v1.1.0,该版本针对 Hopper 和 Blackwell 两代架构,着重优化了分布式 Attention 的性能。新版本引入了基于 Flash-Attention 4 的 FFA_FA4 后端,初步适配了 Blackwell 架构,支持灵活掩码,并开发了高效分块掩码生成算子,降低了性能开销和显存风险。此外,MagiAttention 构建了原生 Group Collective 通信内核,重塑了分布式 Attention 在节点内外的数据交换范式,通过算子级融合和 RDMA 传输去重,降低了跨机通信量,提升了性能。在系统级优化方面,MagiAttention 采用了 Dispatch Solver 和 Adaptive Multi-Stage Overlap 技术,实现了负载均衡和流水线阶段的自适应调整,为超长序列训练提供了线性扩展保障。MagiAttention v1.1.0 已经在 Magi-1 等大规模视频生成模型训练和多模态大模型训练中得到应用,并提供了详细的 Benchmark 结果。

怜星夜思:

1、MagiAttention v1.1.0 针对 Blackwell 架构的优化,除了文章中提到的,你认为还有哪些潜在的优化方向?
2、MagiAttention 提到的 Group Collective 通信内核,相较于传统的 AlltoAll-v 方案有哪些优势?在实际应用中,这种通信方式会带来哪些挑战?
3、MagiAttention 中 Dispatch Solver 使用的最小堆贪心算法,在保证负载均衡方面有哪些局限性?有没有其他更优的解决方案?

原文内容
图片
机器之心编辑部

2025 年 4 月,Sand.ai 开源了 MagiAttention v1.0.0,定义了下一代分布式 Attention 的全新设计和系统框架。历经一年的深耕,今天 Sand.ai 正式发布:MagiAttention v1.1.0,以更成熟的原生算子组件,重新定义 Hopper 与 Blackwell 两代架构分布式 Attention 的性能上限。


    • 代码仓库:https://github.com/SandAI-org/MagiAttention

    • 使用文档:https://sandai-org.github.io/MagiAttention/docs

    • 技术博客:https://sandai-org.github.io/MagiAttention/docs/main/blog/magi_attn


    Blackwell 新架构适配:释放下一代算力红利


    为了在下一代硬件上延续 Flex-Flash-Attention (FFA) 的灵活性,研发团队引入了基于 Flash-Attention 4 的 FFA_FA4 后端,完成了对 Blackwell 架构的初步适配:


    • 灵活掩码支持:引入 HSTU Function 表达,在无需大幅改动 FA4 内核主体逻辑的前提下,实现了对任意掩码的无缝兼容,且性能损耗 < 5%。

    • 高效分块稀疏生成:开发了高效分块掩码生成算子,大大降低了 FlexAttention 实例化完整掩码的性能开销和显存风险。

    • R2P 指令级加速:我们利用 Register-to-Predicate 技巧,将复杂的边界检查映射为单条硬件指令,大幅降低了指令周期。

    • 极致显存和延迟:针对超长序列,对掩码元数据进行 CSR 压缩,对内核启动进行 FFI 加速,确保显存与延迟的双重极致。


    原生 Group Collective 原语:突破 RDMA 带宽瓶颈


    跨机通信效率决定了分布式扩展上限,受 DeepEP 启发,Sand.ai 构建了原生 Group Collective 通信内核,彻底重塑了分布式 Attention 在节点内外的数据交换范式:


    • 算子级融合:研发团队将数据重排直接融合进通信算子,显著降低了访存和额外拷贝开销。

    • RDMA 传输去重:以 "NVLink 替代冗余 RDMA" 传输,实现节点间单次物理交换与节点内高效转发和规约,跨机通信量降低数倍,性能远超传统 AlltoAll-v 方案。


    系统级协同优化:负载均衡与多阶段重叠


    MagiAttention 的卓越性能不仅源于算子端的极致打磨,更得益于系统级的全栈协同调度和全场景通用的启发式算法:


    • Dispatch Solver: 基于最小堆贪心算法,实现序列的细粒度分配,保证任意掩码下设备的计算负载均衡,避免 “短板效应” 拖垮分布式整体性能。

    • Adaptive Multi-Stage Overlap: 突破静态流水线限制,自适应调整流水线阶段,通过最小化调度开销实现极致重叠,为超长序列训练提供线性扩展保障。


    实测表现与应用


    目前,MagiAttention v1.1.0 已在 Magi-1 等大规模视频生成模型训练中得到实证,也在各大厂中被 “悄悄” 应用于多模态大模型训练。为了验证 MagiAttention 在真实长文训练中的表现,Sand.ai 也给出了细致的 Benchmark 结果:


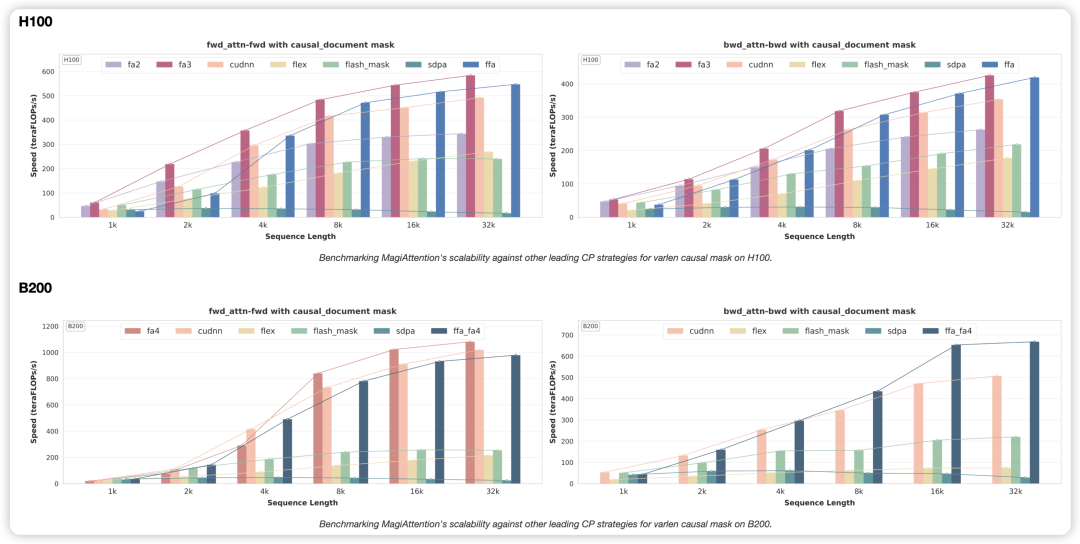
    • 算子层面:支持灵活掩码并维持 SOTA 性能


    H100/B200 Varlen Causal 掩码下前反向的内核算子性能对比


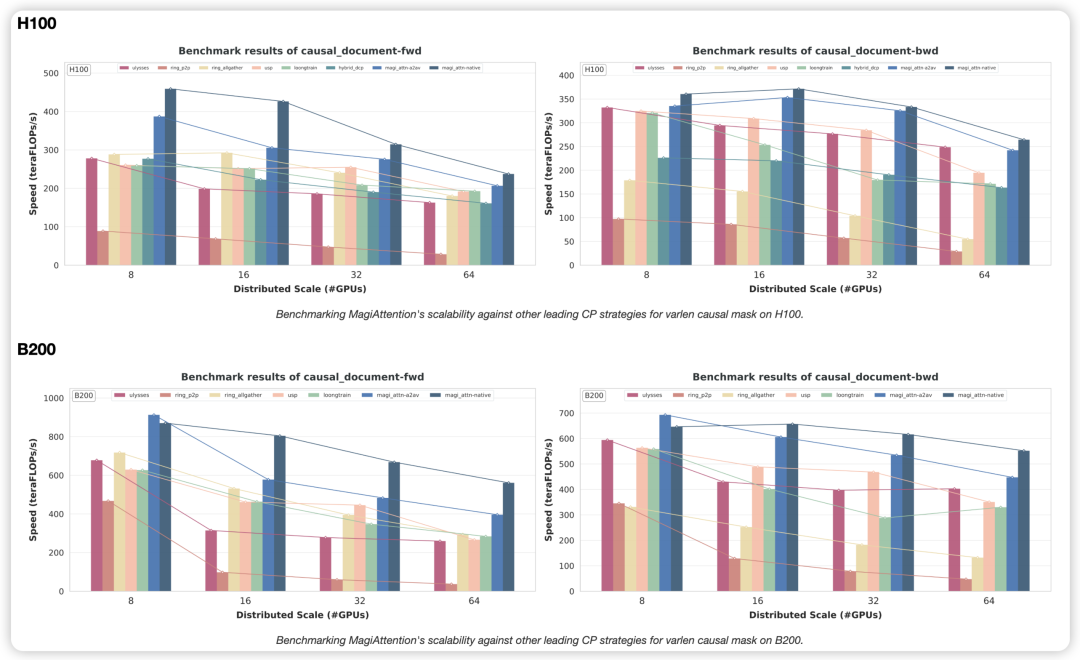
    • 分布式层面:重塑超长序列的扩展性曲线


    H100/B200 Varlen Causal 掩码下前反向的分布式性能对比


    结语与未来展望


    自去年 v1.0 发布以来,Sand.ai 收到的社区反馈让研发团队更加坚定:只有将底层算力压榨到极限,才能开启人工智能处理复杂多模态任务的新篇章。MagiAttention v1.1.0,是 Sand.ai 向这一愿景迈进的关键一步。Sand.ai 相信,强大的模型能力必须建立在普惠且极致的技术基石之上。


    了解更多信息,欢迎访问 Sand.ai 官网:https://sand.ai


    © THE END

    转载请联系本公众号获得授权

    投稿或寻求报道:liyazhou@jiqizhixin.com

    这个问题很有意思!我的理解是,传统的 AlltoAll-v 方案在节点间通信时,数据可能需要经过多次 RDMA 传输才能到达目标节点,导致带宽浪费和延迟增加。而 ‘NVLink 替代冗余 RDMA’ 方案,应该是利用 NVLink 的高速互联特性,直接在支持 NVLink 的节点间进行数据传输,避免了不必要的 RDMA 转发,从而提升了通信效率。至于解决了哪些痛点,我觉得主要是解决了带宽瓶颈和延迟问题,让节点间通信更快更直接。

    这个问题问到了点子上! 要在不改动内核主体逻辑的前提下实现任意掩码兼容且保证性能,我认为 HSTU Function 的关键在于它将掩码的处理巧妙地融入了现有流程,可能是在 Kernel 外部通过预处理或者后处理的方式实现掩码的逻辑,而不是直接在 Kernel 内部进行修改。 这样既避免了修改底层代码带来的风险,又保证了性能。 性能损耗 < 5% 说明 HSTU Function 的效率非常高,对整体计算流程的影响很小。

    从理论上讲,Group Collective 的优势毋庸置疑,但在实际应用中,需要考虑集群的拓扑结构、网络带宽、节点性能等因素。如果集群规模较小,或者网络带宽足够高,AlltoAll-v 可能更加简单高效。

    此外,Group Collective 的实现复杂度较高,需要深入了解底层通信机制,才能进行优化。

    Group Collective 相当于更智能的快递分发系统!

    传统的 AlltoAll-v 就像是每个人都给所有人寄一份快递,效率很低。Group Collective 则是把人分组,组内先整合,然后再在组间传递,减少了冗余数据。

    优势很明显:

    * 减少通信量: 通过组内规约和去重,大大降低了网络传输的数据量。
    * 提高带宽利用率: 避免了 AlltoAll-v 的拥塞,提高了带宽利用率。

    挑战也存在:

    * 分组策略: 如何合理分组,使得组内通信效率最高,是个难题。
    * 同步开销: 组间通信需要同步,同步开销可能会抵消部分优势。
    * 容错性: 如果某个节点故障,可能会影响整个组的通信。

    最小堆贪心算法就像一个永远想让大家“雨露均沾”的老好人,但有时候会顾此失彼。

    局限性在于:

    * 局部最优: 贪心算法只考虑当前最优,不保证全局最优,可能导致某些设备一直处于高负载状态。
    * 忽略通信开销: 最小堆只考虑计算负载,忽略了数据传输的开销,可能导致数据频繁在设备间迁移。

    更优方案?我觉得可以考虑:

    * 动态规划: 可以找到全局最优解,但计算复杂度较高,适合小规模问题。
    * 强化学习: 通过不断试错,学习到一个较好的负载均衡策略,但需要大量的训练数据。
    * 结合先验知识: 结合模型的结构、数据分布等先验知识,设计更加精细的负载均衡策略。

    我觉得文章中提到的 Dispatch Solver 其实是工程上的一个折中方案,在性能和复杂度之间找到了平衡。要追求绝对的负载均衡,可能需要付出更高的代价。

    另外,实际应用中,硬件环境的差异、数据分布的不均匀等因素都会影响负载均衡的效果,很难找到一个完美的解决方案。

    其实吧,我觉得与其追求完美的负载均衡,不如把精力放在提升整体的性能上。就算某些设备负载高一点,但是如果整体速度更快,那也是值得的。所以,关键还是看整体的效率。

    谢邀,人在实验室,刚摸完鱼。

    Blackwell 架构的潜力远不止于此。个人认为,未来的优化方向可以聚焦在以下几点:

    1. 更高级的量化技术: 探索 INT4 甚至更低位宽的量化方案,在保证模型精度的前提下,大幅降低计算和存储需求。
    2. 异构计算支持: Blackwell 架构的 CPU 和 GPU 协同能力更强,可以考虑将部分计算任务卸载到 CPU 上,实现更高效的异构计算。
    3. 动态稀疏化: 根据输入数据的不同,动态调整 Attention 矩阵的稀疏程度,进一步减少计算量。

    当然,这些都需要深入研究 Blackwell 架构的底层机制才能实现。

    我理解 Group Collective 就像是搞了个“拼多多”模式的通信,人越多优势越大。但是!如果网络不好,或者搞不好分组,那可能还不如直接单发呢。所以说,具体问题还得具体分析。