LabBuilder将实验协议、安全约束与机器人导航统一进3D实验室生成流程。
冷月清谈:
怜星夜思:
2、从仿真布局走向真实实验室时,最难解决的会是导航、机械臂操作,还是安全监管?
3、如果要让同一间实验室支持多个实验协议,布局优化应优先追求平均效率,还是保障最危险流程的安全冗余?
4、只有30个标注实验协议,足以证明LabBuilder能泛化到更复杂的真实科研环境吗?
原文标题:ICML 2026丨从一句实验描述到安全3D实验室,LabBuilder实现协议驱动的实验室布局自动生成
原文作者:数据派THU
原文内容
来源:ScienceAI本文约3000字,建议阅读5分钟分层布局优化与导航验证协同工作,构建完整的生成与评估流程。
自动化实验室有望大幅加速科学研究进程,但虚拟实验环境的设计仍是制约其规模化部署的核心难题。现有 3D 场景生成方法大多面向家居场景,针对科研实验室的适用性存在明显局限。
现有方法在三个方面存在根本性不足:其一,缺乏对实验协议的语义理解——实验室中仪器与试剂的种类和空间位置须服从具体化学反应流程的要求,而通用场景生成模型不具备这一能力;其二,化学安全约束被普遍忽略——易燃试剂与热源的空间距离、不相容化学品的隔离要求属于实验室布局的基本安全前提;其三,生成的布局不保证机器人可达性——自主机器人须能够按协议顺序无碰撞地到达各操作位,而这一需求在现有工作中普遍缺失。
更根本的问题在于,现有方法主要在生成阶段追求视觉合理性,将协议可行性和导航验证留待事后评估,导致视觉上合理的布局在实际使用中往往存在安全或功能缺陷。
针对上述问题,来自上海人工智能实验室、武汉大学、北航、北京大学、清华大学、上海交通大学、香港中文大学等机构的研究者联合提出了 LabBuilder 系统,该工作已被 ICML 2026 收录。
论文链接:https://arxiv.org/pdf/2605.02288
给定一段自由文本形式的实验描述,LabBuilder 可端到端地生成几何合规、化学安全且机器人可达的完整 3D 实验室布局,将协议驱动的实验室设计转化为全自动流程。
核心贡献
LabBuilder 的主要贡献体现在三个方面。
图 1:LabBuilder 系统概览。基于资产知识库与化学知识库合成实验协议,生成满足导航可行性、几何合规性与化学安全性的 3D 实验室布局。
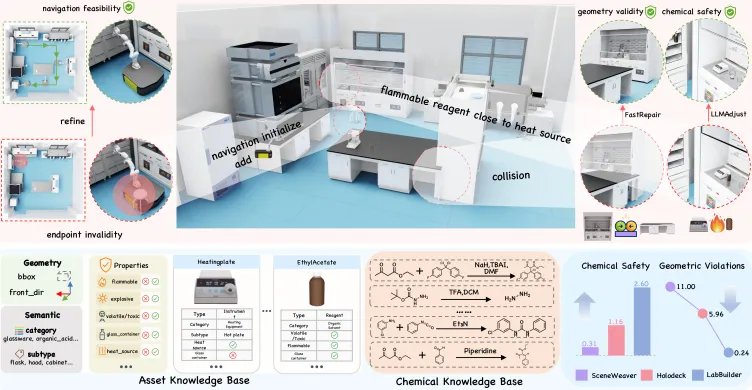
第一,构建了可扩展的元实验室数据集,包含资产知识库(Asset Knowledge Base)和化学知识库(Chemical Knowledge Base),为协议理解与安全验证提供知识基础。
第二,提出了 LabGen 层次化布局生成框架,在几何合规、化学安全和机器人可达性约束下生成协议驱动的实验室布局,性能明显优于现有方法。
第三,建立了 LabTouchstone 评估基准,从几何合规性、可行性成功率、化学安全性和语义合理性四个维度系统评估实验室布局,提供标准化的跨方法比较平台。
方法详解
图 2:LabBuilder 框架结构。LabForge 构建知识库并合成结构化协议,LabGen 通过层次化初始化、几何与化学优化、导航感知优化三阶段生成实验室布局。
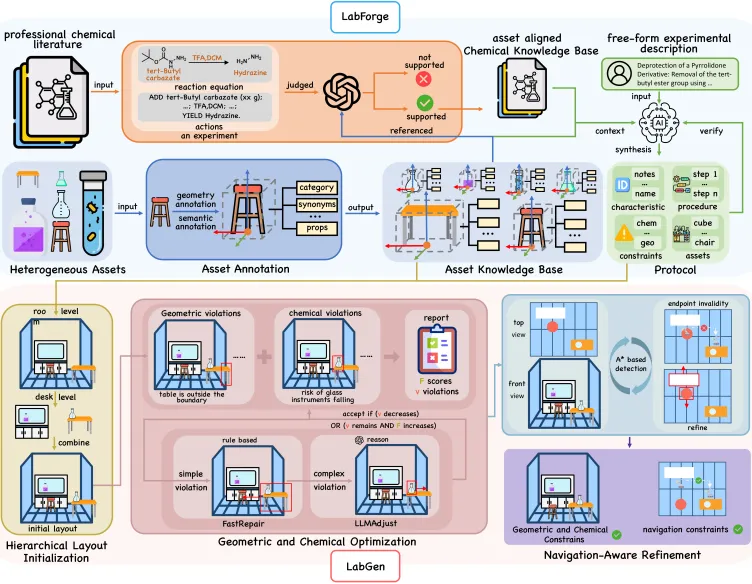
LabBuilder 由三个模块组成,分别负责资产与协议编译、布局生成与优化以及评估验证。
LabForge:资产与协议编译器
LabForge 负责知识库构建与协议合成两项核心功能。
知识库方面,系统整合了两个互补的知识来源:资产知识库(Asset Knowledge Base)收录 176 类实验室实体,每项资产均标注几何属性、语义类别和化学危害属性(包括可燃性等级、不相容化学品列表等),覆盖试剂、仪器和实验耗材等完整品类;化学知识库(Chemical Knowledge Base)从真实实验数据集中提取化学语义,涵盖取代、环化、氧化还原、官能团转化、缩合、烷基化六类反应类型,为安全约束提供化学依据。
协议合成方面,LabForge 以 LLM 为核心,将自由文本形式的实验描述编译为结构化协议,输出包含操作步骤序列、所需资产清单和安全约束集合的标准格式。在 30 个标注实验中,每个协议平均包含 5.27 种试剂、9.87 种仪器、9.00 个操作步骤和 4.30 个导航动作,体现了实验室场景在资产种类和操作流程上的复杂性。
LabGen:层次化布局生成与优化
LabGen 采用分阶段生成与迭代优化的流程,确保生成的布局同时满足安全性和机器人可达性要求。
布局初始化阶段将生成过程分为两个层级:房间级分区(Room-Level Zoning)负责识别协议所需的功能区域,确定各区域的 6-DoF 位姿并完成空间分配;桌面级摆放(Desktop-Level Organization)在边界约束和无重叠约束下,将协议相关资产填充到各操作台面,形成候选初始布局。
几何与化学联合优化阶段以多目标奖励函数 F 为优化目标,综合衡量几何有效性(边界及碰撞约束)与化学安全性(基于危害标注的约束满足率)。优化过程结合两种互补机制:FastRepair 负责快速修复几何边界冲突和碰撞问题,LLMAdjust 则调用 LLM 对安全性和工作流约束进行精细调整。两种机制在房间级和桌面级交替执行,直至收敛或达到最大迭代次数。
导航感知阶段将 3D 场景投影为 2D 占用栅格并施加障碍膨胀,以 A* 算法对每个协议步骤的路径可行性进行验证,识别端点无效、边界违规和路径不可达三类失败情形。对存在导航失败的场景,系统迭代调用优化算子进行调整,直至所有导航约束满足或达到迭代上限。
LabTouchstone:四维评估体系
LabTouchstone 从四个维度量化实验室布局质量:几何合规性(Obj↑、OB↓、CN↓)、可行性成功率(FSR,包括资产可用性 Asset↑ 和协议级导航可行性 Nav↑)、化学安全性(Flam↑、Store↑、Incomp↑、Glass↑)以及语义合理性(Real↑、Lay↑、Comp↑,基于 LLM 评分)。该体系还支持基于协议推导的点目标导航评估,为跨方法比较提供标准化量化依据。
实验结果
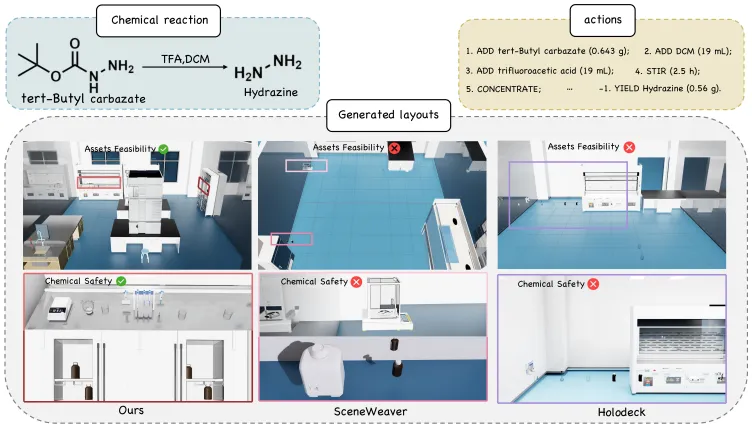
图 3:与现有方法的定性对比(以同一化学反应为例)。绿色标记表示通过检查,红色标记表示失败。
定量结果
表 1:30 个化学实验协议上的方法对比。从几何违规、可行性成功率、化学安全性及语义质量四个维度评估。
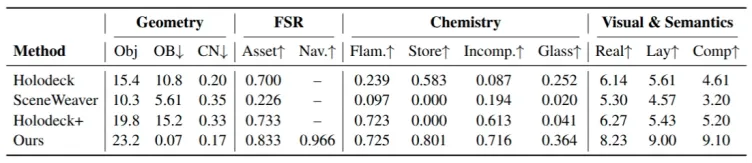
在 30 个化学实验协议上,LabBuilder与其余场景生成方法进行了系统对比,结果见上表。LabBuilder 在各项指标上均优于对比方法,是现有实验室场景生成的最佳方法。导航成功率(FSR-Nav)达 0.966,是唯一支持协议级导航验证的方案。
导航性能
表 2:生成场景中的点目标导航结果。导航感知优化后,两种规划器的成功率和路径质量均有明显提升。
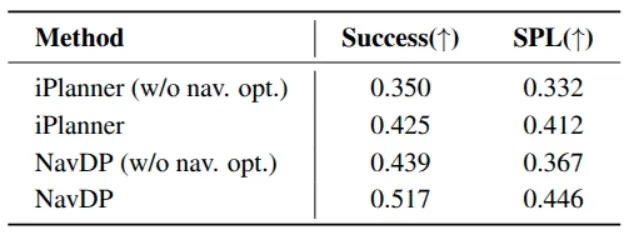
团队在 LabBuilder 生成的场景中,对 iPlanner 和 NavDP 两种规划器进行测试。导航感知优化后,两种规划器的成功率均有明显提升,表明 LabBuilder 生成的布局对自主机器人具有实际可用性。
消融实验
表 3:消融实验结果。「-」表示去除协议引导后导航指标不适用。
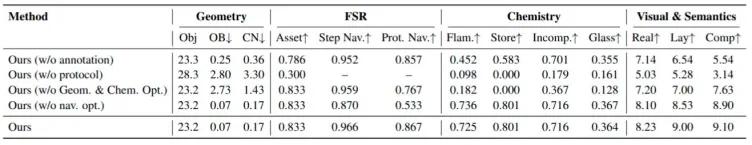
消融实验结果表明,各模块均对最终性能有实质性贡献。其中,去除协议引导造成的性能下降幅度最大:资产可行性(FSR-Asset)从 0.833 降至 0.300,完整性评分从 9.10 降至 3.14,说明正确的资产集合与约束引导是布局生成的前提。
去除几何与化学优化后,可燃物隔离(Flam)从 0.725 降至 0.182,不相容品分离(Incomp)从 0.716 降至 0.367,化学安全性显著下滑。去除导航感知优化主要影响协议级导航成功率(FSR-Nav 从 0.966 降至 0.870),对几何和化学指标影响较小,说明该模块的作用集中于导航可达性的保障。
局限与展望
LabBuilder 目前存在若干局限:尚不验证设备规格级要求(如加热范围、移液管容量、通风橱风量等),不涵盖机器人物理操控层面的可行性;暂不支持跨协议的多协议实验室设计;从仿真到真实场景的迁移问题有待进一步研究。后续工作将向操作规格级验证、更广泛的监管约束以及多协议实验室设计等方向拓展。
小结
LabBuilder 提出了一套将实验协议语义理解、化学安全建模和机器人导航可达性统一纳入生成流程的 3D 实验室布局生成框架,将安全性和可达性从事后验证转变为生成阶段的内置约束,并建立了开放、标准化的评测基准。实验结果表明,在面向科研实验室的场景生成任务中,显式纳入协议约束可以显著提升布局在安全性、功能性和机器人可用性方面的综合质量。
代码仓库:https://github.com/che-0212/LabBuilder
项目主页:https://che-0212.github.io/LabBuilder-site/
编辑:文婧
