拆分Codex规划、执行与审查模型,用默认配置持续降低调用成本。
冷月清谈:
怜星夜思:
2、主模型、子 Agent 和 Review 模型应该按什么标准选,而不是只看价格?
3、接入第三方 Provider 时,除了接口兼容和价格,还要重点防哪些坑?
4、Compact 不能单独指定模型,会不会成为这套省钱方案里的最大成本漏洞?
原文标题:Codex 好用但烧钱?配置多模型分工,永久压低调用成本
原文作者:数据派THU
原文内容
来源:Datawhale本文约1100字,建议阅读5分钟本文介绍了 Codex 调用逻辑,教你配置模型分工降低工具使用成本。
用 Codex 写代码,最明显的感受就是:好用,但烧钱。
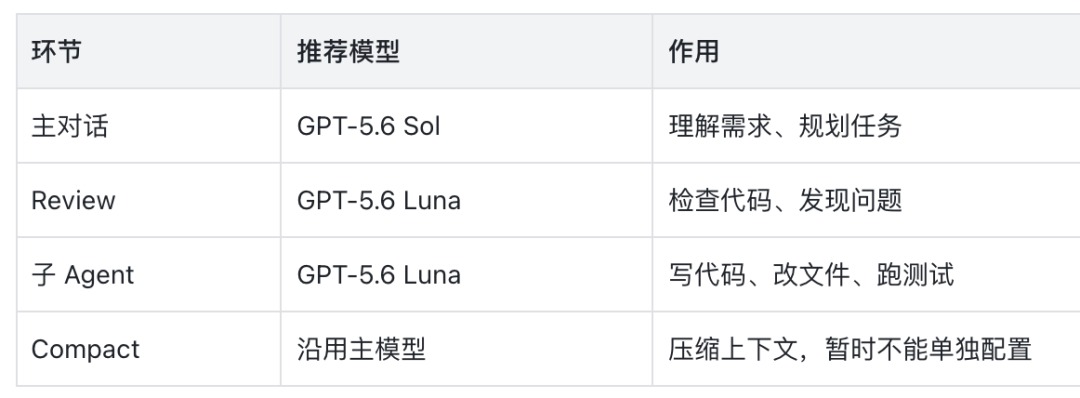
很多人以为,Codex 一次任务只调用一个模型。其实在一个思维链里,主对话、代码 Review、子 Agent 和上下文压缩承担的是不同工作。
很多伙伴不知道,这些步骤里面的模型可以改的!
配置一次,以后不需要每个任务都手动安排。Codex 会按照这套默认分工运行,在后台一点点把成本降下来。
这篇文章就带你把它配好。
一、先看懂 Codex 背后的模型调用链
在传统理解里,我们给 Codex 一个需求,它调用模型,写完代码,任务结束。
实际使用时,可以把这条工作链理解成几个不同环节:
你提出任务
    ↓
主模型:理解需求、规划任务、协调执行
    ↓
子 Agent:写代码、改文件、跑测试
    ↓
Review 模型:检查代码、发现问题
    ↓
Compact:上下文过长时进行压缩
这些工作对模型能力的要求并不相同。
主模型更像整个任务的大脑。它要理解目标、拆分任务、选择实现方案,还要判断下一步该做什么。这里一旦判断错了,后面的执行很容易跟着跑偏,所以主模型不能省得太狠。
子 Agent 主要负责具体执行,例如修改某个文件、补一段代码、运行测试。任务通常已经拆得比较清楚,不一定需要和主模型相同的推理能力。
Review 的工作边界也比较明确:检查代码、寻找问题、给出修改建议。大多数情况下,可以使用便宜一档的模型。
所以,这套配置的重点不是单纯换一个低价模型:
好模型负责想清楚,便宜模型负责把事情做完。
目前我们主要关心四个环节,其中前三个可以通过配置进行分工。
Compact 是一个例外。它负责在上下文过长时压缩内容,目前不能单独给它指定模型,因此这部分消耗仍然会跟随主模型。知道这个限制就好,不影响我们先把调用量更大的执行和审查环节降下来。
二、Codex 省钱保姆教程
打开 Codex 配置文件。
macOS 和 Linux:
~/.codex/config.toml
Windows:
C:\Users\<用户名>\.codex\config.toml
加入:
model = "gpt-5.6-sol"
model_reasoning_effort = "high"
review_model = "gpt-5.6-luna"
主模型负责规划,所以使用 Sol;Review 的任务比较明确,交给 Luna 即可。
第二步:配置子 Agent
在下面的目录中新建 worker.toml:
~/.codex/agents/worker.toml
写入:
model = "gpt-5.6-luna"
model_reasoning_effort = "medium"
子 Agent 负责写代码、改文件和跑测试,调用量通常比较大。换成 Luna 后,这部分成本更容易降下来。
子 Agent 会继承当前会话的 Provider,所以这里填写的模型必须是同一家 Provider 支持的模型。
配完就结束了。
以后仍然像平时一样使用 Codex,不用每次重新指定谁规划、谁执行。
国产模型也能这样配
如果不使用 OpenAI 官方模型,也可以接入支持 Responses API 的第三方 Provider。
例如火山方舟 Agent Plan:
model = "<套餐内的强模型>"
review_model = "<套餐内的轻量模型>"
model_provider = "volcengine-agent-plan"
model_supports_reasoning_summaries = true
[model_providers.volcengine-agent-plan]
name = "volcengine-agent-plan"
base_url = "https://ark.cn-beijing.volces.com/api/plan/v3"
env_key = "ARK_API_KEY"
wire_api = "responses"
然后在 worker.toml 中填入套餐内的轻量模型:
model = "<套餐内的轻量模型>"
model_reasoning_effort = "medium"
