固定前缀加滑动窗口,可在无需重训下加速长推理,并支持超长强化学习轨迹。
冷月清谈:
怜星夜思:
2、做Agent或多轮对话时,哪些内容必须钉在Prefix里,哪些信息更适合交给外部记忆?
3、同样时间里多生成一些token,真的等于推理能力更强吗?你会怎么设计公平评测?
4、如果早期一步算错后又被滑出窗口,模型还有机会回头纠错吗?是否需要摘要或外部记忆配合?
原文标题:大模型不用死记全部推理史!新方法实现三倍提速
原文作者:数据派THU
原文内容
本文约2500字,建议阅读5分钟本文介绍Prefix Sliding技术,阐述其优化大模型长推理的原理、优势与局限。
推理链越来越长,模型未必需要记住全部历史。Prefix Sliding 只保留任务前缀和最近窗口,让长思考不再背着整条推理链前进。
推理链越来越长,模型未必需要记住全部历史。Prefix Sliding 只保留任务前缀和最近窗口,让长思考不再背着整条推理链前进。
一条推理链越来越长之后,模型究竟需要记住多少?
按照标准全注意力的做法,答案几乎是全部。
此前完成的计算、中间步骤、不断累积的推理历史,都会继续留在后续注意力范围里。推理越长,每生成一个新 token 的成本也随之上涨。
问题在于,模型真的还需要反复回看这些已经过去的中间步骤吗?
最近,斯坦福、华盛顿大学等机构的一项联合研究从这里切入,吴恩达、Yejin Choi、Percy Liang 等参与其中。
团队提出 Prefix Sliding,只长期保留任务前缀和最近的推理窗口,让更早的中间 token 逐步退出后续注意力计算。
最终,现有模型无需重新训练,长思考最高约 3 倍提速。用于强化学习后,单条推理轨迹还能扩展到 10 万 token 以上。
论文标题:
Prefix Sliding for efficient test-time scaling
论文地址:
https://arxiv.org/abs/2608.26070
代码地址:
https://github.com/Muennighoff/prefix-sliding
1、注意力为何集中在推理两端
全注意力的代价会随着推理链长度持续上升,但模型对这些历史 token 的使用并不均匀。
团队分析 Qwen3-1.7B 在 AIME25 上的一条推理轨迹后发现,注意力呈现出明显的“两头高、中间低”。
最前面的 Prefix 和最近生成的一段 token 获得更多关注,中间大量推理 token 的注意力则整体处于低位。
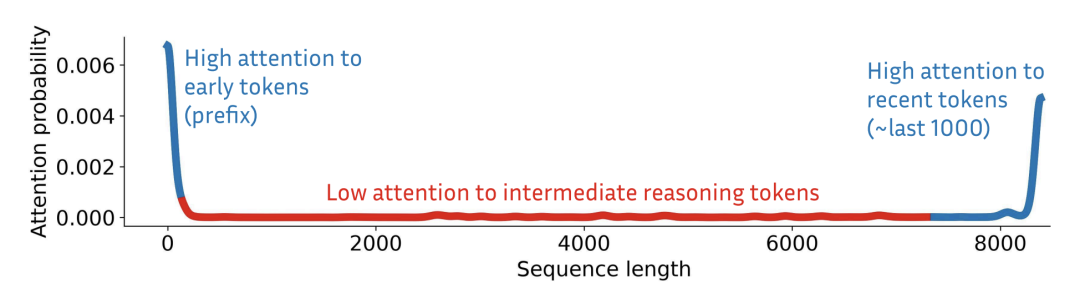
〓 长推理中的注意力主要集中在前缀和最近生成的 token
Prefix 中保存着系统指令、任务描述和工具信息,其中最前面的几个 token,尤其前 4 个 token,还承担 attention sink 的作用。最近生成的 token 则对应模型当前正在处理的问题。
论文用一个简单算式 ((42 + 84) × 4) - 5 为例:完成 42 + 84 后,后续计算可能只需要这个结果,不再需要保留此前完整的推理过程。
这也构成了 Prefix Sliding 的直接动机:后续计算未必需要始终携带完整的推理历史。
2、Prefix Sliding如何丢掉中间Token?
Prefix Sliding 固定保留任务前缀,最近 W 个推理 token 构成滑动窗口。随着生成继续,更早的中间 token 会逐步从后续注意力计算所使用的 KV Cache 中移除。
假设 Prefix 有 100 token、窗口为 4096,即使完整推理已经达到 10 万 token,后续注意力计算最多只需保留约 4196 token。
窗口填满后,单步成本不再随着完整推理链增长。
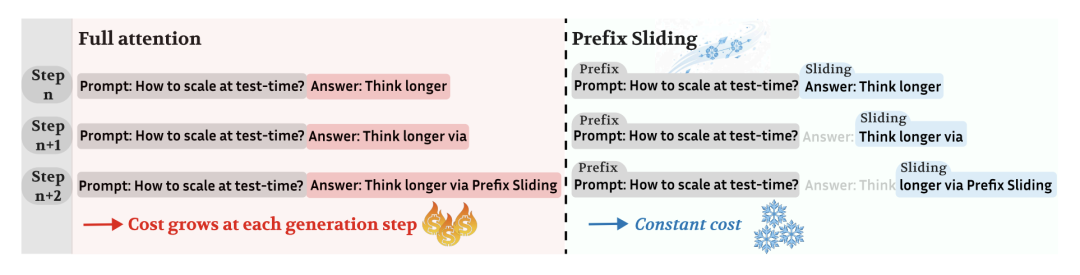
〓 Prefix 固定保留,最近的推理 token 随窗口向前移动
普通滑动窗口会让最开始的任务信息逐步移出窗口,Prefix Sliding 则始终保留 Prefix。
团队最终采用 Continue PE。附录在 AIME25 上的实验显示,它与 Reset PE 表现相近,同时无需反复应用新的位置编码,可以直接复用已有缓存表示,计算更高效。
团队还针对 NVIDIA Hopper 实现了专用 FlashAttention 内核。
对完全位于 Prefix 和滑动窗口之外的 tile 直接跳过,对与有效区域部分重叠的 tile 做元素级 Mask,从而减少无效加载和计算,实际速度也接近普通滑动窗口的实现。
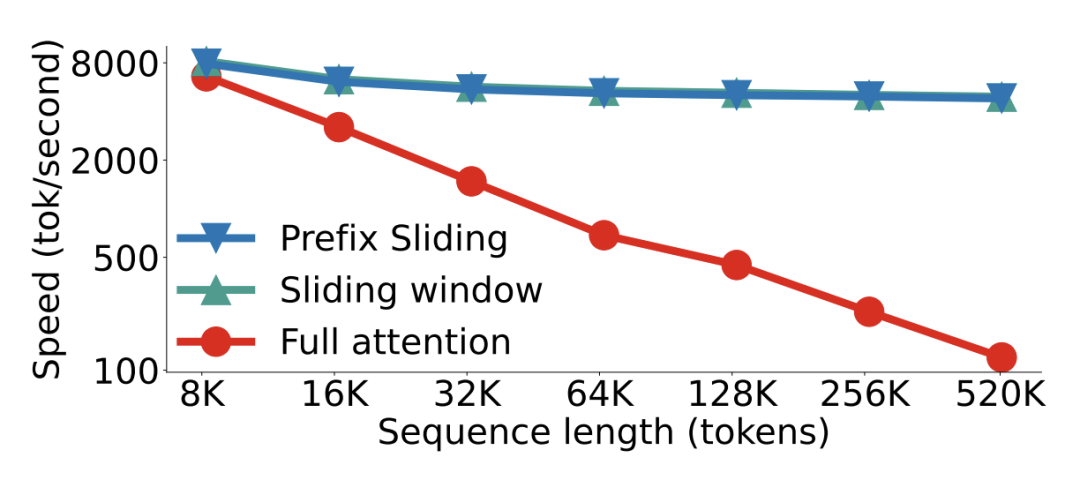
〓 窗口填满后,Prefix Sliding 的生成吞吐趋于稳定
3、无需训练最高提速3倍,RL扩展到10万Token
在无需额外训练的设置下,作者以 Qwen3-1.7B 为主模型,在 AIME25、GPQA 和 MATH500 上进行评测。
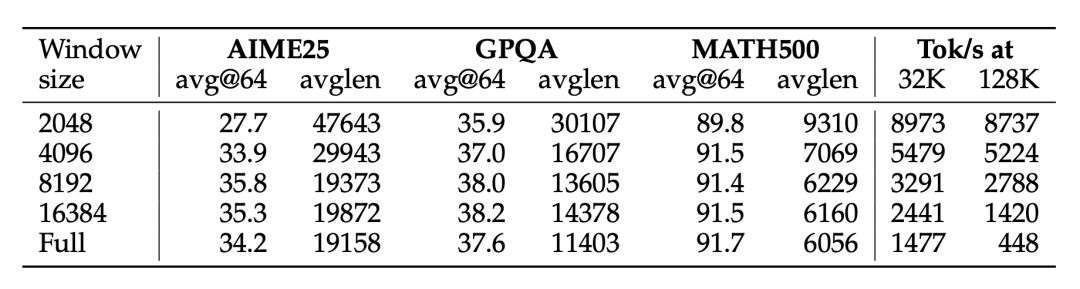
Prefix Sliding 的优势来自同样思考时间内可以生成更多 token,并非单个 token 本身质量变高。
以 4096 token 窗口为例,Prefix Sliding 在 AIME25、GPQA 和 MATH500 上与全注意力表现接近,但在长序列下吞吐明显更高,128K 时达到 5224 tok/s,而全注意力只有 448 tok/s。
〓 相同思考时间下,Prefix Sliding 可以生成更多推理 token
这里的“3 倍”比较的是相近任务表现下的思考时间,并非直接比较上述吞吐数字。
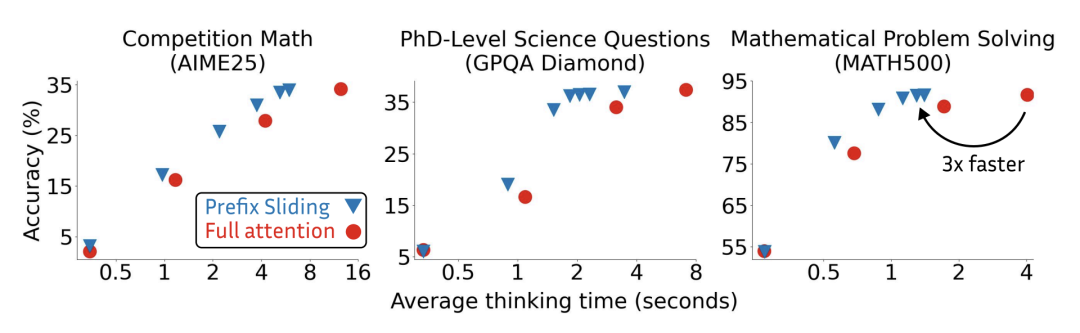
〓 相同思考时间下,Prefix Sliding 可以生成更多推理 token
强化学习阶段,Prefix Sliding 还能将 rollout 扩展到 10 万 token 以上。为避免对整条超长轨迹做完整反向传播,作者采用截断反向传播。
滑动窗口跨多层的理论感受野可达 W×L,不过作者援引已有分析指出,受信息瓶颈影响,实际有效感受野更接近约 1.5×W,因此对最后一个窗口进行反向传播时,只需提供此前有限的上下文。

〓 超长推理轨迹可以采用分块或截断反向传播
例如一条 10 万 token 的轨迹,窗口为 2048 时,训练端只接收最后 8192 token,前 6144 token 作为上下文,最后 2048 token 计算 RL loss。
实验显示,只保留 1 倍窗口会导致较大的 KL 偏差,扩大到 2 倍后明显下降,4 倍已经与 8 倍基本接近,因此主实验采用 4 倍窗口。
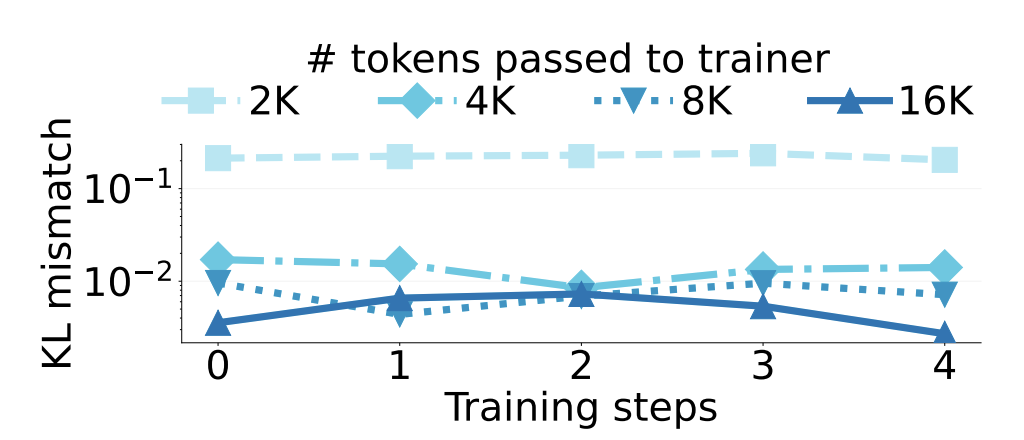
〓 传入更多历史 token 后,截断反向传播的 KL 偏差迅速下降
附录还在 DeepSeek-R1-Distill-Qwen-7B 上进行了一次规模较小的异步 RL 实验。
结果显示,在训练端输入 32768 token、Prefix Sliding 只对最后 8192 token 反向传播的设置下,训练奖励和 AIME24 表现与全注意力相当。
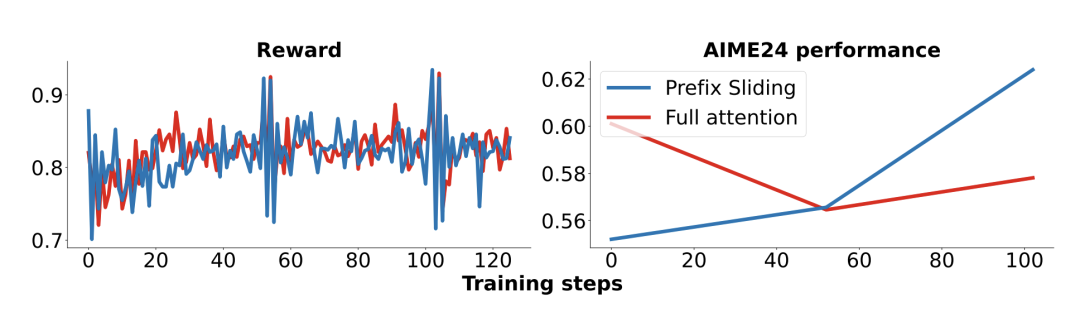
〓 7B 模型上,截断反向传播与全注意力表现相当
作者也明确指出,更大规模、更长推理链上的表现仍需进一步验证。
在相近的内存预算下,全注意力最大长度为 8192 token,Prefix Sliding 则将最大生成长度逐步提高到 104K,并获得更高的训练奖励。
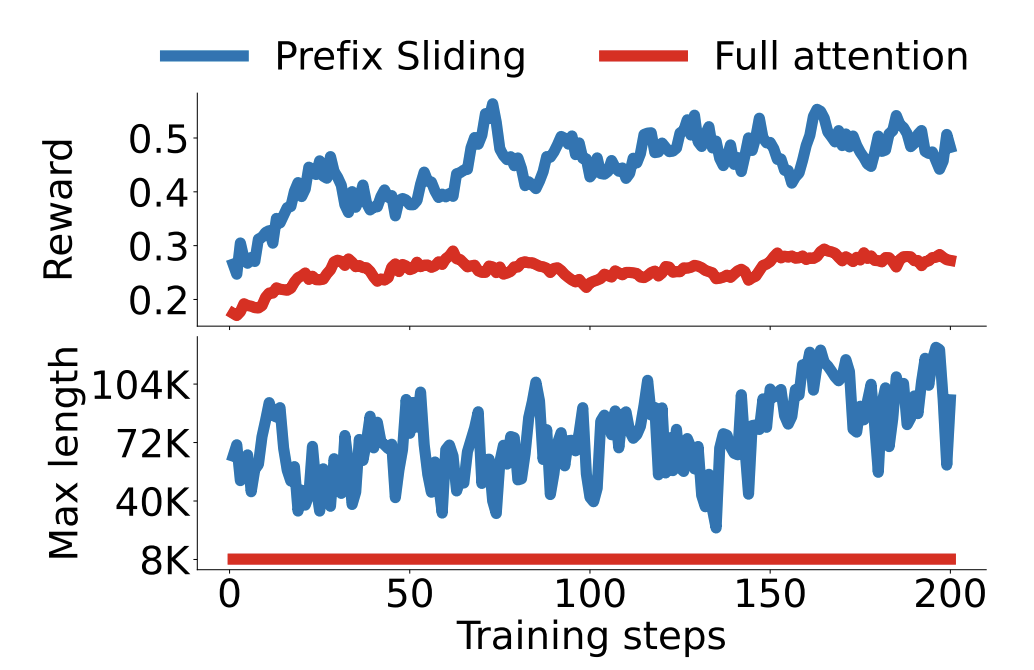
〓 相近内存预算下,Prefix Sliding 支撑更长的强化学习轨迹
4、中间Token并非都能丢
与 Last-k、Summary 和普通滑动窗口相比,Prefix Sliding 的性能与效率综合表现最好。
Last-k 会重复处理保留 token,普通滑动窗口则会逐渐丢掉任务前缀。Summary 还需要额外生成摘要并引入更多超参数,真实样例中,模型看起来甚至会忽略摘要里的已有推导,重新开始求解。
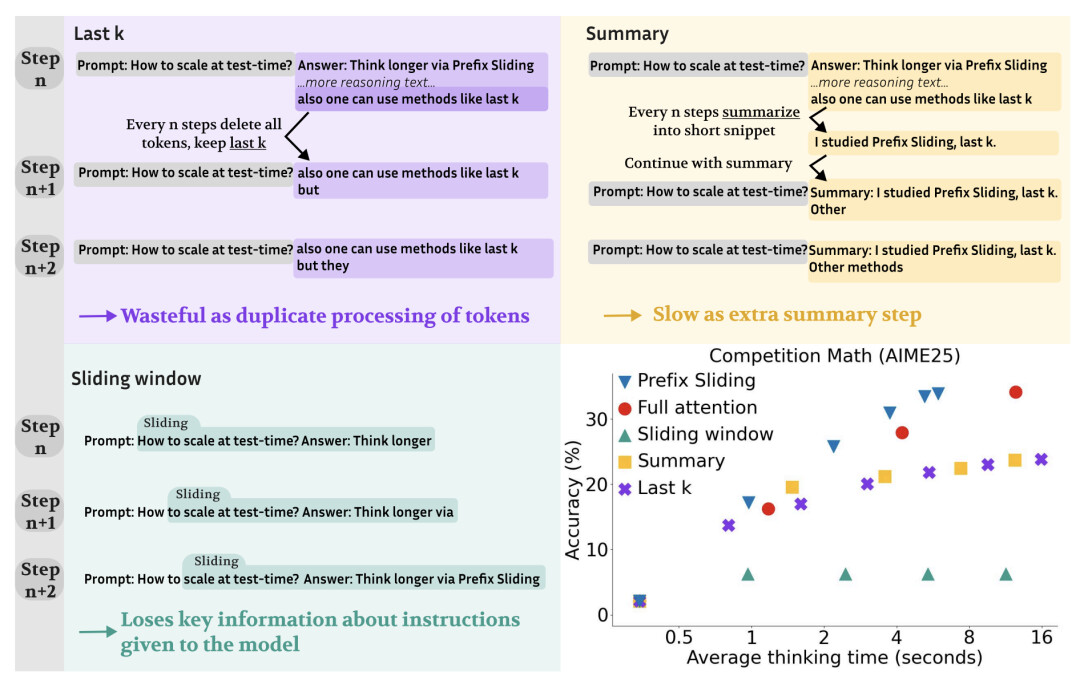
〓 Prefix Sliding 与 Last-k、Summary 和普通滑动窗口的性能—效率对比
在无需训练的 LiveCodeBench 实验中,模型可能先写代码,再用数千 token 的注释继续思考,等回到代码时,早先内容已经滑出窗口。
至少需要 16384 token 窗口,才能匹配全注意力。
作者也指出,如果使用 Prefix Sliding 进行强化学习,模型可能学会调整这类注释推理行为,从而允许更短的窗口。
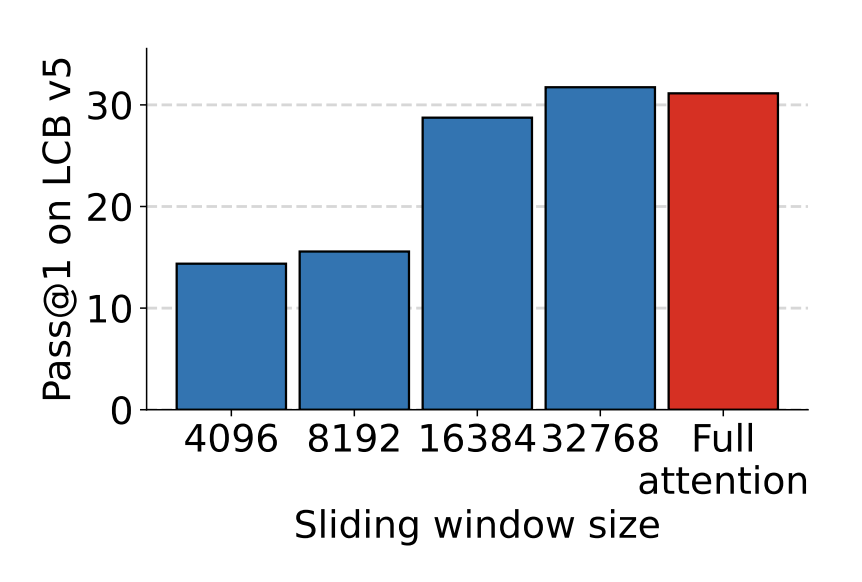
〓 LiveCodeBench 至少需要 16384 token 窗口才能匹配全注意力
短任务也未必受益。HealthBench 平均只生成约 2086 token,而窗口为 2048,很多样本还没真正进入滑动阶段,因此可获得的加速空间很有限。
在 Agent 场景中,一次过长的网页或文件输出可能直接填满有限窗口,甚至让模型无法同时读取完整内容。
多轮交互也带来新的上下文管理难题:后续用户指令究竟应该并入 Prefix 长期保留,还是允许它们随后滑出窗口,论文目前没有给出定论。
Prefix Sliding 也没有降低超长 Prefix 在 Prefill 阶段带来的 KV Cache 开销。
论文的直接实证比较还主要限定在能够直接用于现有预训练 Transformer、同时满足单步生成成本有界的方法,并没有覆盖其他模型架构、亚二次复杂度方法和混合滑动窗口模型。
5、结语
Prefix Sliding 把长推理的效率问题进一步具体化为一个上下文管理问题:已经生成的历史信息,到底需要保留多久。
哪些信息应该长期保留在 Prefix 中,哪些可以随窗口移出,仍然需要更细致的上下文管理策略。在代码任务、Agent 场景中的大体量工具输出以及多轮交互中,是否还需要额外的记忆机制,也没有定论。
现有结果表明,固定前缀加滑动窗口能够显著降低超长推理成本,但它在更大模型、更复杂的长期任务上的适用范围仍需后续验证。
