高昂Token成本推动企业分流AI任务,中国开放模型迎来机会。
冷月清谈:
怜星夜思:
2、开放权重模型部署在企业内部,就一定比闭源API更安全吗?
3、中国开放模型进入美国企业后,最大的障碍会是技术、合规还是品牌信任?
4、企业做模型路由时,应该优先按任务难度分流,还是按数据敏感度分流?
原文标题:OpenAI们被嫌死贵,美国大厂转向开源模型,中国成最大赢家
原文作者:机器之心
原文内容
企业AI进入一个越来越细的模型分流阶段。中国的开放模型正在吃下美国企业的AI降本红利。
OpenAI、Anthropic 开始被客户们嫌贵了。
不只是硅谷创业公司,连 AT&T 这样的电信巨头也把大约 40% 的 AI 工作负载放到了开放模型上,还准备在未来一年进一步提高到 70%。
这也不难理解——AT&T 每天处理的 Token 数量已经达到 450 亿。到了这个规模,模型每百万 Token 便宜一点,最后反映到财务报表上,都可能是一笔相当可观的数字。
于是乎,一批原本主要调用 OpenAI、Anthropic 前沿模型的美国企业,开始把越来越多的任务迁移到开放权重模型上。这里甚至出现了一个有意思的局面:
美国企业正在越来越多地使用中国 AI 公司提供的开放模型。
据《金融时报》报道,今年以来,企业对开放模型的讨论和实际调用量都出现明显增长,而当前开放权重模型市场里,最活跃的一批玩家正来自中国。

DeepSeek、智谱等公司的名字,也开始出现在美国企业重新计算 AI 成本的这张账单里。
一年 100 万美元,
半年后变成 1000 万美元
企业为什么开始认真看开放模型?一个数字就能说明问题。
Tinder CTO Vinay Kuruvila 透露,今年 1 月,公司按照当时的 AI 使用规模估算,全年支出大约是 100 万美元。到了 7 月,这个数字已经变成了:1000 万美元/年。
半年,涨了 10 倍。Kuruvila 的态度很明了:
我不想再看到一次 10 倍增长。
现在,Tinder 已经开始把一部分来自普通用户的请求,转给开放权重模型处理。因为,对于很多企业任务来说,真正的问题已经逐渐从哪个模型最聪明,变成了:这个任务到底值不值得调用最贵的模型?
Kuruvila 认为,目前 OpenAI Astra 和 Anthropic Claude Fable 这样的前沿模型,对于 Tinder 约 90% 的任务来说,能力已经足够。
这也意味着,一旦开放模型进一步追近,企业继续为这部分能力支付前沿模型溢价的必要性就会下降。
换句话说,企业 AI 正在进入一个越来越细的模型分流阶段。最难的任务继续交给最强模型。大量重复、明确、容错边界清晰的任务,开始流向更便宜的模型。
一天 450 亿 Token,
40% 已经交给开放模型
更夸张的是 AT&T。
这家美国电信巨头现在每天处理大约 450亿 Token,其中约 40%的 AI 工作负载已经运行在开放模型上。而公司给自己定下的目标,是一年内把这个比例提升到 70%。
AT&T 首席数据与 AI 官 Andy Markus 解释,在这样的调用量级下,成本已经成为模型选择中非常关键的变量。如果一个任务可以从昂贵的闭源模型迁移到开放模型,同时准确率没有明显下降,公司自然会迁移。
更重要的是,AT&T 并不是简单下载一个开源模型直接使用。他们还会利用自己的专有数据对模型进行调优。在一些特定任务中,经过企业数据优化后的开放模型,效果甚至可以做到和闭源模型相当,乃至更好。
这也是开放模型对企业最有吸引力的一点:它可以被企业改造成自己的模型。
参数开放之后,企业可以自己部署、微调,不必每次调用都向模型公司支付 Token 费用。如果企业本来就拥有大量算力、数据和工程团队,这笔账尤其容易算过来。
不是嘴炮,调用量也真的上来了
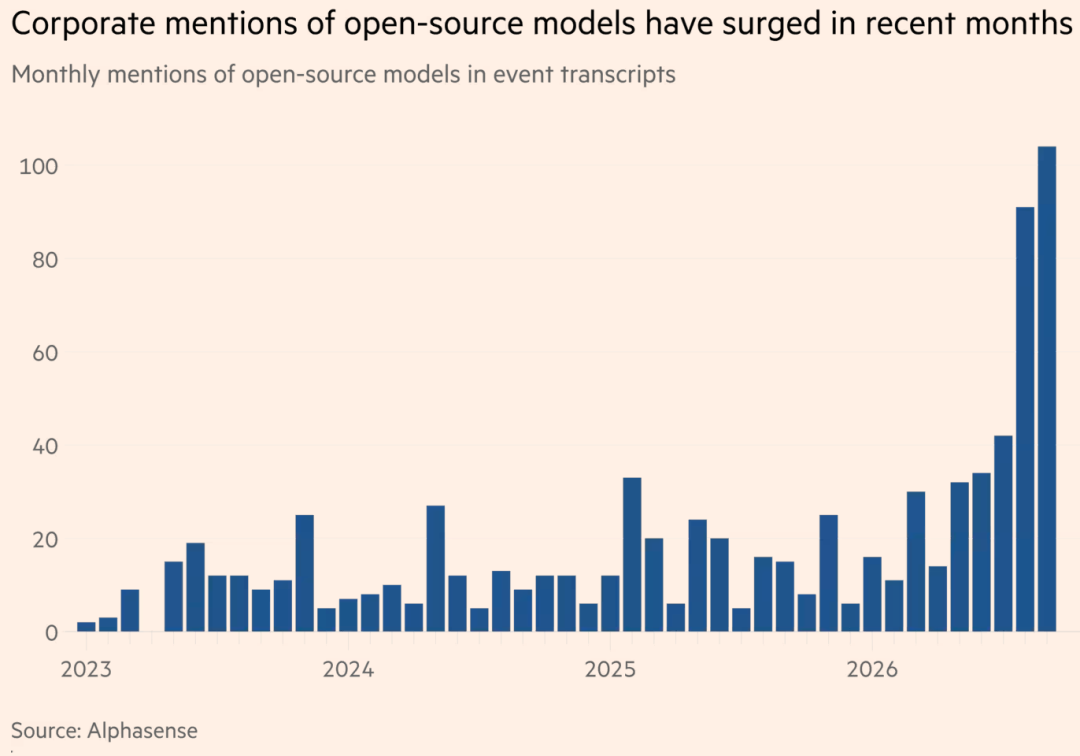
AlphaSense 统计显示,今年8月和9月,美国企业在业绩电话会和投资者会议中提到 open weight 或者 open source 模型的次数,比去年同期增加了 6 倍。
讨论这些模型的企业也已经从科技行业扩散出去。PNC Financial Services、物流公司 CH Robinson、工业巨头 Siemens,最近都公开谈到了开放模型的使用。
真正值得注意的是模型调用数据。
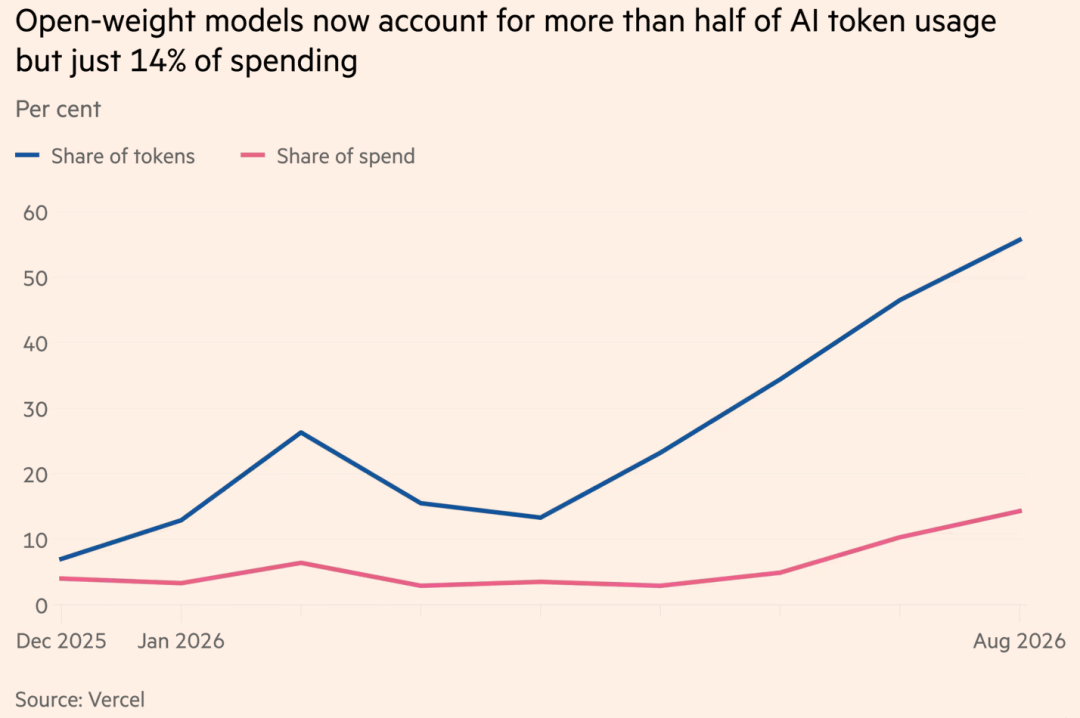
今年 8 月,在 Vercel AI Gateway 上处理的所有 Token 中,56% 已经来自开放权重模型。去年 12 月,这个比例还只有:7% 。
不到一年,从 7% 涨到 56% 。
OpenRouter 上也出现了类似趋势。按照 Token 调用量统计,排名靠前的模型中,来自中国实验室的开放模型已经占据相当醒目的位置。
所以,企业对开放模型的兴趣,目前已经同时出现在两个地方:一边是财报电话会。另一边是真实 Token 消耗。
中国模型,吃到这一轮企业降本红利
现在全球开放权重模型市场中,一股绕不开的力量来自中国。DeepSeek、智谱等中国公司已经成为这一赛道的重要玩家。
此外,法国 Mistral,以及美国的 Nvidia、Reflection AI、Thinking Machines Lab,也在推出开放程度较高的模型。
这些公司的商业模式和 OpenAI、Anthropic 并不完全相同。
对于 OpenAI 和 Anthropic来说,最先进的闭源模型本身就是核心商品。用户使用一次,就支付一次 API 成本。
开放模型玩家则有更多选择。有的通过 Token API 收费。有的免费提供模型,希望扩大生态和开发者覆盖。还有厂商可以通过模型带动芯片、云服务或者其他产品销售。
因此,当企业开始对 AI 成本越来越敏感时,开放模型可以把价格压到一个完全不同的水平。尤其对于可以自行部署的企业来说,Token API 甚至都可以跳过。模型下载下来,跑在自己的基础设施上。
这也是为什么开放权重模型正在从开发者社区里的选择,逐渐变成企业 CIO 和 CTO 账本上的选择。
成本之外,还有一个词:数据
不过,企业拥抱开放模型,并不完全因为便宜。
Digital Realty 高级全球解决方案架构总监 Scott Wallace 提到了另外两个原因:数据主权和安全。
Digital Realty 已经搭建了自己的内部聊天系统,底层运行开放权重模型。公司会根据不同任务的敏感程度,在开放模型和商业闭源模型之间切换。其中一些企业内部数据,只会进入部署在私有基础设施上的模型。
Wallace 说:客户数据不会进入外部的前沿模型。
这其实揭示出了企业AI里的另一个趋势:过去大家关注的是,最强的模型是哪一个。但到了真正部署阶段,企业考虑的是一整套问题:
成本多少、数据放在哪里、模型能不能定制、延迟多高、是否可以私有化,以及出了问题之后自己能控制多少。
在这些维度上,开放模型天然拥有一些不同于闭源 API 的优势。
OpenAI、Anthropic 的真正对手,
可能是一张Excel表
当然,现在谈企业全面抛弃 OpenAI 和 Anthropic,还远远过早。
目前,两家公司依然拿走了企业 AI 支出中的很大一部分。最复杂的编码、推理、研究和 Agent 任务,企业仍然高度依赖前沿模型。
这些模型对于算力的大规模需求,也仍然支撑着全球数据中心建设热潮。
但变化已经出现了。过去企业可能倾向于把各种任务全部接入最强模型。现在越来越多公司开始做另一件事:拆任务。哪些任务必须用最强模型?哪些任务用次一级模型就够了?哪些任务可以直接交给本地部署的开放模型?
一旦 AI 调用量从每天几百万 Token 增长到几十亿、几百亿 Token,这种模型路由就不再是工程细节。它会直接变成成本问题。
对 OpenAI 和 Anthropic 来说,这可能比又出现一家参数更大的竞争对手更棘手。因为企业做这个决定时,摆在面前的未必是一张 Benchmark。更可能是一张 Excel 表。这张表里的最后一列写着:每年能省多少钱。
参考链接
https://www.ft.com/content/d9de4776-1fc9-4f2b-aaaf-9961c35d8acd?syn-25a6b1a6=1
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com