基础模型正挤压刷榜式研究,也迫使AI博士重新选择科研问题与职业路径。
冷月清谈:
怜星夜思:
2、高校没有头部公司的数据和算力后,最可能建立起哪些不可替代的研究优势?
3、AI博士生应该如何判断自己更适合进入工业界训练基础模型,还是留下来研究智能机制?
4、把大模型当作“硅基生命”来研究,会带来哪些新方法,又可能造成哪些误导?
原文标题:计算机科学学术界死了吗?AI博士生该何去何从
原文作者:机器之心
原文内容
AI 时代,计算机科学研究正在失去意义吗?
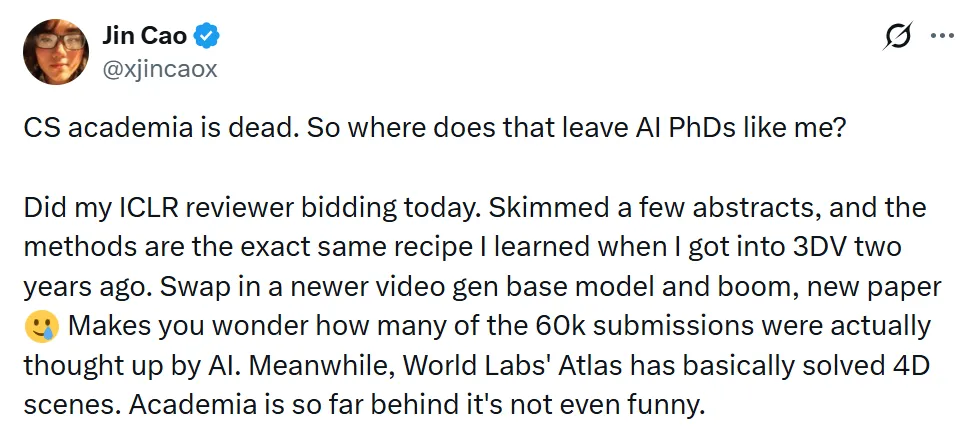
最近,来自德克萨斯大学奥斯汀分校(UT Austin)的计算机科学博士生曹晋提出了一个令人不安的问题:
计算机科学学术界已经死了吗?那像我这样的 AI 博士该何去何从?
来源:https://x.com/xjincaox/status/2103144302784237674
在参与 ICLR 审稿过程中,他快速浏览了一些论文摘要,发现很多方法和他两年前刚进入 3DV(3D Vision)领域时学到的套路完全一样。
换一个更新的视频生成基础模型,套上类似的方法,然后一篇新论文就出来了。
这让人不禁怀疑:ICLR 那 6 万篇投稿里,到底有多少真正是人想出来的?
这种焦虑并非个例。
当大模型开始进入研究者的角色
过去,许多 AI 研究围绕一个明确路径展开:针对具体问题,设计新的模型结构,引入新的归纳偏置(inductive bias),然后在 benchmark 上不断优化。
但基础模型正在改变这一过程。越来越多案例表明,通用模型开始进入过去被认为需要专门设计的领域。
例如,World Labs 的 Atlas 展示了强大的 4D 场景理解与生成能力;而新一代大模型与 3D 工具、机器人系统结合后,也开始展现出令人意外的空间推理和操作能力。
曹晋回忆 GPT-6 Astra 发布后的场景:他的信息流中充满了 GPT + Blender 的逆向图形(inverse graphics)实验,以及 GPT 驱动机器人机械臂完成复杂操作任务的案例。
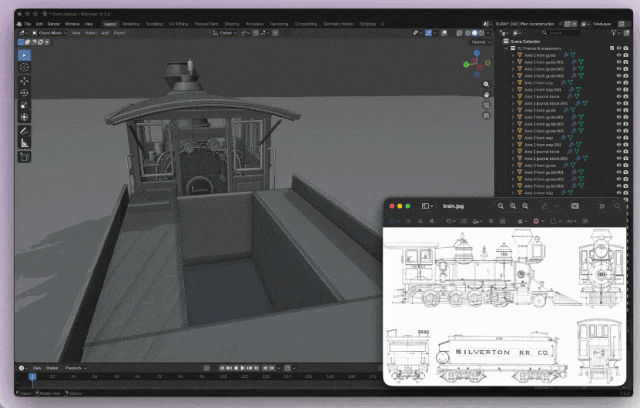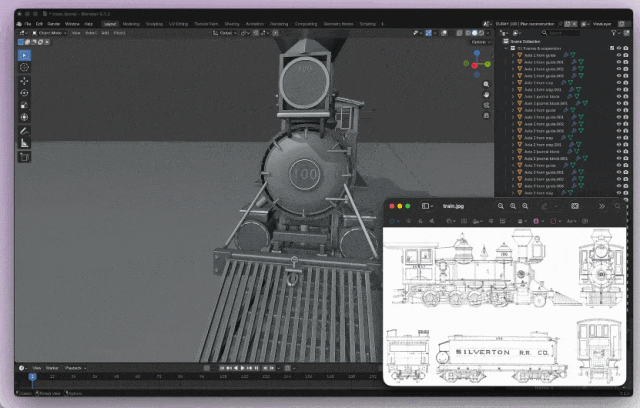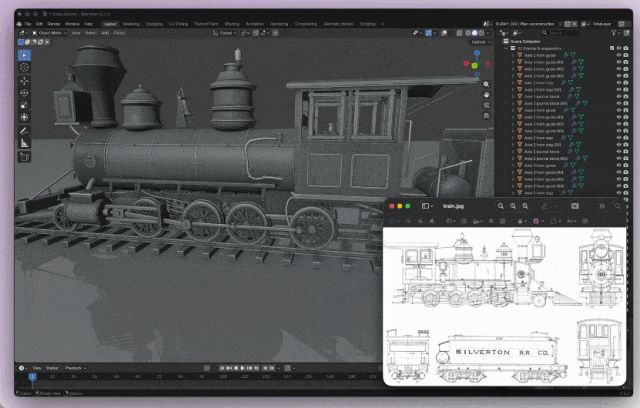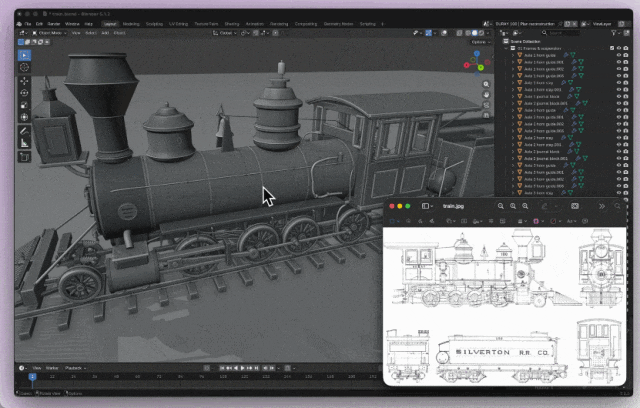
这些结果让他重新审视了一个曾经坚定的判断:
一年前,他还非常确定:大语言模型永远不可能拥有空间智能。
一年后,Astra 直接把他的这个认知彻底推翻了。
毫无疑问,Astra 经过了大量 3D 数据和机器人操作数据的后训练,而且未来规模只会越来越大、速度越来越快。在他看来,这意味着:任何能够被符号化表示,并且拥有清晰强化学习(RL)评测标准的领域,最终都会被大语言模型吞噬。
相比真正具备智能的大语言模型,大量依靠加入一点归纳偏置(inductive bias)、通过调参刷出 SOTA 的学术论文,不过是在等待被淘汰的路边残骸。
遗憾的是,这类论文仍然不断涌入各种会议。
这更多是一种惯性:我们追逐 SOTA 已经太久了,很难在一夜之间停下来。
但必须承认:很多领域的方法范式其实早已收敛。
过去被称为研究的东西,如今越来越像纯工程工作;而学术界通过设计新的归纳偏置来贡献价值的空间,也正在不断缩小。
当模型越来越强,AI 研究者还有什么价值?
面对基础模型带来的变化,作为一名博士生,曹晋认为未来 AI 研究者可能会面临两种选择。
第一条:如果打不过,就加入他们。整理高质量数据,搭建基础设施,然后进入工业界,训练基础模型。
第二种,回归真正的科学研究。不要再执着于在 benchmark 上提升 0.1%。开始研究为什么这个方法有效?为什么那个方法无效?把基础模型本身作为研究对象。
正如他的朋友所说:未来 AI 研究可能越来越像生物学,只不过研究对象从碳基生命变成了硅基生命。
除此之外,很难想象还有什么方向不会被大语言模型吞噬。
随着 AI 能力不断提升,人类知识和经验的独特价值似乎正在被重新衡量。就像 AlphaGo 曾经改变围棋领域对人类智慧的理解一样,未来每个领域都可能迎来属于自己的 AlphaGo 时刻。
而在这个过程中,学术界最终会走向哪里,或许正成为 AI 时代最值得观察的问题之一。
曹晋的这篇帖子也引发了不少网友和 AI 研究者的讨论。
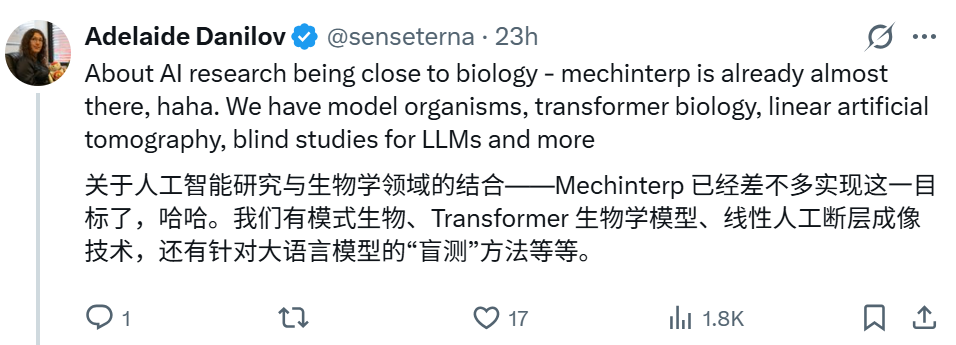
有网友进一步指出,AI 研究正在出现类似生物学研究的趋势,而机械可解释性领域已经率先展现出这一趋势。研究者开始建立 AI 领域的模型生物,研究 Transformer 内部机制,并尝试通过新的实验方法观察大模型如何产生能力。
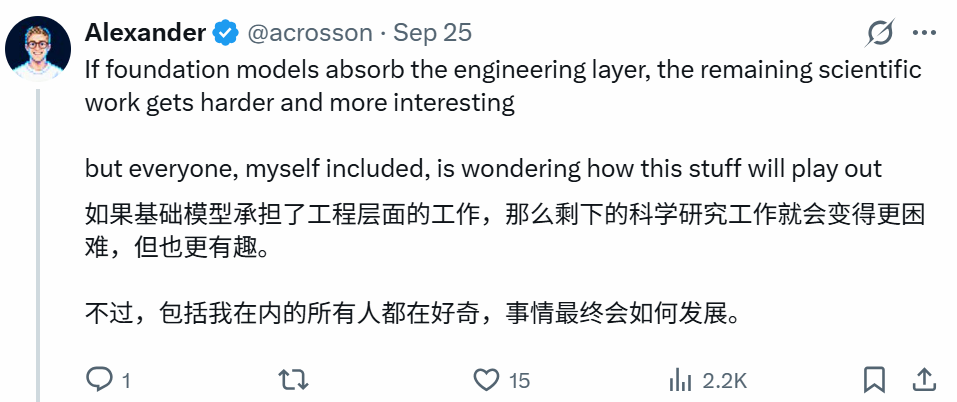
还有网友表示,如果基础模型逐渐吸收大量工程层面的工作,那么未来真正重要的科学问题反而会变得更加困难,也更加有趣。
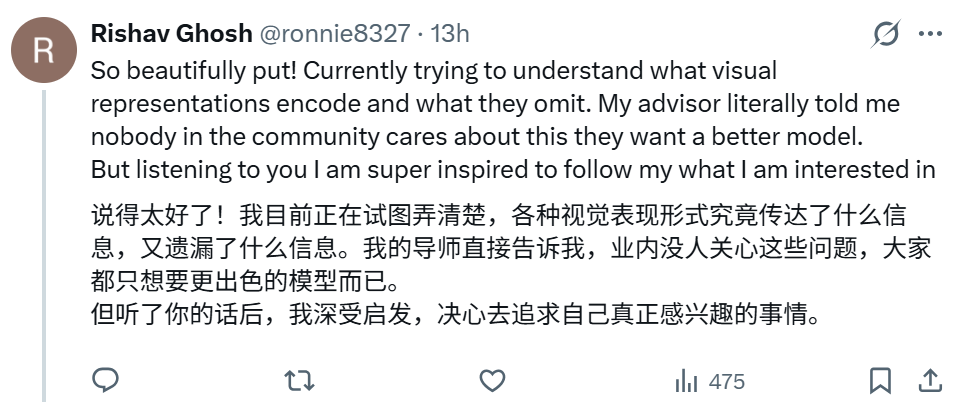
这位研究视觉表示的研究者也分享了自己的经历:
他目前正在探索视觉模型究竟编码了什么,又忽略了什么。但他的导师曾告诉他,社区更关注更好的模型,而不是这些基础问题。
然而,在看到相关讨论后,他受到鼓舞,决定继续追随自己真正感兴趣的问题。
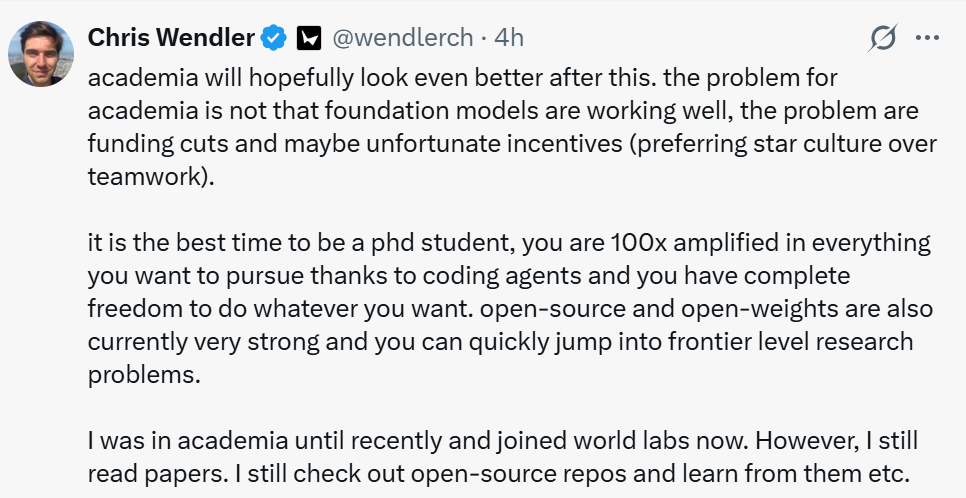
也有研究者持更加积极的态度。
他们认为,基础模型能力增强并不会削弱学术研究的价值,真正影响学术界的因素可能是科研经费、评价体系以及过度强调个人明星效应的激励机制。
在他们看来,现在反而是成为博士生的好时代。
随着代码 Agent 的出现,研究者可以借助 AI 放大自己的能力;与此同时,开源模型和开放权重生态的发展,也让个人研究者能够更快速地参与前沿问题探索。
即使进入工业界后,也要保持阅读论文、研究开源项目的习惯。
在他看来,基础模型带来的变化,并不意味着学术研究结束,而可能意味着研究问题正在发生迁移:从构建更大的模型,转向理解智能如何产生。
你如何看待这场变化?欢迎在评论区分享你的观点。
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com