循环架构能增加隐式计算,但尚无证据证明它导致思维链更难监控。
冷月清谈:
怜星夜思:
2、如果计算预算差不多,你会选循环 Transformer,还是层数更多的传统模型?为什么?
3、让模型直接操作你的电脑,最该优先补上的安全措施是什么?
4、新模型越来越强,AGENTS.md、SKILL.md 这类详细说明该删掉,还是继续维护?
原文标题:GPT-6 Astra 的思维链变短,是循环 Transformer 的原因吗
原文作者:图灵编辑部
原文内容
过去几周发生了不少事。我想现在大家最关心的,应该就是 OpenAI 的 GPT-6 Astra——尤其是它的性能表现、循环 Transformer(循环深度)这一部分,以及关于 Astra 在“隐藏”自己推理轨迹(也就是思维链)的传闻。
所以在这篇文章里,我想先谈谈对 Astra 的一些初步印象,以及我对这一切走向的看法。接着,我会详细讲讲 “循环 Transformer” 到底是什么,以及它与隐藏思维链有什么关系——或者说,究竟是否有关系。
最后,在介绍完循环 Transformer 的基础原理之后,我还想分享近期相关研究论文中的一些新见解。
1. GPT-6 Astra 初印象
先说最要紧的。在进入架构传闻和相关研究文献之前,我先简单总结一下自己对 GPT-6 Astra 的一些观察和零散发现。
上周,OpenAI 的新模型 GPT-6 Astra 高调发布。过去几天我一直在用它,它确实是个非常出色的模型,大概是我写下这篇文章时用过最好的一个。那么,它究竟提升了什么,又是怎么做到的?
1.1 Astra 的基准测试
Astra 是我目前用过最好的模型,而且它在 3D 渲染和动画任务上好得有点“不成比例”(相对于其他模型而言)。我的意思是,它虽然在几乎所有类别上(写作、数学、编程等等)都超越了前代 GPT-5.6,但在图形类演示上的领先尤其明显。
这一点在基准测试里也能看到。比如 GPT-6 Astra 在数学和编程上表现相当强,如下图所示。
图 1:精选的三个主流编程基准和一个高难度数学基准。更多基准测试见 Astra 发布博客 https://openai.com/index/gpt-6-astra/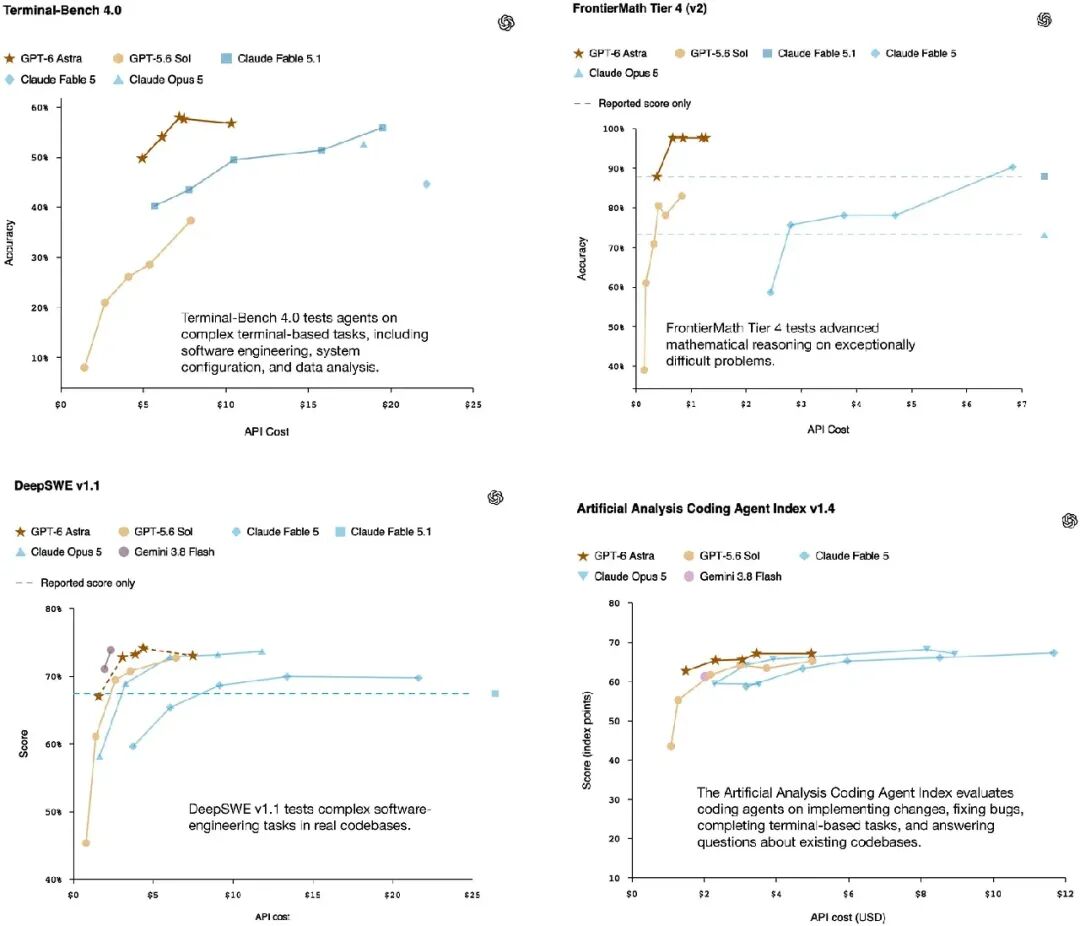
其中一个亮点(图中未展示)是,Astra 在 ARC-AGI-3 基准上拿到了 99.9%(GPT-5.6 Sol 只有 7.8%),这个基准衡量的是解逻辑谜题与泛化能力的综合表现。不过,数学、编程和电脑操作类基准更有意思,因为它们更接近真实使用场景。
回到前面那张图右下角的 Artificial Analysis 编程智能体指数 v1.4,它混合了多项智能体编程任务。可以看到,GPT-6 Astra 明显处在前沿,但并没有大幅拉开差距。这一点在下面这个更综合的 Artificial Analysis 智能指数中也能看到,该指数混合了不同类型的任务,而不只是编程任务。
图 2:Artificial Analysis 智能指数,来源 https://artificialanalysis.ai/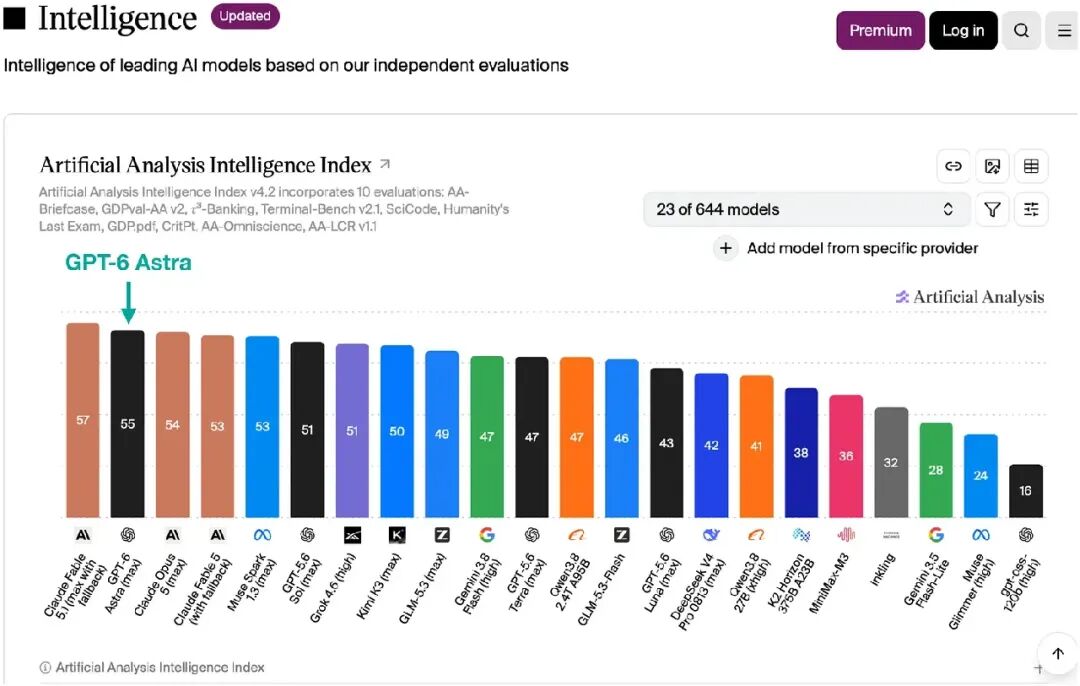
Artificial Analysis 这类基准最大的优势在于它们是独立第三方,因此可能比模型开发方自测的基准更可信一些。
harness 的搭建方式取决于具体基准。比如 GDPval-AA 和 AA-Briefcase 在对比不同 LLM 时,统一使用他们开源的极简 harness Stirrup。在上面展示的智能指数 v4.2 中,Terminal-Bench v2.1 用的是 Terminus 2,τ³-Banking 用的是 τ-Bench harness。单独的编程智能体指数还专门对比了不同的编程智能体 harness。
对于共用同一 harness 的评测,模型之间的对比更接近“同一标准下的比较”。同时,模型在训练阶段通常会以某一个主力 harness 为目标来开发(在其他 harness 上的微调较少)。而且,主力 harness 往往也是为了贴合并放大该模型的长处而设计的。
所以,有些智能体类评测可能低估了 Astra 在它自己主力 harness 下的表现。这对它的智能指数分数影响有多大,需要在相同任务上跨 harness 对比 Astra 才能知道。
顺带一提,正如一位同事最近向我建议的(Claude Code 负责人也有类似建议),把你现有的 AGENTS.md 内容和 SKILL.md 文件删掉(或归档)一部分,或许并不是坏主意——新一代 LLM 在理解提示和解决手头问题上已经更高效了。额外的“手把手”说明可能会不必要地束缚新模型,反而带来更差的结果。
当然,我不是说以后再也不用 SKILL.md 文件了。对某些工作流来说,复用这些文件确实能提升效率,模型不必每次都重新摸索一遍。我想说的是,有些工作流其实不需要描述,而“旧”的描述可能已经不再是最优的,LLM 或许能给出更好的方案。所以,也许是时候更新或重新生成这些说明文件了。
1.2 电脑操作能力
GPT-6 Astra 在图像和渲染任务上似乎格外强。当这些任务涉及与图形界面交互时,也就同时体现出了电脑操作(computer use)能力——即模型通过 Codex/ChatGPT 应用来操作你本地电脑上的软件。
电脑操作是这个模型相比其他模型真正出彩的地方,而且任何与图形相关的东西都很适合做成社交平台上直观、有意思的演示。网上已经有大量令人印象深刻的例子,从用 Blender 渲染纽约市,到虚拟看房导览。
举一个例子,下面这段对比里,我让 GPT-6 Astra 的 Medium 和 High 两档用我电脑上的鼠标,在网页版 MS Paint 里重画我的一张照片(没用 Extra High 和 Max,因为不想把 token 全花掉 :))。
这不仅展示了模型的作画能力,更重要的是它使用你电脑上工具的能力(这里是 Paint,你可以看到模型通过鼠标光标操作界面)。
这并不是第一个能在 harness 内实现通用电脑操作的模型。比如从今年早些时候起,我就用 GPT 模型完成过一些界面类任务(例如在 Excel 里处理报销相关的事情)等等。不过,电脑操作是一项相对新的能力,由 harness 提供支持,用起来通常还感觉不太成熟。这也说得通:LLM 本质上是文本模型,所以更容易摘到的果子自然是写作、编程、调用 API 和命令行。
同时,还有很多工具和软件(目前)并不提供命令行接口,与其等着有人来设计这个接口,不如直接提升模型操作图形界面的能力(而且如前所述,这样的演示本来就好看又抓人)。这有点像正在兴起的人形机器人。诚然,人形机器人并不是最高效的机器人,比如在已有专用设备的流水线上;但它们足够通用。
所以我预计,接下来几个月(或几年)也会是电脑操作在 LLM 和智能体 harness 这两层上不断打磨的时期。也就是说,除了现有能力以及继续扩展数学和编程能力之外,模型的训练会越来越多地把电脑操作考虑进来。这也会让 LLM 在科技圈之外的日常电脑任务中更容易被用起来(“嘿 ChatGPT,帮我报个税吧” :))。
1.3 电脑操作的训练
电脑操作这个趋势,也和最近的报道相吻合——OpenAI 为强化学习采购了数万台 Mac Mini 和 Mac Studio。所以这些 Mac 并不是真的用来训练模型(那件事更适合用 GPU),而是在模型训练期间把 macOS 暴露给模型,让模型学会使用这个操作系统以及其中的工具。
那么,在这些 Mac 上的电脑操作训练是怎么进行的?简单说,Mac(更准确地说是它们的 macOS 操作系统)充当一个环境,模型在训练过程中可以与之交互。
基本流程如下:
-
给模型一个任务作为提示,比如“打开某个应用 xyz 并完成 abc”。
-
向它提供 macOS 界面的截图(这通常由 harness 完成)。
-
LLM 随后预测鼠标 / 键盘动作(点击、按键、滚动等)。
-
在 Mac 上执行这些动作(同样由 harness 完成)。
-
执行上一步动作之后,把更新后环境的新截图喂给模型。
-
重复第 2–5 步,直到任务成功或失败。
-
把成功 / 失败信号和验证器(或评分器)作为训练反馈,包括在后训练阶段引入强化学习;这与常规的 “可验证奖励强化学习”(RLVR)类似。
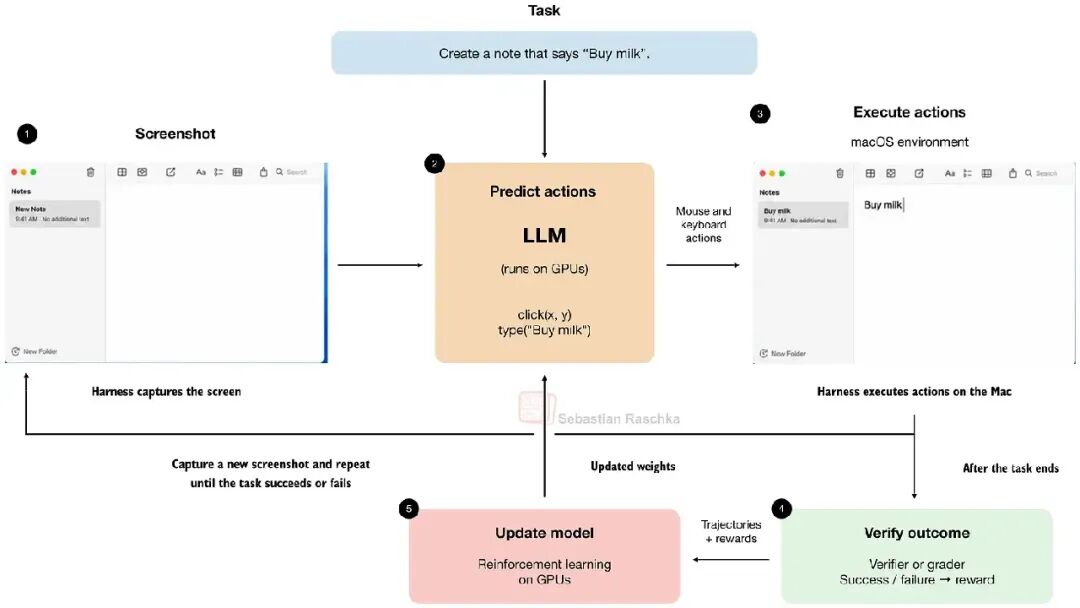
再强调一次,这里的 Mac 主要是环境,而不是训练期间运行或更新模型的机器。模型很可能跑在 NVIDIA 的 GPU 上,再通过 API 与这些 Mac 交互。顺带一提,NVIDIA 的 CEO 提到,GPT-6 Astra 是在约 10 万块 Grace Blackwell GPU 上训练的。
1.4 GPT-6 Astra 仍然是推理模型
上一节讲的以电脑操作为重点的训练,并不是训练流程上的根本范式转变。GPT-6 Astra(以及可预见未来的几乎任何 LLM)仍然是推理模型。这意味着这个 LLM 依然用可验证奖励强化学习(RLVR)来训练,并会产生中间推理轨迹(思维链)。
不过,关于 GPT-6 Astra 作为推理模型的部分(特别是隐藏思维链),我会在本文后面再讨论。
2. 循环 Transformer
话说回来,在模型正式发布前大约两天,新闻杂志 The Information 发表了一篇文章,援引一些内部消息称,Astra 使用了一种叫做“循环深度”或“循环 Transformer(looped transformers)”的概念。
图 4:The Information 原文引用(来源 https://www.theinformation.com/articles/secret-technique-behind-openais-astra-model-sparks-security-concerns)
接下来几个小节里,我会先解释什么是循环 Transformer,关于隐藏思维链的那段说法留到本文后面再谈。
(循环 Transformer 的解释可能显得有点长,但我确实认为它有助于建立对这项技术的基础理解,而这对判断 “它掩盖了推理轨迹或思维链” 这一说法很有用。)
2.1 复用 Transformer 模块
那么,什么是循环 Transformer?
循环 Transformer 本质上是一处架构上的小改动,核心思想是让中间表示多次(而不是只一次)经过同一批 Transformer 模块。与单纯增加模块数量相比,这里的 “ 窍门” 在于:这些模块的权重在多次经过时保持不变。
术语与说明
本文会用到以下术语:
循环 Transformer 并不是新东西,这个基本思路早在 2018 年的 Universal Transformers 论文里就出现过。不过在讨论 Universal Transformer 之前,我们先从一个更简单的例子说起,Nanbeige4.2-3B,这是今年七月发布的一个开放权重 LLM。
下图中的 Nanbeige 架构,看起来基本就是个常规 Transformer。不过请注意,它多了一条(橙色)箭头,绕回到 Transformer 堆叠的起点。
图 5:Nanbeige4.2-3B 把同一组 22 个 Transformer 模块应用了两次。橙色箭头标出了中间表示被送回堆叠的位置。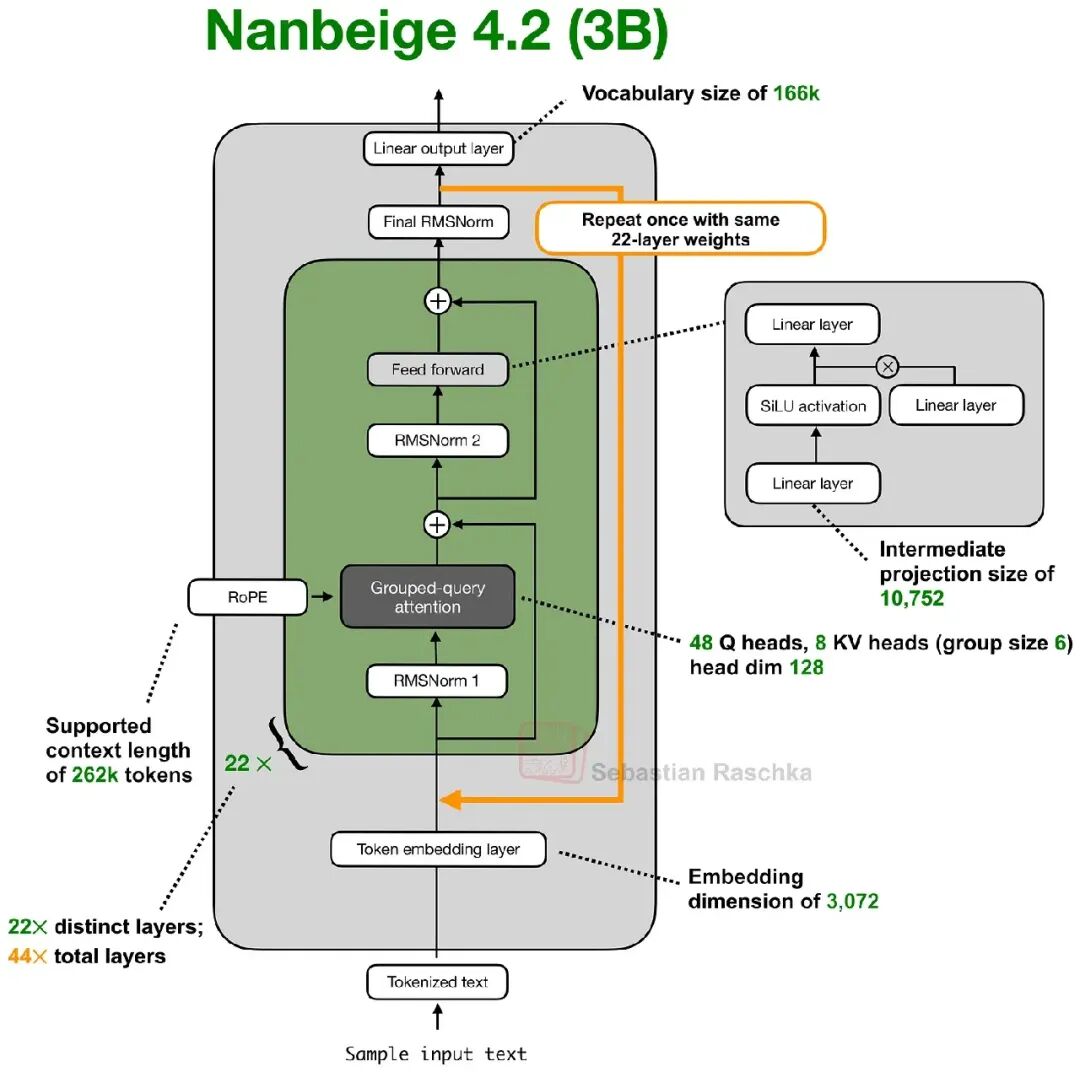
我们从下往上过一遍。首先,和其他基于 Transformer 的 LLM 一样,输入文本先被分词,再转成嵌入向量。这些向量接着经过 22 个 Transformer 模块,每个模块都有自己的权重。
而这里的循环之处在于:第一遍走完之后,隐藏状态会被送回这同样的 22 个模块。也就是说,模块 1 再被应用一次,接着是模块 2,一直到模块 22。
如果把这个计算展开,总共是 44 次模块应用。不过,与拥有 44 个各自独立模块的常规 Transformer 相比,后 22 次模块应用复用的是前 22 个模块的权重。例如,第 23 次模块应用用的是模块 1 的权重,第 24 次用的是模块 2 的权重,以此类推。
图 6:把 Nanbeige4.2-3B 展开成对同一组 22 个 Transformer 模块的两遍计算,共 44 次模块应用。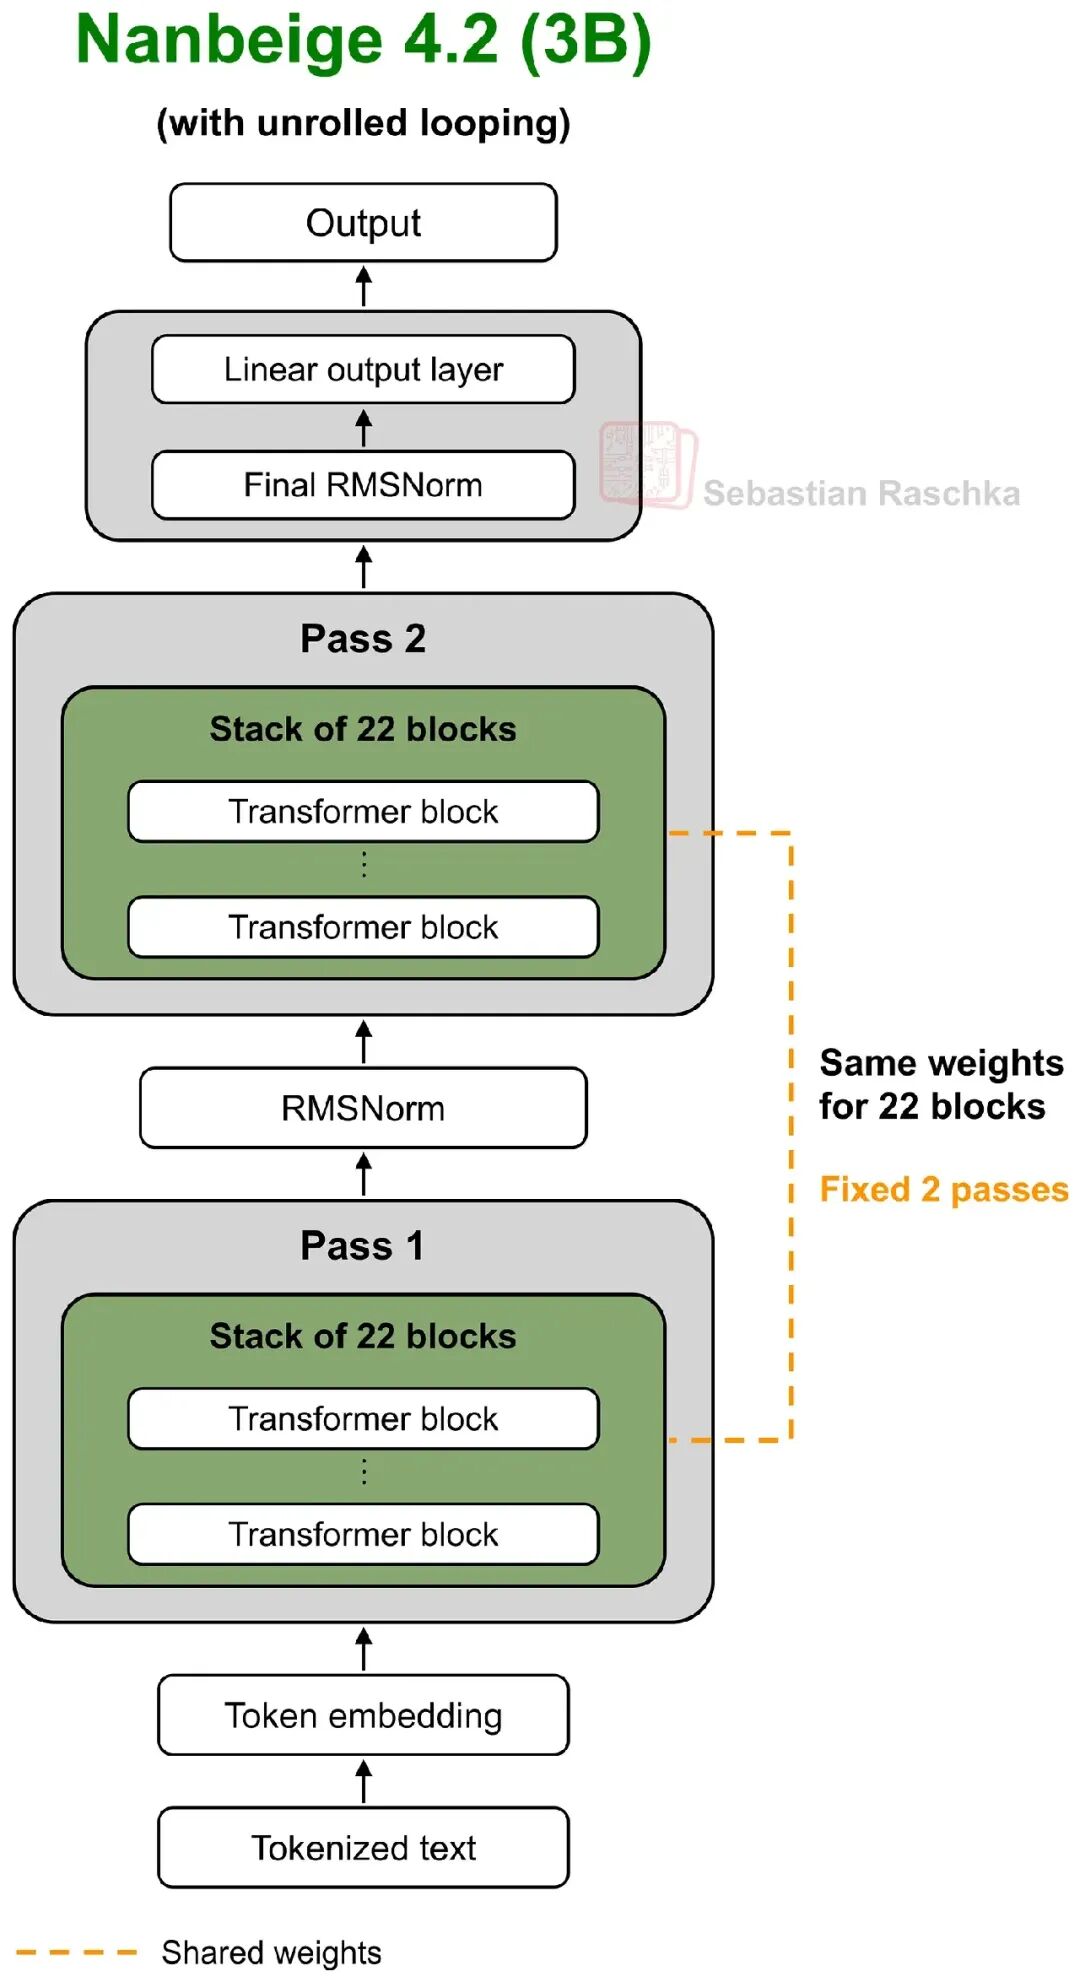
所以整个思路就是:在不增加另一套 Transformer 权重的前提下,把有效深度从 22 次模块应用提升到 44 次。
顺带一提,为什么是 2 遍,而不是 3 遍、4 遍或更多?Nanbeige 论文里细节不多,但他们表示这基本上是效率最高的设置。把循环从 2 增加到 3 能提升建模表现,但额外的计算开销并不值得。
2.2 循环的代价
那么,总体上我们为什么要做这种循环?它本质上是“通过增加 Transformer 模块把模型做大”的一种替代方案。
举例来说,把 22 个 Transformer 模块用两次的模型,其(Transformer 模块部分的)参数量大约只有拥有 44 个常规模块的模型的一半。
这也就减少了存储权重所需的内存。顺带说明一下,嵌入层和输出层通常很大、在总参数中占相当一部分,它们不在这个比较之内。(以 Nanbeige 4.2 3B 为例,嵌入层和输出层约占 30 亿总参数的 25%;如果这两层之间做权重共享,可以降到 12.5%。)
图 7:传统方案与循环方案各自需要多少参数的并排对比。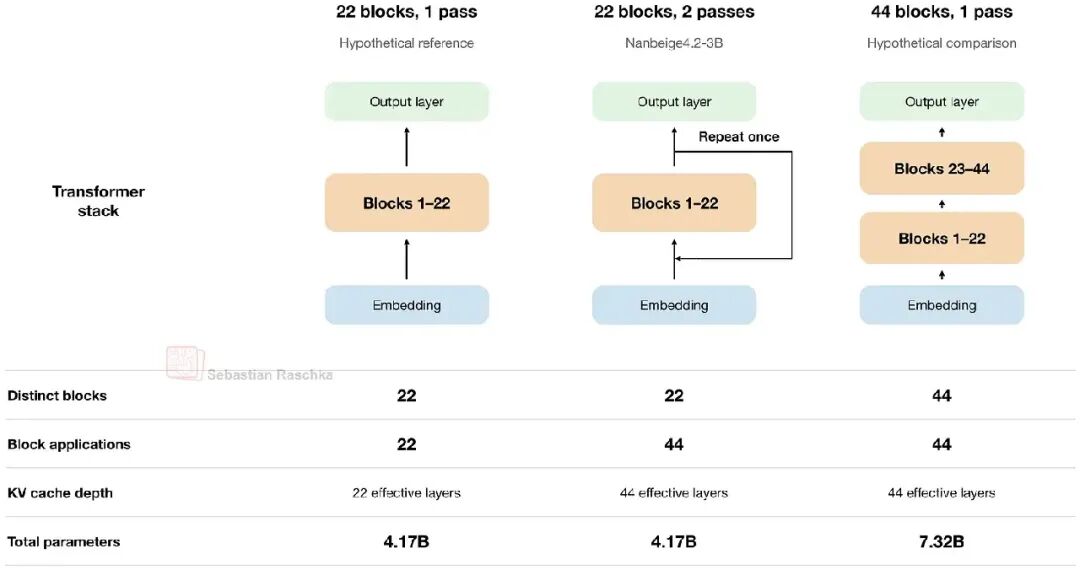
当然,在循环中复用同一批模块,计算量并不会因此减少。更准确地说,前向传播时,中间输入要经过 44 次模块应用;训练时,梯度也要在共享堆叠的两遍中反向流动。因此,相比只用一次这 22 个模块,这增加了相当多的计算量。实际上,它的开销和拥有 44 个独立模块差不多(只是优化器需要更新的独立参数更少;反向传播依然要走完全部 44 次模块应用)。
还有 KV 缓存。它会存下先前 token 的注意力键和值,以便在常规 Transformer 和循环 Transformer 生成下一个 token 时复用。
循环 Transformer 里虽然有权重共享,但第二遍进入某个模块的中间状态是不同的。因此在 KV 缓存中,这两遍 Transformer 堆叠得到的键和值也不同(和不做循环的情况一样)。所以 KV 缓存这边也省不下来。
说得更具体些,比如第 1 次和第 23 次模块应用都用到了循环设置中的模块 1,但每一次应用仍然需要自己的 KV 缓存条目。既然两遍都必须各自保留缓存,那么 “22 个模块重复两遍” 的 KV 缓存需求,就和拥有 44 个独立模块的常规 Transformer 一样。
有意思的是,Nanbeige 的研究者在论文中提到,他们试过在两遍之间共享 KV 缓存。这当然让 KV 缓存大小减半,但模型表现比缓存分开的版本更差(他们最终发布的是缓存分开的版本)。
在往下看其他循环 Transformer 设计之前,先把 Nanbeige 的讨论补完。他们的技术报告还讨论了另外两个选择或权衡:
-
从零训练这个循环架构,效果好于把已经预训练好的 Transformer 通过 upcycling(升级改造)转换过来。
-
如上一节所述,两遍是他们更倾向的权衡。更多遍只带来很小的额外收益,同时会拖慢训练,并让优化变得不那么稳定。
所以,循环遍数是我们必须做的另一个架构选择。如前所述,Nanbeige 把它固定为两遍。不过我们也可以让它取决于 token,接下来就会看到。
2.3 Universal Transformer 与灵活的循环次数
现在回到 Universal Transformers,在 Nanbeige 里,我们把一组 22 个 Transformer 模块的堆叠应用两次。而在 2018 年的 Universal Transformer 论文里,被反复应用的是同一个 Transformer 模块,而不是重复一整个堆叠。不过主要思路是类似的。
另外,步数可以是固定的,但论文也探索了自适应终止(adaptive halting)。比如,某个位置上的 token 可能只走一两次循环,另一个 token 可能走三四次,以此类推。这让模型可以灵活地把计算分配给那些能从额外计算中受益的 token。
循环次数是怎么定的?这里模型用了一个小的、训练得到的函数,在每一步为每个位置输出一个所谓的“终止概率”。它把这些概率在连续的循环中累加,一旦某个位置的累加值超过阈值,就停止在该位置继续循环。此外还设有一个最大循环次数,以防万一限制住计算量。
图 8:Universal Transformer 中的自适应终止。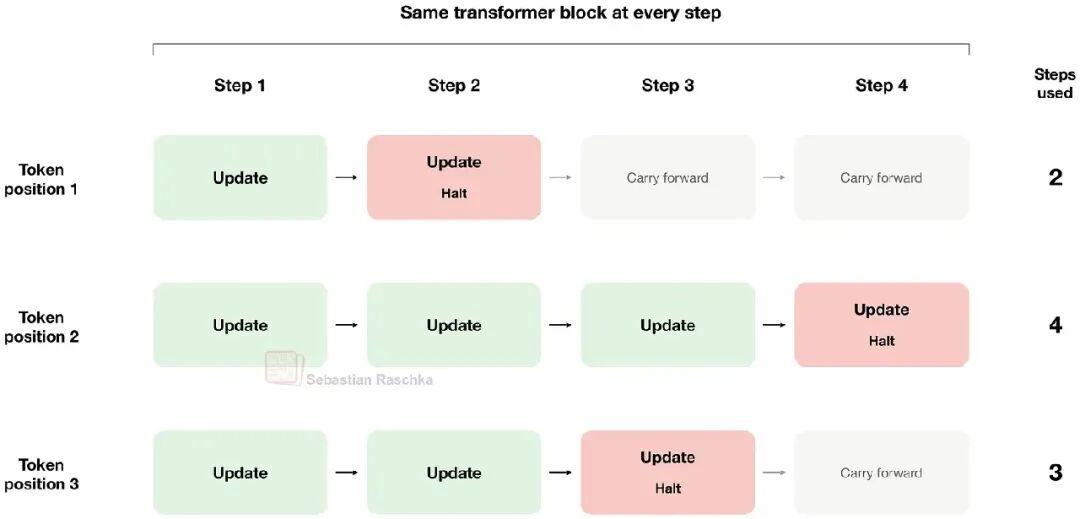
另一个循环 Transformer 的例子是字节跳动的 Ouro,比如 Ouro-Thinking 2.6B 会把同一组 48 个 Transformer 模块应用四次。这就是 192 次模块应用,而只需存储 48 个独立模块的权重。基本上,这比 Nanbeige 更极端。此外,一个学习得到的出口门控会为不同出口分配概率,再用累计概率的阈值决定由哪一遍提供输出。所以它也借用了 Universal Transformer 的自适应终止思路,而 Nanbeige 没有采用这一点。(不过这里有个实际的注意点:已发布的 Hugging Face 实现会先算完所有配置好的遍数再选输出,所以循环次数看起来实际上被硬编码成了 4。)
2.4 用路由决定灵活的循环次数
另一种做法是《Mixture-of-Recursions》,这是 2025 年的一篇论文,本质上是前面讨论的 Universal Transformer 的更精细版本。和 Universal Transformer 类似,单个 token 会一次或多次经过 Transformer 模块,如下图所示。而它的创新之处在于,这个循环次数是如何按每个 token 分别确定的。
在下面这张出自论文的图中,被循环(重复)的堆叠在这里叫做递归块。它包含若干 Transformer 模块,并被夹在独立的首、尾两个 Transformer 模块之间(图中标为 Layer 0 和 Layer L-1)。
图 9:Mixture-of-Recursions 在不同 token 位置上,对同一个共享堆叠应用不同的次数。高亮文字给出了 1、2、3 遍的示例。图改编自 Mixture-of-Recursions 论文。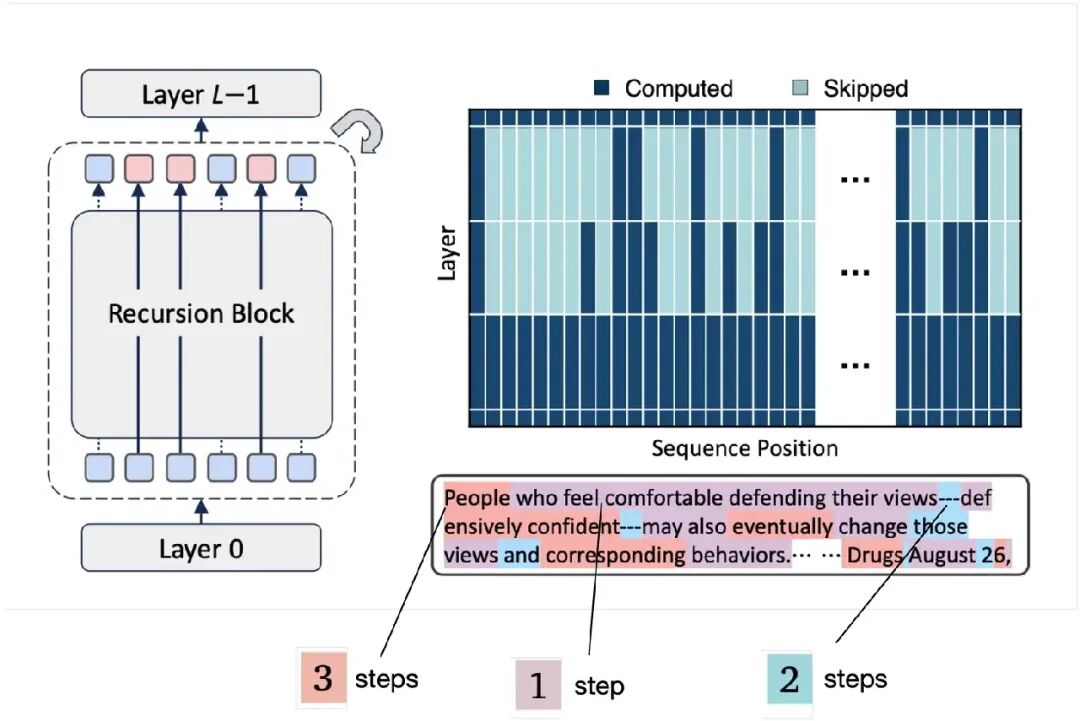
模型怎么决定一个 token 该经过递归块几次?在前面讨论的 Universal Transformer 里,靠的是每一步学习得到的终止概率。而 Mixture-of-Recursions 这里用的是一个小的、学习得到的路由器。这与混合专家(mixture-of-experts)模型里的路由思路类似,只不过这里的路由决策决定的是共享堆叠要应用多少次。
路由器作用在 token 的隐藏表示上,而这个表示也包含了它的上下文信息。所以我们不应该把它理解成“某个特定 token 每次出现都会被分配同样的遍数”(也就是说,上图中的 “People” 并不总是走 3 遍循环)。这个决策会随着该词出现的位置以及它前面的内容而变化。
那么路由具体是怎么工作的?论文探索了两种做出这一路由决策的方式,如下图所示。
图 10:选择递归深度的两种方式。左边是每一步由路由器选出哪些 token 继续;右边是由单个路由器在一开始就分配好遍数。图出自 Mixture-of-Recursions 论文。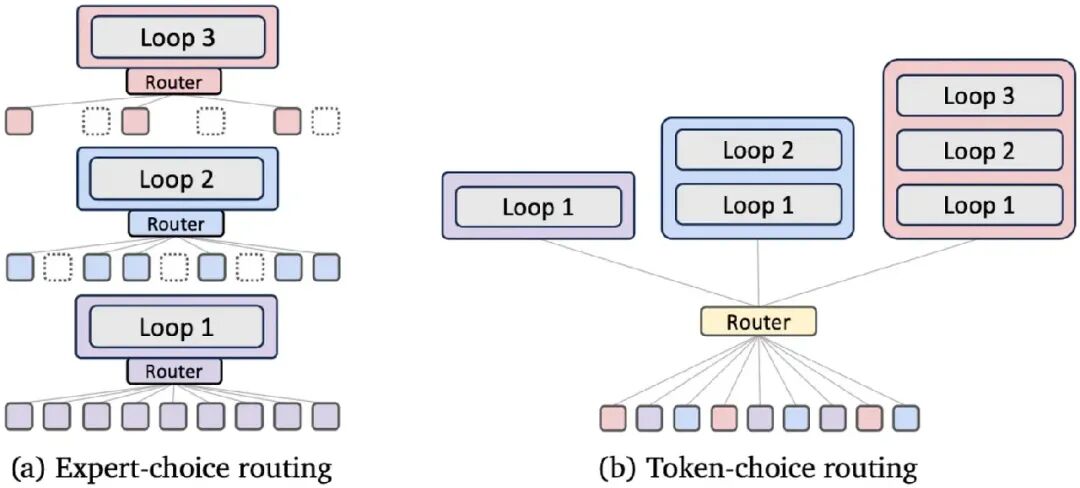
在专家选择路由(expert-choice routing,上图左侧)中,每一步递归自行选出它要处理的 token,退出的 token 不再参与后续步骤。在 token 选择路由(token-choice routing,右侧)中,路由器在一开始只做一次决策,把每个 token 分配到走 1 遍、2 遍或 3 遍的路径上。
两种方式下,Transformer 权重都在各遍之间复用,这和 Nanbeige 等做法类似。而额外的灵活性来自“每个 token 获得多少计算”这一选择。模型和它的路由器是一起训练的,所以模型会在训练中学会使用这些不同的路径。
2.5 效果怎么样?
下面这张出自 Mixture-of-Recursions 论文的图,比较了常规 Transformer(Vanilla)、固定递归的 Transformer(Recursive)和 Mixture-of-Recursions(MoR)在不同模型规模和计算预算(横轴)下的表现。
图 11:四种模型规模、三种训练计算预算下的验证损失。图出自 Mixture-of-Recursions 论文。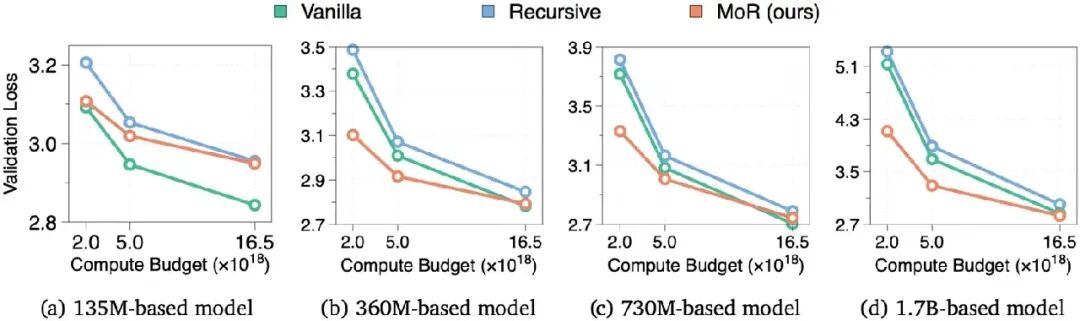
在最小的模型规模上,常规 Transformer 表现最好。在更大的模型上,Mixture-of-Recursions 追了上来,并且往往表现更好,在训练预算较小时尤其如此。在预算最大时,有几条曲线已经非常接近。所以,优势取决于模型规模,以及我们在训练上花了多少计算。
这里还有个细节:训练计算量相同,并不一定意味着训练 token 数相同。由于可以跳过一部分计算,Mixture-of-Recursions 能在同样的预算内处理更多 token。
我觉得这是个有意思的例子,因为它说明循环 Transformer 这个思路里还有好几个选择,也就是每个位置循环多少次、以及这件事由什么来决定。
所以简单说,如果模型足够大,使用循环 Transformer 可以在固定计算预算下提升模型质量。(这也说明了做一些规模化实验的重要性;比如只看 1.35 亿参数的那个较小模型,我们会得出完全相反的结论。)
3. 题外话:循环神经网络(RNN)
顺带一提,如果你有深度学习背景(甚至可以追溯到 1990 年代的人工神经网络),那么循环或 “循环深度” 这个想法应该不会太陌生。还记得循环神经网络(RNN)吗?RNN 的全部思路就是复用上一次迭代的层(权重)。
图 12:RNN 示意图(出自我 2022 年的 Machine Learning with PyTorch and Scikit-Learn 一书,https://amzn.to/3YzRnPR)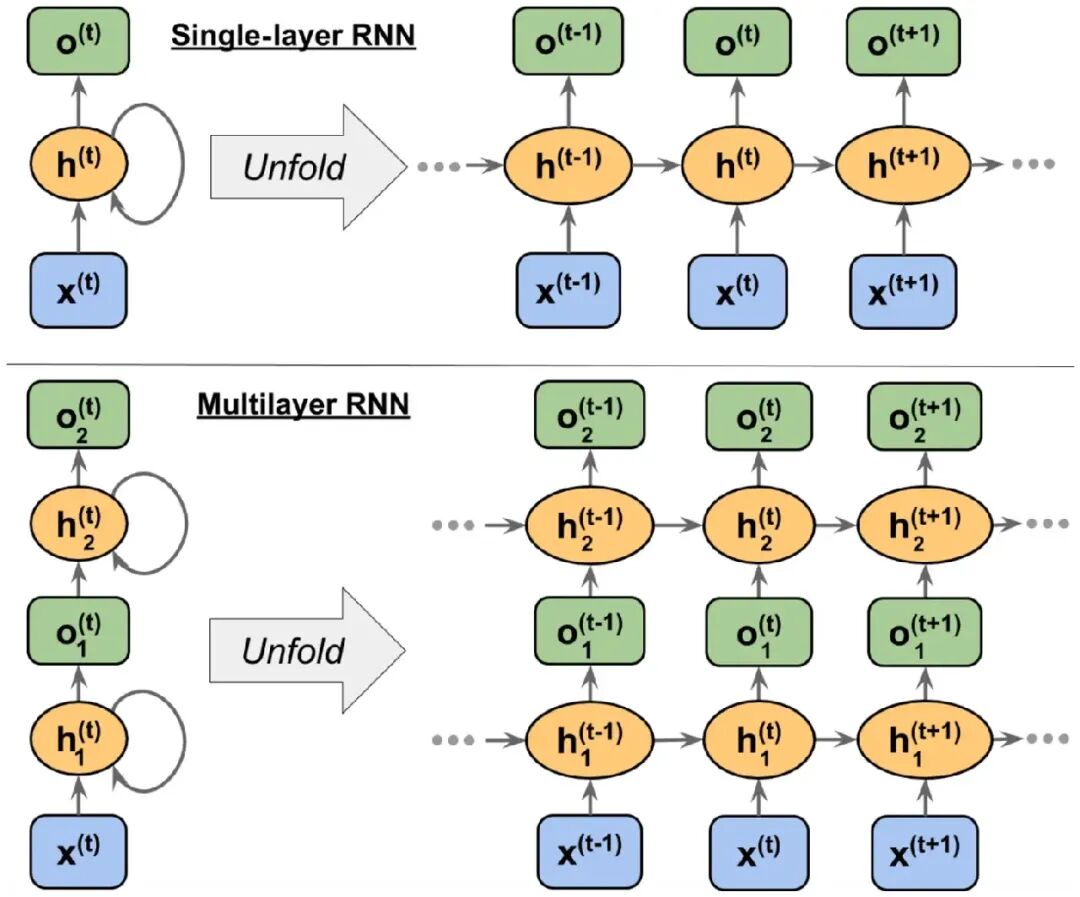
两者的主要区别在于,RNN 是在时间步之间复用权重,也就是把隐藏状态从一个 token 传递到下一个 token;而在循环 Transformer 中,一个 token 的循环发生在架构的深度方向上。
或者换个说法:在常规 RNN 中,每一步接收输入序列中的下一个元素,以及上一步的隐藏状态。所以当 RNN 处理一段文本时,它一次读一个词或 token,并通过隐藏状态把前面词的信息往后传。
而在循环 Transformer 中,某个 token 的中间表示会多次经过 Transformer 堆叠。模型仍然靠注意力在 token 之间传递信息。
如果这个类比让你有点晕,那也不必太在意。理解循环 Transformer 也许更简单的方式是:把它看成复用 Transformer 模块——类似于把模型做大,只是权重是共享的。
图 13:RNN 与循环 Transformer 中“循环”机制的并排对比。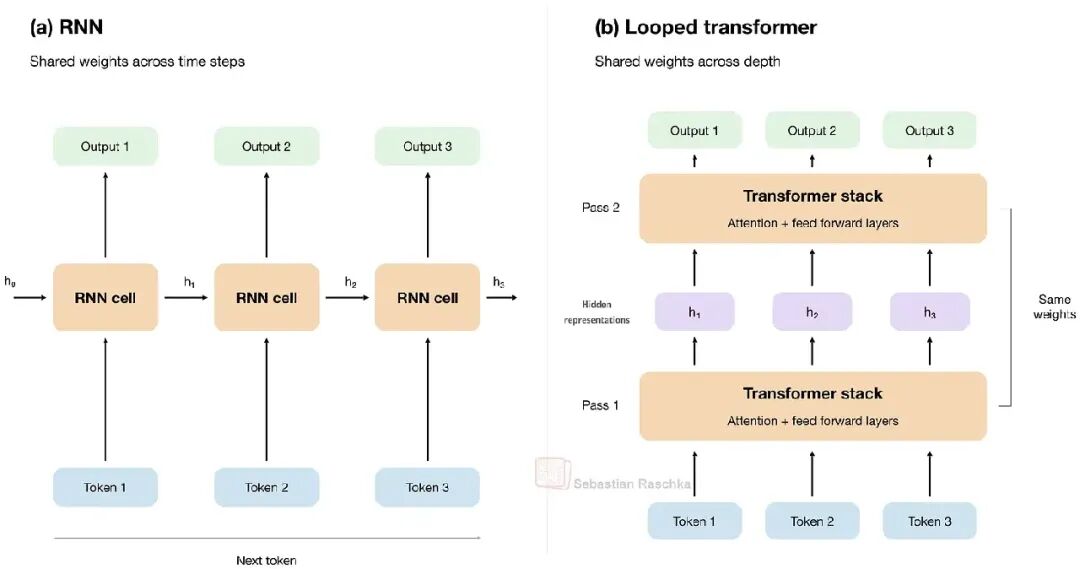
4. Astra 到底用了循环 Transformer 吗?
在讨论循环 Transformer 机制是否掩盖了推理轨迹(正如前面 The Information 引文所传的那样)之前,先问一句:GPT-6 Astra 到底有没有用循环 Transformer 的概念?
图 14:The Information 原文引用(来源 https://www.theinformation.com/articles/secret-technique-behind-openais-astra-model-sparks-security-concerns)我们得记住,这目前仍然只是传闻或独家爆料,没有官方确认。如果这个模型是开放权重的,我们当然可以自己核实一下,但眼下只能依赖未经证实的报道。
不过,我认为 GPT-6 Astra 很可能用到了循环 Transformer 的某些做法。第一,有上面提到的报道。第二,这是一项在过往研究中已显示出潜力的技术(前面已讨论),那为什么不用呢?第三,OpenAI 的首席科学家说过下面这段话:
[...] 我们当前前沿模型(包括 Astra)的计算图深度,与 GPT-4 相差不超过两倍。 [...]
不过,这并没有明确确认循环 Transformer 架构,它也可能只是意味着他们用了两倍数量的常规 Transformer 模块。
在我看来,Astra 的成功(即良好的建模表现)背后很可能主要是别的原因,也就是更好的训练配方和训练数据。
循环 Transformer 这处改动或许有一点帮助,但我认为 The Information 高估了它的贡献。
5. 隐藏思维链
接下来,我们终于要面对那个谁都不愿先提的问题:循环 Transformer 会掩盖推理轨迹吗?
首先,从 OpenAI o1 起,OpenAI 就一直对用户隐藏(大部分)推理轨迹。所以对终端用户来说,应该不会有太大差别。
因此,可解释性方面的担忧主要是针对模型开发者的。
无论如何,我并不认为循环 Transformer 是隐藏或掩盖思维链的重要原因。为了说明我的推理过程(这里没有玩双关的意思),我们先退一步,讲讲推理模型是怎么工作的。
5.1 推理简述
推理模型通常会在给出最终答案之前生成一些中间步骤。这些步骤使用的是普通文本 token(在某些用户界面中可以选择对用户隐藏),被称为推理轨迹或思维链。
举个例子,假设我们要找两个数,和为 10、积为 21。在下图中,模型一开始试了 5 和 5。和是对的,但积是 25,不是 21。接着它又试了 3 和 7,并再次检查这两个条件。
图 15:一段示意性的 LLM 回答,标注出了中间步骤、回溯和最终答案。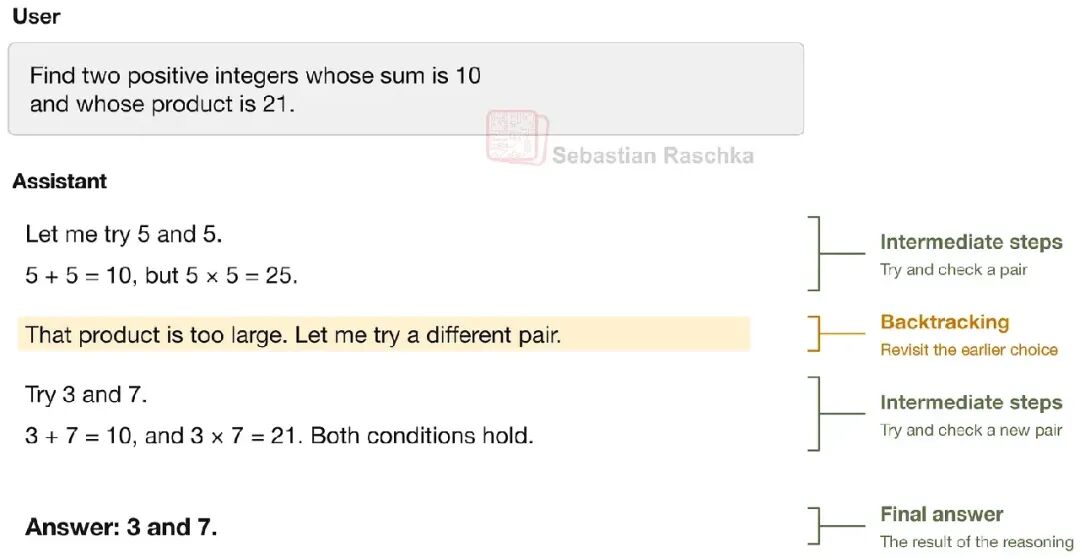
这张图展示了推理模型是怎么“推理”的,包括回溯。也就是说,模型注意到一处错误,回到先前的某个选择,然后换一种做法继续。
注意,模型仍然是一次生成一个 token,并把提示词和前面的 token 作为上下文。所以这些中间步骤起的是草稿纸的作用,在最终答案之前增加了计算。
如上面这个例子所示,最终答案可以比它前面的推理轨迹短得多。(OpenAI 往往会对用户隐藏大部分推理轨迹。)
关于推理模型的理解与开发,更多细节推荐我的书《从零构建推理模型》(图灵即将出版)。
图 16:我的《从零构建推理模型》(图灵即将出版)一书讲解了推理模型的基础原理。
5.2 token 用量与更短的思维链
推理轨迹里多出来的 token 会带来更多计算。循环 Transformer 也会带来更多计算,因为 token 要经过更多 Transformer 模块。有人可能会说,一个带循环的模型在内部用了更多计算,那它就不需要那么多对外可见的“思考 token”。
下面是部分 GPT-6 基准测试,横轴是输出 token 数。
图 17:选自 https://openai.com/index/gpt-6-astra/ 的 GPT-6 Astra 基准测试。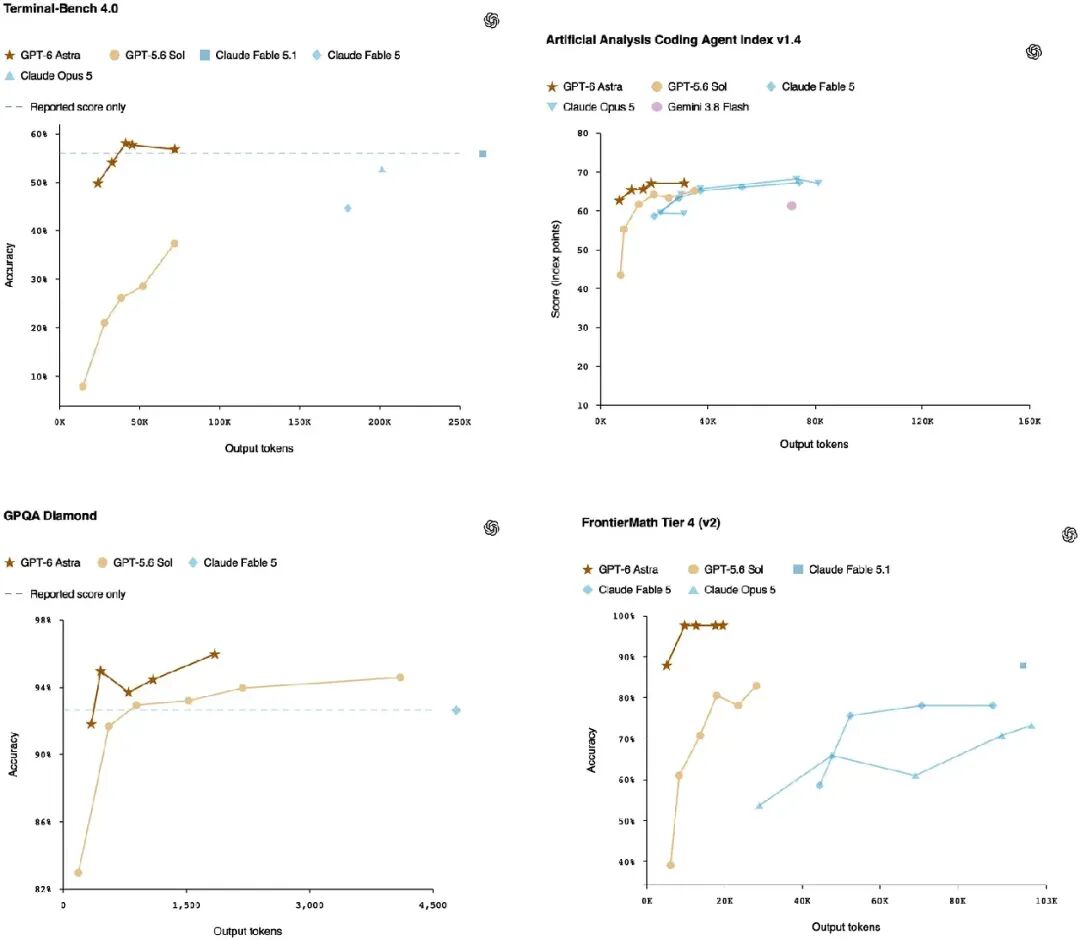
可以看到,在各个 effort(推理强度)档位上整体来看,GPT-6 Astra 用的 token 并不一定比前代 GPT 5.6 Sol 更少。不过,在相同准确率下,GPT-6 Astra 用的 token 确实比 GPT 5.6 Sol 少。
这是可解释性方面的隐患吗?不一定。token 用得更少,可能只是意味着模型更强、犯的错更少、回溯更少,等等。也就是说,它可能更多地一次就答对了。对我来说,这并不会立刻引发对可解释性的担忧。
我的意思是,以前的模型也一样。我不认为有谁会强烈担心 GPT 5.6 Sol 的可解释性远逊于更小的 GPT 5.6 Luna——后者在同等任务表现下要用多得多的 token,如下图所示。
图 18:Luna 与 Sol 在任务表现相近时的 token 用量。数字来自 Artificial Analysis 智能指数 v4.3。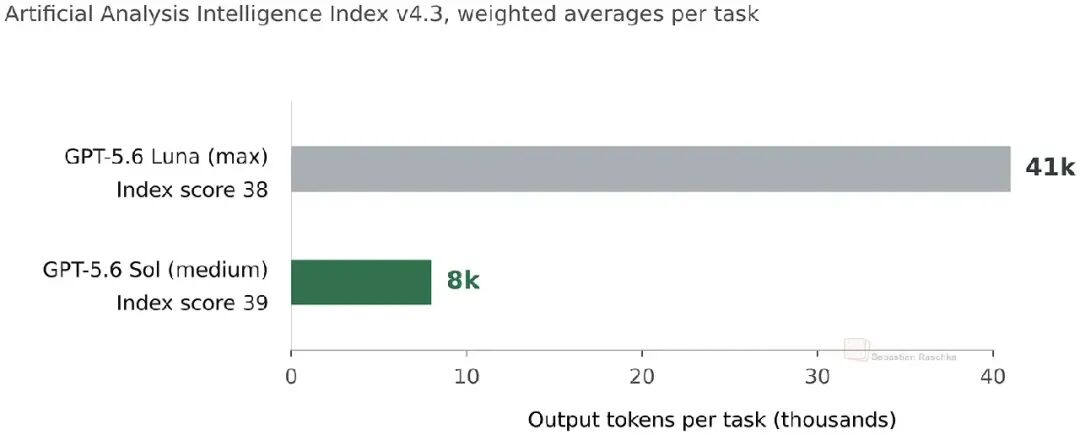
事实上,我们可以看到,在建模表现相近的情况下,Luna 比 Sol 多用了 80% 的 token。这是否就意味着 Sol 的可解释性差了那么多?
更合理的解释是:更强的模型(更大、训练更好、用了更多计算)能更高效地解决问题,这里的“高效”指的是用更少的 token。
另外也值得记住,推理轨迹并不保证忠实地描述模型内部发生的一切。在我看来,唯一站得住脚的担忧是:循环 Transformer 会比常规 Transformer 更频繁地给出“伪造”的推理轨迹,从而有意误导用户。但我认为我们并没有什么有力证据表明这正在发生。
至于 Astra 的系统卡,它确实提到有证据显示其推理轨迹的可监控性下降了,相对 Sol 有一些退步。这主要与更短、信息更少的轨迹相关。但同样,这并不能确立循环就是根本原因。它也可能只是源于整体上更短的长度,就像上面 Luna 与 Sol 的例子那样。
在我分享了关于循环 Transformer 与隐藏推理链的看法之后几个小时,OpenAI 首席科学家 Jakub Pachocki 也给出了如下澄清:
我想避免因为混乱的报道而引发一场“冲向不可监控性”的竞赛。我们当前前沿模型(包括 Astra)的计算图深度,与 GPT-4 相差不超过两倍。从我们最早的推理模型开始,OpenAI 就一直在努力保留并利用思维链监控。我们非常看重这项技术,因为它能让我们看到模型对齐是如何从训练分布中泛化出来的。我确实认为它很脆弱,而且遗憾的是正朝着不好的方向发展,其原因并不取决于架构变化,我很快会写文章说明。不过我们有办法加强它,这也是我们当前研究计划的一个核心目标。
这里说的“混乱的报道”,很可能指的就是前面 The Information 那一段,也就是在暗示循环这一点与思维链的变化没有关系。
6. 循环 Transformer 相关研究
最后,除了前面已经讨论过的,我还想分享几篇与循环 Transformer 架构相关的有意思的论文。
6.1 潜在推理
与 Universal Transformer 相关,2025 年的论文《Scaling up Test-Time Compute with Latent Reasoning: A Recurrent Depth Approach》研究了模型如何在推理阶段使用额外的循环。为此,他们用 8000 亿 token 训练了一个 35 亿参数的模型——规模不大,但也不算极小。
它不像 Universal Transformer 那样反复复用同一个模块,而是像 Nanbeige 那样重复一个堆叠;不过与 Nanbeige 不同的是,它把这个由四个模块组成的共享堆叠,夹在 2 个起始模块和 2 个末尾模块之间。
另一个与 Nanbeige 不同的地方是:共享堆叠在每次循环开始时,除了上一次循环的隐藏状态之外,还会接收起始模块的输出。两者先被拼接,再经过一个学习得到的线性投影,然后进入这四个共享模块。你可以把这理解为:让堆叠在每一遍都能拿到同样的初始输入表示。整体结构总结在下图中。
所以简单说,这是循环 Transformer 的另一个有意思的变体。
图 19:Geiping 等人的潜在推理模型的概念性总结。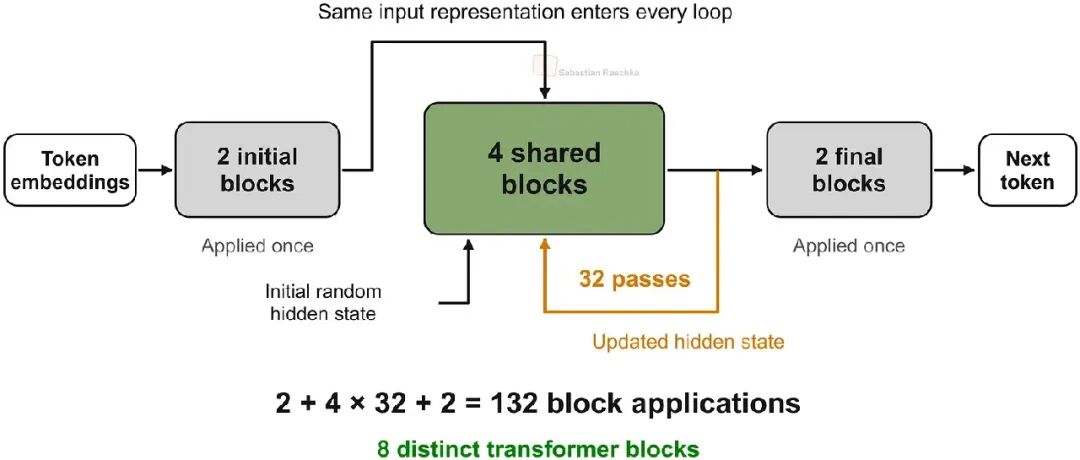
一个有意思的细节是,研究者在训练时会改变循环次数。这让模型做好准备,在推理时应对不同的计算量。
具体来说,训练时循环次数是随机采样的;推理时,由运行模型的人选定一个固定预算,比如 8、32 或 64 次循环。此外,他们还基于下一个 token 的概率分布,为每个 token 设计了自适应停止机制:如果连续两轮之间的 KL 散度低于某个阈值,也就是两个分布过于接近,就停止循环。
整体收益取决于任务。在他们的评测中,HellaSwag 的表现在大约八次循环后基本趋平,而 GSM8K 和 HumanEval 则能从更多循环中受益。
不过,尽管论文标题里提到 “潜在推理”,这个模型依然可以生成文本形式的思维链。循环只是在每个输出 token 之前给了它额外的计算。
6.2 知识检索与推理的区别
“存储信息”和“用信息解决问题”之间有一个有用的区分。比如 2025 年 6 月的论文《Beyond Parameters: Exploring Virtual Logic Depth for Scaling Laws》就分别测量了 LLM 的记忆能力和推理能力。
首先,在记忆实验中,参数量固定时,循环几乎不会改变模型存储的信息量。而增加独立参数的数量确实能提升这一容量。由此我们可以得出:循环并不会让模型存下或检索到更多知识。这也说得通——信息一旦存好,检索本身是个相对简单的任务。另外,循环本身是一种计算机制,而不是 “存储” 机制。
其次,在另外单独的推理实验中,复用模块能在不增加参数的情况下提升多步数学题上的表现。这很有意思。这里我们可以得出:即使模型并没有更多空间来存储信息,额外的计算也能帮它解决问题。当然,更大的模型同样能提升推理能力(只是它们也增加了参数)。
图 20:在这项记忆测试中,容量随参数量增长,但随额外的模块应用几乎不变。图片来自 Zhu 等人,含标注。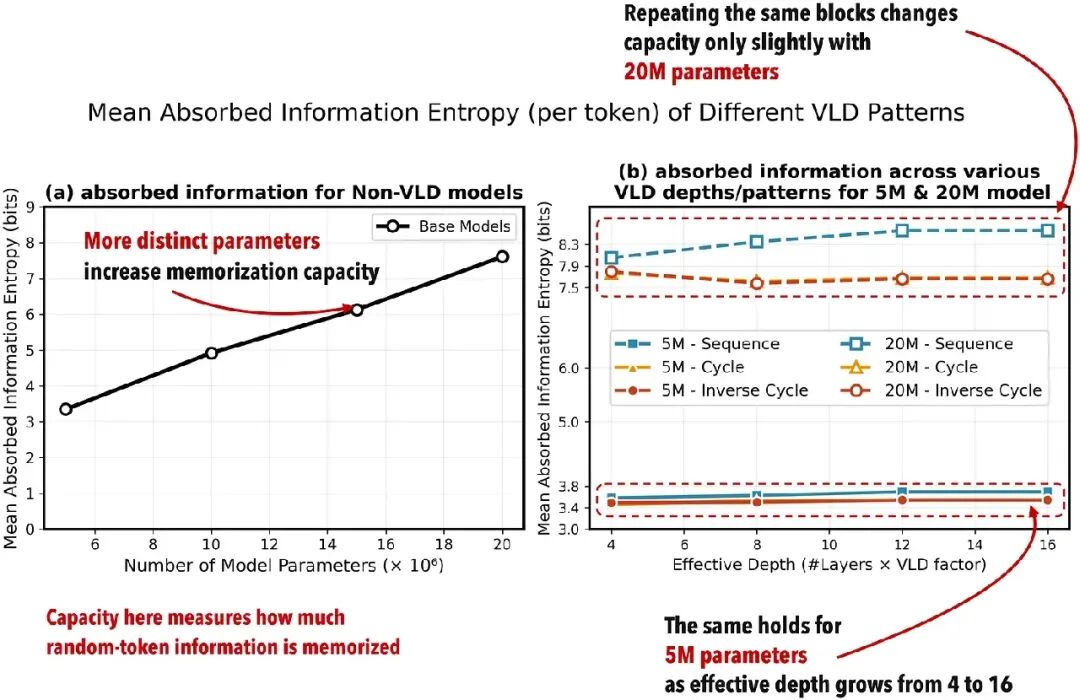
6.3 相同计算预算下的循环
刚刚发布的 2026 年 9 月论文《SMELT: Scaling Laws for Compute-Matched MoE Looped Transformers》回到了 2.2 节的成本对比。如果我们让循环 Transformer 和常规 Transformer 在每 token 计算量、非嵌入总参数量以及 KV 缓存需求上都大致相同,会发生什么?
研究者使用混合专家(MoE)架构,把 Transformer 中间那一半的模块应用两次,有点像 Nanbeige,只是加上了 Latent Reasoning 里的夹心结构。
不过,为了补偿额外模块应用所需的计算,他们收窄了隐藏维度。而这会让参数量变少,于是他们又增加专家数量把总参数量补回来。他们还调整了注意力头的配置,以保持 KV 缓存相当。
图 21:SMELT 概览,取自 SMELT 论文 3.2 节给出的示例,对比了模型宽度、专家数、模块应用次数、参数量、计算量和 KV 缓存。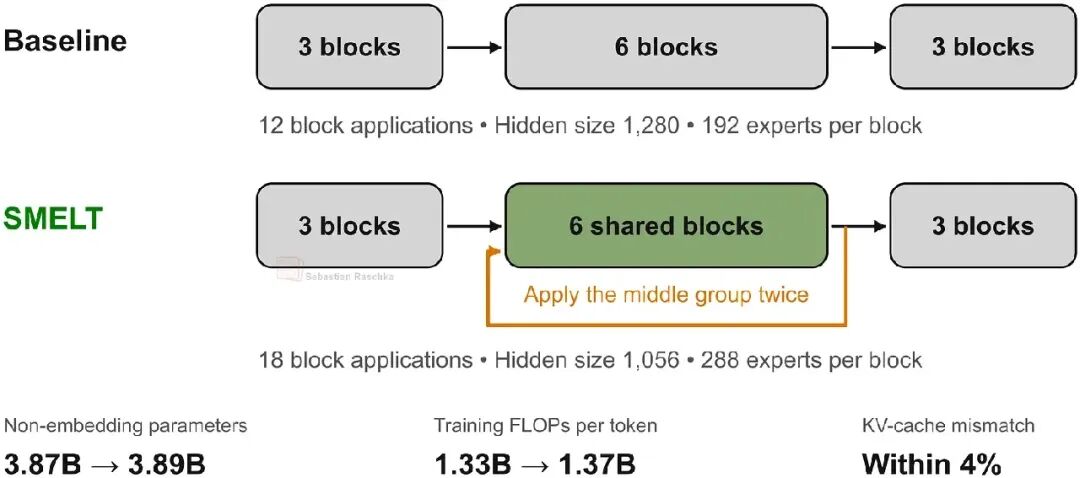
实验规模最高做到 540 亿非嵌入参数等。随后,研究者通过拟合的规模曲线估计:在所研究的计算范围内,SMELT 达到同样的验证损失所需的训练计算量少约 6.8%–18%。
所以这就回答了“循环 Transformer 在计算上值不值”这个问题:值!在使用同样的计算预算时,它们能给我们一个略好一些的模型。
6.4 Full-bandwidth Transformer
最后,同样很新的 2026 年 8 月论文《Full-bandwidth transformer》研究的是跨 token 位置的循环。在每一步解码时,它通过一个学习得到的门控,把上一个 token 的最终隐藏状态与新采样 token 的嵌入结合起来,作为下一次前向传播的输入。
于是,下一个 token 的计算在堆叠底部就能获得上一个 token 的最终表示,这和 Latent Reasoning 有些相似。
在使用 10 亿参数的基础模型时,他们发现这种潜在反馈方法在 MATH500 上会输出更短的推理轨迹,同时准确率保持不变甚至有所提升。不过,这种变短的效果在指令微调之后就消失了。
图 22:潜在反馈让基础模型的推理轨迹变短,但这一效果在指令微调后消失。改编自 Wang 等人论文图 6,CC BY 4.0,并补充了定义与注意事项。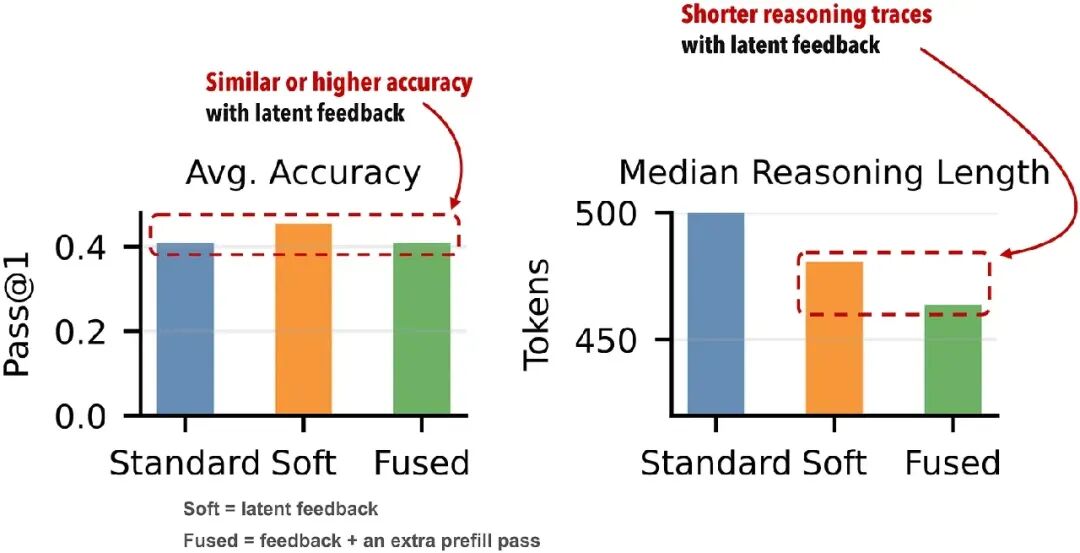
总之,这一点很有意思,因为它直接关联到前面关于“循环是否会让推理轨迹变短”的讨论。当然,结果既取决于反馈机制,也取决于模型是怎么训练的。另外,这个实验并没有确立这些更短的轨迹是否更不忠实。
还有,这项研究的一大注意点是:他们没有测试用常规方式增大模型(增加 Transformer 模块而不是循环)是否会对推理轨迹长度产生类似影响。
结语
总结一下:是的,OpenAI 的 GPT-6 Astra 是个非常强的模型,而且它在电脑操作上迈出了特别大的一步。我相信,接下来几个月里,电脑操作会是开源和闭源 harness 的下一个重点方向。在电脑操作这件事上,我觉得开源尤其重要,因为“能力越大,责任越大”——在把我主力电脑的访问权交出去之前,能先审查这个 harness,是件让人安心的事。
此外,GPT-6 Astra 很可能使用了循环 Transformer 的某种变体。循环 Transformer 就是能在固定计算预算下带来更好的建模表现。
另外,更好的建模表现可能会让推理链变短。但这不是什么新趋势。在同一模型家族里、不同规模的模型之间,我们一直都能看到这一点(比如 GPT 5.6 Luna 与 Sol 的对比)。
在我看来,推理轨迹变短是模型更“聪明”、更强的一个副作用:它们犯的错更少,并且能在架构内部调用更多计算,而不必把推理轨迹当草稿纸用。某种意义上,人也是这样。在线下的大学数学考试里,一个聪明且准备充分的学生大概会更少用到草稿纸,也更少需要回头重算,等等。
感谢阅读,如果你想学着自己构建推理模型,可以期待我的新书《从零构建推理模型》(图灵即将出版)。我们从一个预训练好的 LLM 出发,一步步加上推理能力,配有你可以运行和试验的代码。这件事既有意思也有收获,也是一笔投资——为将来的自己打好基础,跟上 AI 领域的发展。
另外,如果你读过我的《从零构建大模型》,我会很感谢你在各个平台留下一段简短、诚实的评价。书评能帮助其他读者判断一本书是否适合自己,也是支持作者的一种简单方式。
图 23:选自我《从零构建推理模型》一书的部分插图,涵盖推理阶段的算力扩展、蒸馏和强化学习。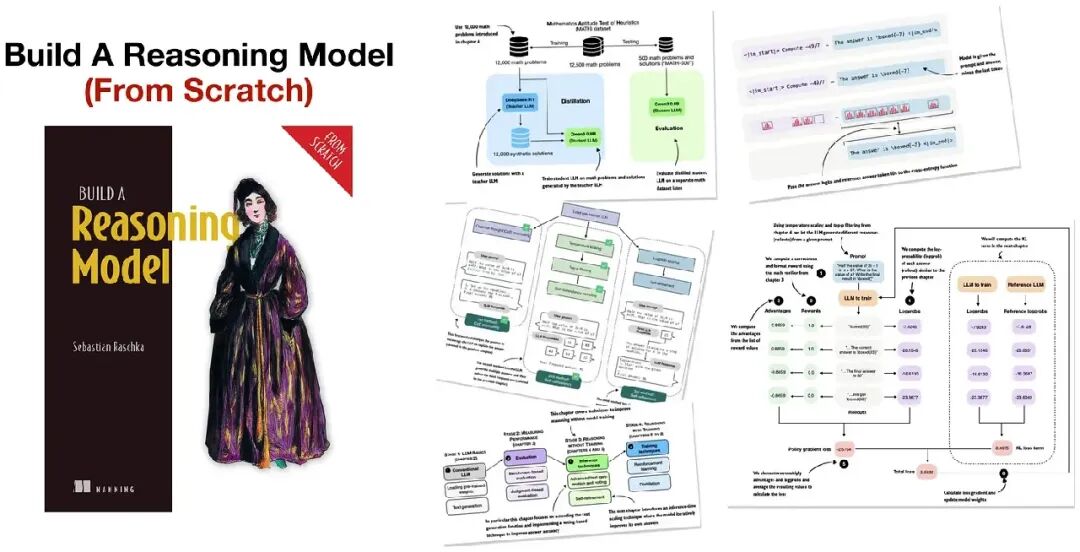
参考阅读:
1. ARC-AGI-3 基准
https://arcprize.org/arc-agi/3
2. Artificial Analysis 编程智能体指数 v1.4
https://artificialanalysis.ai/agents/coding-agents#coding-agents-index
3. Artificial Analysis 智能指数
https://artificialanalysis.ai/evaluations/artificial-analysis-intelligence-index
4. Stirrup
https://github.com/ArtificialAnalysis/Stirrup
5. 用 Blender 渲染纽约市
https://x.com/higgsfield_ai/status/2096495974734794840?s=20
6. 虚拟看房导览
https://x.com/Dimillian/status/2095596700815516004?s=20
7. Universal Transformers
https://arxiv.org/abs/1807.03819
8. Nanbeige4.2-3B
https://arxiv.org/abs/2607.22083
9. Universal Transformers
https://arxiv.org/abs/1807.03819
10. Ouro
https://arxiv.org/abs/2510.25741
11. Mixture-of-Recursions
https://arxiv.org/abs/2507.10524
12.《Scaling up Test-Time Compute with Latent Reasoning: A Recurrent Depth Approach》
https://arxiv.org/abs/2502.05171
13.《Beyond Parameters: Exploring Virtual Logic Depth for Scaling Laws》
https://arxiv.org/abs/2506.18233
14.《SMELT: Scaling Laws for Compute-Matched MoE Looped Transformers》
https://arxiv.org/abs/2609.01343
15.《Full-bandwidth transformer》
https://arxiv.org/abs/2608.08888
原文:GPT-6_Astra,_Looped_Transformers,_and_Hidden_Reasoning.md
原文地址:https://magazine.sebastianraschka.com/p/gpt-6-astra-looped-transformers-an