拆解GaussDB三类DDL路径、锁风险及生产变更评估要点。
冷月清谈:
怜星夜思:
2、在线DDL不怎么阻塞读写,是不是就可以放心在业务高峰期执行?
3、毫秒级AccessExclusiveLock听起来很短,为什么仍可能引发整库会话堆积?该怎么防?
4、原生在线DDL、CREATE INDEX CONCURRENTLY和应用层双写迁移,实际应该怎么选?
原文标题:GaussDB数据库中DDL算法机制
原文作者:牧羊人的方向
原文内容
GaussDB数据库中的DDL机制上分为纯元数据变更、表重写以及在线DDL操作。本文介绍其中的DDL算法原理、与MySQL中DDL算法对比以及常见的DDL操作影响评估。
1、GaussDB数据库中的DDL算法体系
MySQL 8.0在ALTER TABLE语句中提供了显式的ALGORITHM参数,可选值为INSTANT、INPLACE、COPY三种,由优化器根据操作类型自动选择或由用户强制指定。GaussDB(for openGauss,以下简称GaussDB)的内核源自PostgreSQL,其DDL执行路径与MySQL不同,GaussDB中不存在与MySQL完全对等的ALGORITHM参数,也没有用户可指定的算法选项。
从内核实现上看,GaussDB(继承openGauss内核,血缘上来自PostgreSQL)后台存在三类执行路径,与 MySQL 的三种算法在行为上可以对应:
-
纯元数据变更(Catalog-Only):仅修改pg_attribute/pg_class/pg_description等系统表,不会修改用户数据页,因此DDL操作很快完成。对应MySQL中的INSTANT算法,持有毫秒级的AccessExclusiveLock锁
-
全表重写(Table Rewrite):新建一个临时relfilenode,全表逐行拷贝转换,最后原子切换。对应MySQL中的COPY算法,整个过程中持有排他锁AccessExclusiveLock
-
在线DDL(Online DDL,V500R002C00+):后台建新表并全量搬迁数据,再基于逻辑解码的增量日志追平,最后短暂加锁原子切换。机制上和MySQL的NPLACE "基线迁移+增量追平"思想一致,机制上更接近gh-ost / pt-osc的内核原生版。
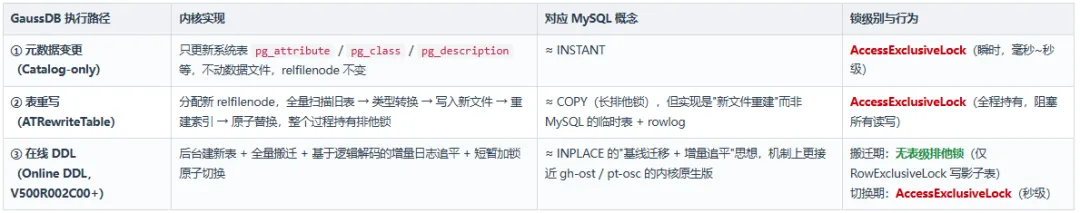
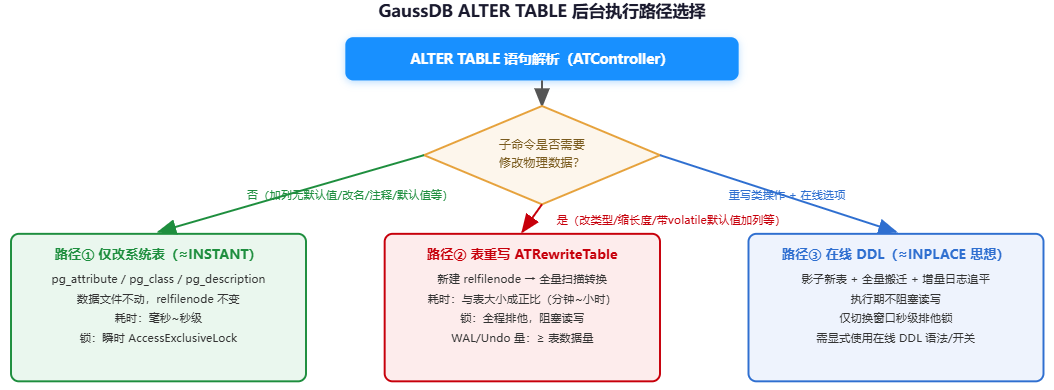
另外索引构建有一条独立的并行路径:CREATE INDEX CONCURRENTLY(两阶段扫描+增量合并),行为类似MySQL的在线建索引。GaussDB的ALTER TABLE还有一个与MySQL不同的关键特性,DDL是事务性的,整个重写过程在一个事务内完成,失败可整体回滚,不会像MySQL COPY算法那样留下半成品临时表。GaussDB中ALTER TABLE执行路径判定如下:
GaussDB中采用8级表锁模型(与PostgreSQL一致),由弱到强如下:
AccessShareLock → RowShareLock → RowExclusiveLock → ShareUpdateExclusiveLock
→ ShareLock → ShareRowExclusiveLock → ExclusiveLock → AccessExclusiveLock
8级锁冲突矩阵如下:
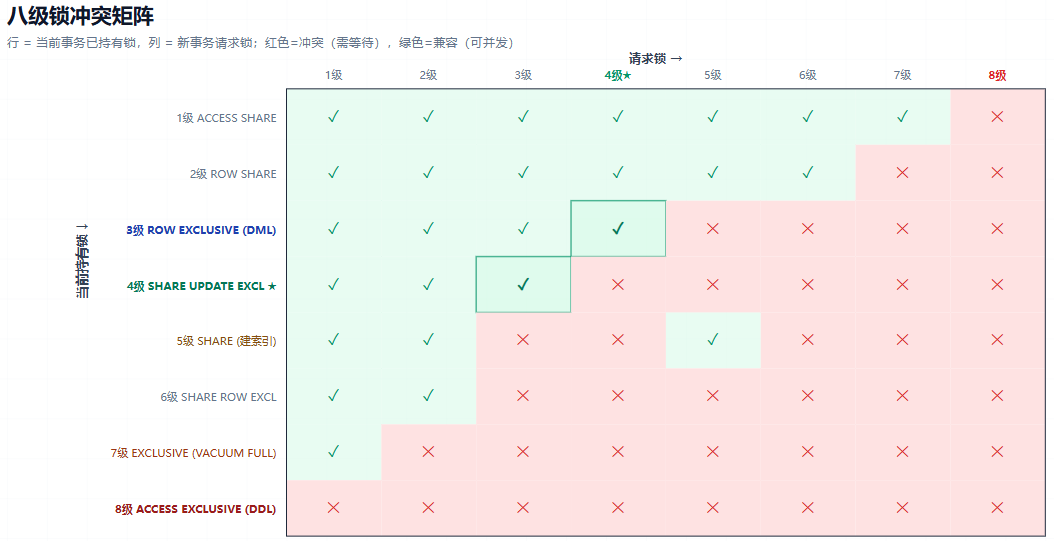
绝大多数DDL默认获取AccessExclusiveLock(8级),这是最强的排他锁,与所有其他锁模式冲突。少数操作使用较低级别锁:
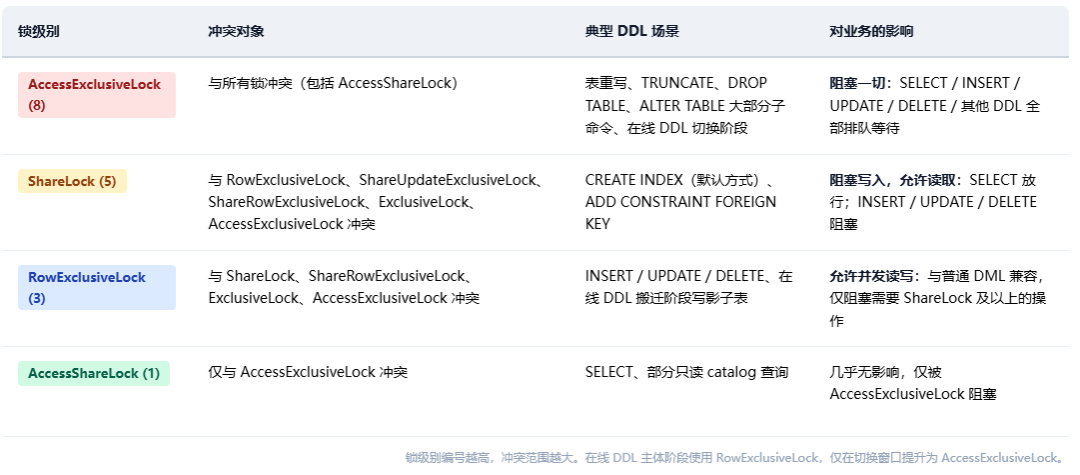
路径①和路径②虽然都持AccessExclusiveLock,但路径①锁窗口为毫秒级,生产上通常可接受;路径②锁窗口与数据量成正比,如10G表可达数十分钟至小时级。另外AccessExclusiveLock不仅阻塞后续DML,还会被已持有的低级别锁(如长事务的RowExclusiveLock)反向阻塞。一旦DDL进入等待队列,后续所有新到的AccessShareLock(普通SELECT)也会被它挡住,形成"队头阻塞"雪崩,这是生产上DDL执行失败的最常见根因。
ALTER TABLE进入ATController → ATPrepCmd → ATExecCmd后,若子命令被标记为无需重写(pass分类中不触发AT_PASS_REWRITE),则只更新系统目录。如果是带默认值加列:GaussDB 对满足条件的ADD COLUMN … DEFAULT采用类似PostgreSQL 11的"fast default / missing value"机制,把默认值记录在pg_attribute.attmissingval中,存量行读取时动态补默认值,不做全表更新。官方文档给出的不触发全表更新的条件为:
-
列类型属于BOOL、SMALLINT、INTEGER、BIGINT、NUMERIC、FLOAT、DOUBLE PRECISION、CHAR、VARCHAR、TEXT、TIMESTAMP(TZ)、DATE、TIME(TZ)、INTERVAL、BYTEA等白名单;
-
DEFAULT值序列化长度 ≤ 128字节;
-
新增列设置有DEFAULT值,且DEFAULT值不为NULL;
-
DEFAULT值不含volatile函数(如 nextval()、random(),可查 pg_proc.provolatile=‘v’)。
不满足任一条件(典型如ADD COLUMN c serial、DEFAULT nextval(…)),将退化为路径②全表重写。
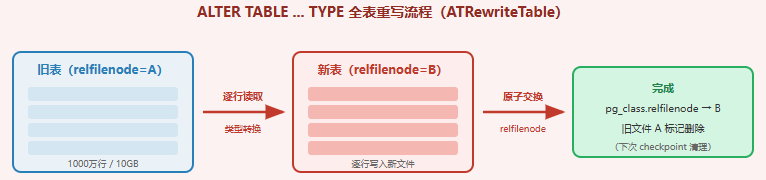
由ATRewriteTables → ExecRewriteRowTable / ExecRewriteCStoreTable(行存/列存分别实现)驱动。行存重写流程:新建物理文件 → 顺序扫描旧表逐行做表达式求值与类型转换 → 批量写入 → 重建全部索引与约束 → 事务提交时原子替换文件指针。整个过程在单一大事务内完成,持ACCESS EXCLUSIVE锁;期间所有DML排队等待,若业务侧存在未提交的长事务,DDL还会先被长事务阻塞,进而造成后续会话雪崩式堆积。
-
全程持有AccessExclusiveLock,所有SELECT / INSERT / UPDATE / DELETE均被阻塞
-
需要约额外磁盘空间存放新表文件(峰值 ≈ 原表大小 × 2)
-
WAL日志增量 ≈ 新表数据量,主备同步延迟在此期间显著增大
-
索引需在新表上重建,增加额外I/O;若表有多个索引,耗时进一步增加
1.3.3 路径③:在线 DDL
GaussDB 自V500R002C00起提供在线DDL能力,覆盖在线ALTER TABLE(列类型修改等原本需要全量重写的操作)、在线VACUUM FULL、在线移动表空间、在线建/重建索引。其原理与第三方gh-ost 类似,但做在内核里,分为四个阶段:
-
阶段1准备阶段:获取AccessExclusiveLock并创建影子新表,启动逻辑解码捕获增量, 释放锁,业务恢复读写。该阶段获取AccessExclusiveLock级别锁,耗时秒级,业务影响为毫秒~秒级全阻塞。
-
阶段2基线数据拷贝(不锁原表):后台任务分批扫描旧表,并进行类型转换,然后写入影子表;业务DML继续写旧表,变更被解码为增量日志暂存。该阶段原表无排他锁(仅读取),影子表锁为RowExclusiveLock(与普通DML兼容),耗时与数据量成正比(10G约20~30 min),业务影响仅资源占用无锁阻塞。
-
阶段3增加数据追平(不锁):循环回放增量日志到影子表,每轮回放后剩余增量递减;当增量水位低于阈值时进入切换准备。该阶段锁级别同阶段2,耗时,取决于业务写入速率,无业务影响。
-
阶段4 DDL提交原子切换(短锁):等待存量DML结束后获取AccessExclusiveLock,回放最后一批增量,并交换新旧表文件指针,提交DDL,然后释放锁。该阶段持有AccessExclusiveLock锁,耗时秒级完成,切换窗口内DML短暂等待。
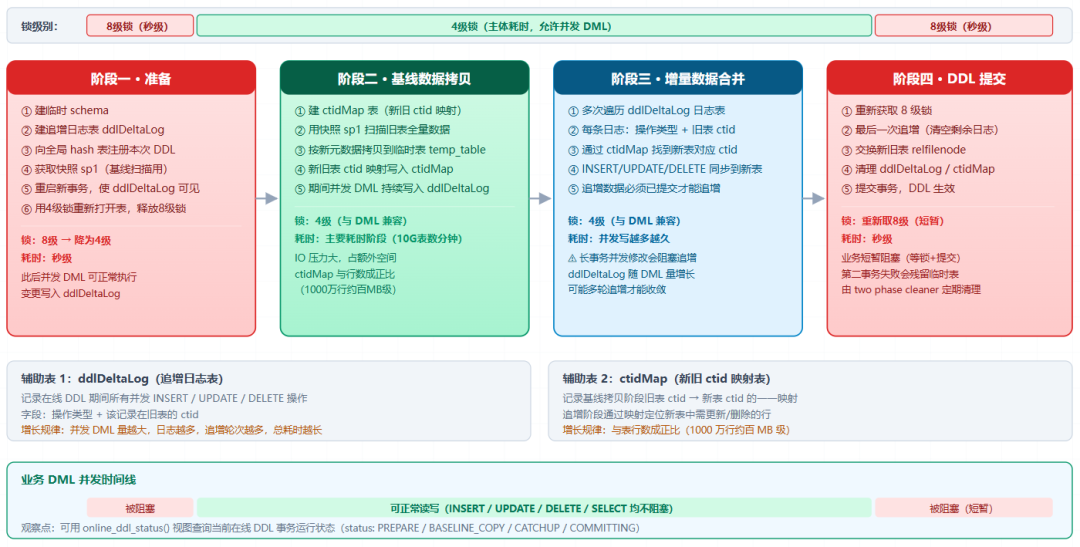
在线DDL阶段会有两个辅助表:ddlDeltaLog(追增日志表)和ctidMap(新旧ctid映射表)。ddlDeltaLog记录在线DDL期间所有并发INSERT/UPDATE/DELETE操作,ctidMap记录基线拷贝阶段旧表ctid → 新表ctid的一一映射。
普通CREATE INDEX 持ShareLock阻塞写入、允许读,而ALTER TABLE … ADD CONSTRAINT PRIMARY KEY 底层等价于"建唯一索引 + 全表扫描验证NOT NULL",默认按阻塞方式执行。CREATE INDEX CONCURRENTLY 则执行两次全表扫描:第一次建索引不阻塞读写,第二次合并期间产生的增量变更;代价是总耗时更长、消耗额外CPU/IO,且失败时会残留INVALID索引(需DROP INDEX后重建)。注意CONCURRENTLY不能在事务块中执行,分布式形态下分区表对其支持存在版本差异,执行前应核对对应版本文档。
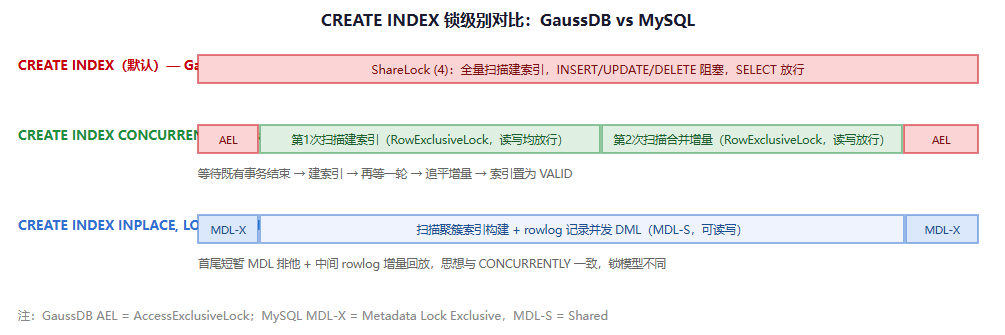
对比非CONCURRENTLY模式:
-
普通CREATE INDEX:一次扫描,持ShareLock(5),阻塞写但不阻塞读,耗时较短
-
CONCURRENTLY:两次扫描,持SUELock(4),读写均不阻塞,耗时约为普通模式的1.5~2 倍
GaussDB(继承 PostgreSQL)的DROP COLUMN并不会立即从数据页中物理移除该列的数据。实际执行过程:
-
在 pg_attribute 中将该列的attisdropped标记为true,attname置空;
-
更新pg_class.relnatts的有效列计数;
-
后续INSERT/UPDATE写入新行时不再包含该列数据;
-
旧行中该列的物理空间依然存在,直到该行被UPDATE或VACUUM FULL重写。
因此DROP COLUMN本身是瞬时的元数据操作,但表中仍保留着"空洞"。若需回收空间,需后续执行VACUUM FULL(即全表重写,此时才产生重操作开销)
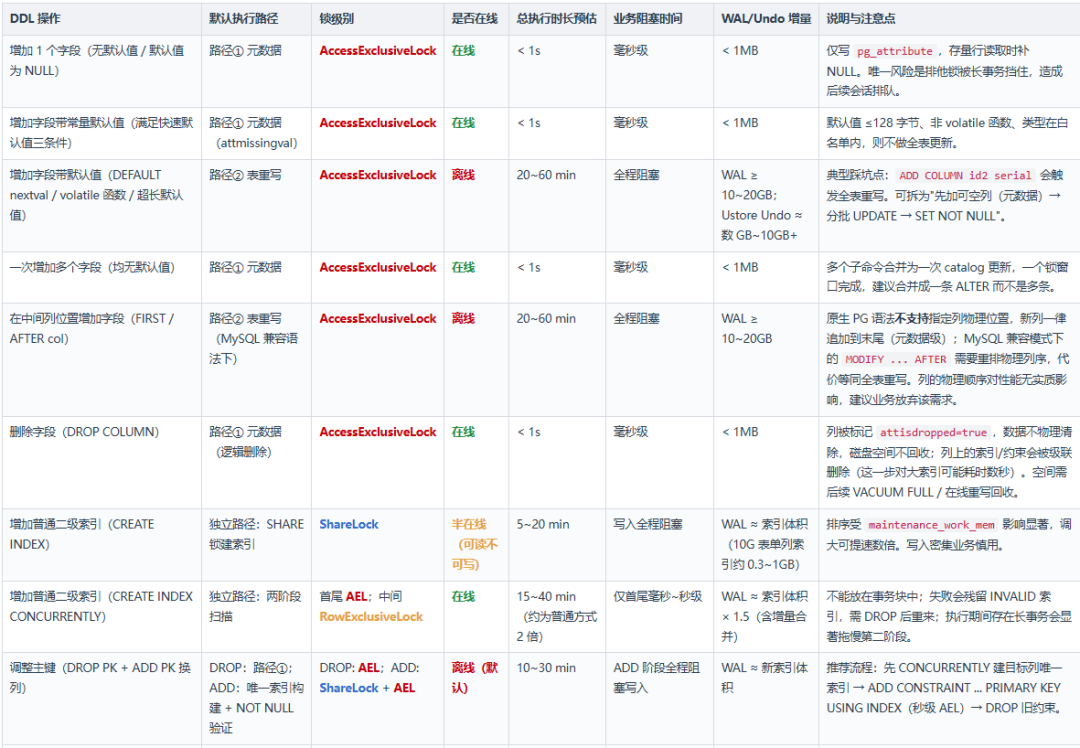
以1000万行/10GB行存表为例,下表中的时长与日志量为工程经验参考值,前提假设:
NVMe SSD、常规IO能力(顺序写200~400MB/s)、业务低峰期执行、无长事务干扰、单DN/集中式部署。实际结果受压缩率、索引数量、并发写入速率、资源管控配置影响很大,生产变更前务必在同规格预发环境实测。分布式形态下多DN并行执行,墙钟时间通常低于单节点,但需叠加GTM/两阶段提交开销与节点间不均衡因素。
-
增加1个字段(无默认值/默认值为NULL):仅修改元数据,在线完成,业务影响毫秒级;
-
增加字段带常量默认值(满足快速默认值条件):仅修改元数据,在线完成,业务影响毫秒级;
-
增加字段带默认值(DEFAULT nextval / volatile函数/超长默认值):表重写,离线操作,全程阻塞业务,影响20~60分钟;
-
一次增加多个字段(均无默认值):仅修改元数据,在线完成,业务影响毫秒级;
-
在中间列位置增加字段(FIRST / AFTER col):表重写,离线操作,全程阻塞业务,影响20~60分钟;
-
删除字段(DROP COLUMN):仅修改元数据,在线完成,业务影响毫秒级。逻辑删除。
-
增加普通二级索引(CREATE INDEX):半在线,阻塞写入,影响5~20min;
-
增加普通二级索引(CREATE INDEX CONCURRENTLY):在线完成,仅首尾阶段秒级影响业务;
-
调整主键(DROP PK + ADD PK 换列):默认是离线,ADD阶段全程会阻塞业务,业务影响10~30min;
-
增加分区(ADD PARTITION):仅修改元数据,在线完成,业务影响毫秒级;
-
删除分区(DROP PARTITION):文件级删除,瞬时排他锁,秒级业务影响;
-
TRUNCATE TABLE:文件级重建,瞬时排他锁,秒级业务影响;
-
VARCHAR长度扩大(varchar(64)→varchar(255)):仅修改元数据,在线完成,业务影响毫秒级;
-
VARCHAR长度缩小(varchar(255)→varchar(64)):表重写,离线操作,全程阻塞业务,影响20~60分钟;
-
修改字段类型 char(n) → varchar(n):部分版本不一致。表重写,离线操作,全程阻塞业务,影响20~60分钟;
-
修改数值精度——扩大(numeric(10,2)→numeric(14,2)):表重写,离线操作,全程阻塞业务,影响20~60分钟;
-
修改数值精度——缩小或改 scale(numeric(10,2)→numeric(10,4)):表重写,离线操作,全程阻塞业务,影响20~60分钟;
-
修改表注释(COMMENT ON TABLE):仅修改元数据,在线完成,业务影响毫秒级
-
修改字段注释(COMMENT ON COLUMN):仅修改元数据,在线完成,业务影响毫秒级
-
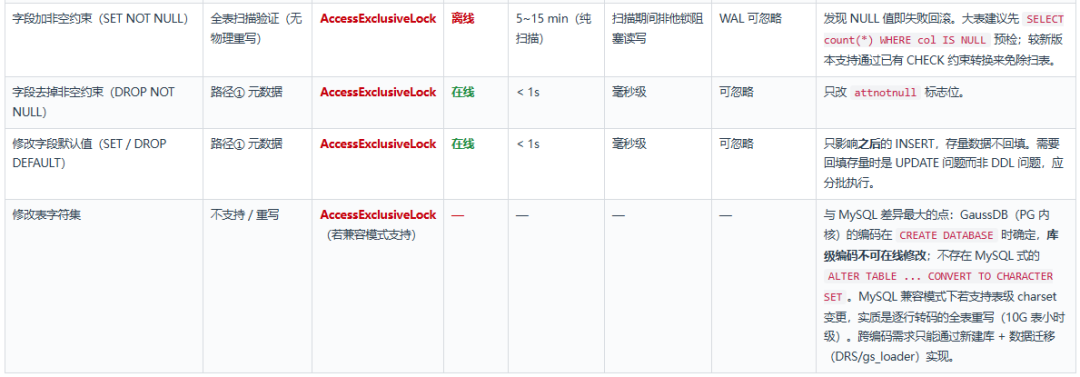
字段加非空约束(SET NOT NULL):全表扫描验证(无物理重写),离线操作,扫描期间排他锁阻塞读写,影响5~15分钟;
-
字段去掉非空约束(DROP NOT NULL):仅修改元数据,在线完成,业务影响毫秒级;
-
修改字段默认值(SET / DROP DEFAULT):仅修改元数据,在线完成,业务影响毫秒级;只影响之后的 INSERT,存量数据不回填;
-
修改表字符集:与 MySQL 差异最大的点:GaussDB(PG 内核)的编码在 CREATE DATABASE 时确定,库级编码不可在线修改;

GaussDB数据库在执行DDL时候WAL日志和Undo空间的占用大小评估,和不同的DDL操作类型有关。以Ustore存储引擎为例:
-
元数据DDL:WAL仅catalog页修改,在KB~MB级别;Undo几乎无占用
-
表重写类DDL:重写等价于向新文件 INSERT 全量数据,WAL 增量约 1~2 倍表体积。插入会在回滚段产生Undo,根据测试结果undo空间的大小和表数据量有关,平均每条记录占用约55字节大小。大表重写DDL期间需要监控undo空间的使用情况。
-
CREATE INDEX:WAL日志约为索引的物理体积(全页写为主),Undo为索引构建事务
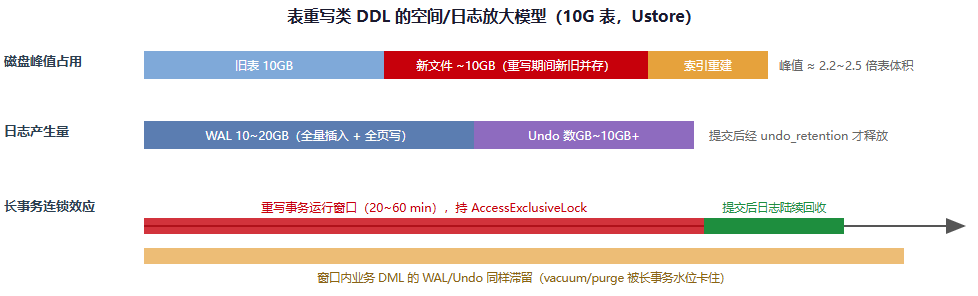
在GaussDB数据库中可能配置了undo_limit_size_per_transaction参数限制单个事务生成的undo大小。如果单表数据量非常多,在执行表重写类DDL时候有可能生成的undo日志会超过该参数配置导致DDL执行失败。因此需要在执行DDL操作前根据数据量大小评估占用的undo空间,以保证DDL能够顺利执行。
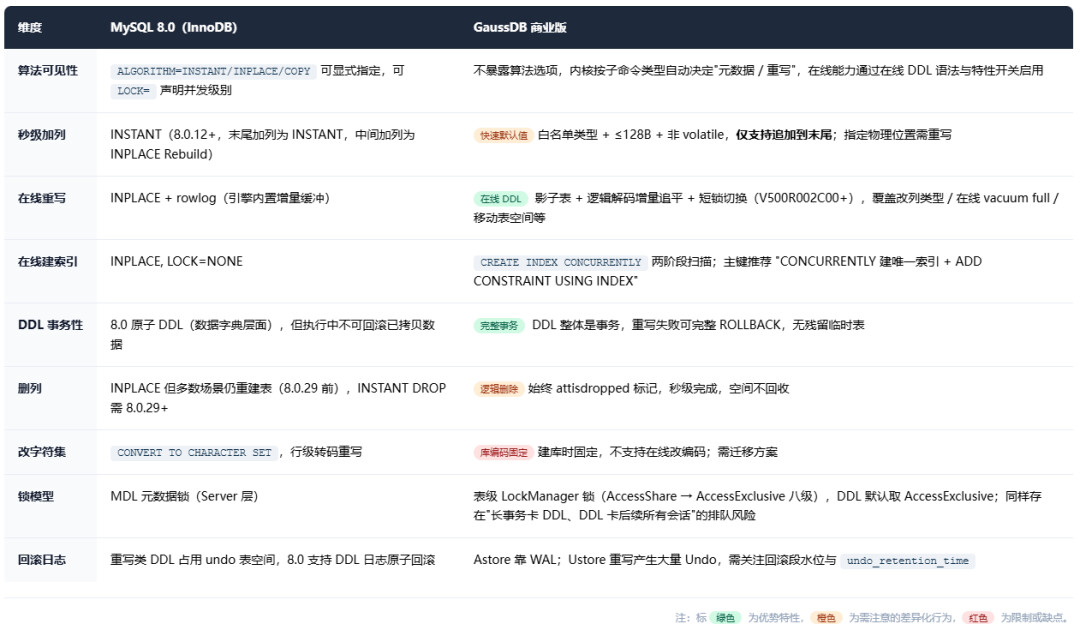
与MySQL 8对比,GaussDB数据库没有显示指定算法选项,部分版本中支持ONLINE参数指定在线DDL操作;GaussDB中DDL整体是一个事务,失败会回滚;新增字段默认值不为NULL会使用表重写;删除列是逻辑删除,秒级完成;DDL默认取AccessExclusive同样存在"长事务卡 DDL、DDL卡后续所有会话"的排队风险。
备注:本文机制描述基于GaussDB/openGauss公开文档与内核源码分析整理;时长与日志量为特定硬件假设下的经验估算,不同版本(尤其V500R002/503/505与V2.0-25.x之间在线DDL支持范围有差异)、不同部署形态(集中式/分布式/存算分离)、行存/列存/Ustore/Astore 的具体行为可能不同。执行生产变更前请以所用版本的官方《SQL参考》与《特性描述·高可用·在线DDL》章节为准,并在预发环境实测验证。
参考资料:
-
openGauss在线DDL特性简介
-
华为云GaussDB集中式开发指南:Online DDL and Related Operations
-
华为云GaussDB ALTER TABLE 语法
-
数据库系列之数据库中大表DDL变更问题
-
数据库系列之InnoDB中在线DDL实现机制
-
数据库DDL操作算法及影响分析