腾讯混元推出新语音识别模型,强化方言、语境理解和复杂环境转写。
冷月清谈:
怜星夜思:
2、语音模型开始根据上下文主动纠正同音词,会不会出现“听错了但改得很合理”的情况?该怎么防?
3、企业接入语音识别时,应该直接用云端 API,还是选择开源模型自己部署?
4、方言识别该怎么评测才算公平?只看平均错误率,会不会掩盖小众口音的真实表现?
原文标题:腾讯混元Hy ASR 3.0 preview发布:通用识别、方言覆盖、场景鲁棒性全面提升
原文作者:机器之心
原文内容

8 月 4 日,腾讯混元正式发布新一代语音识别模型 Hy ASR 3.0 preview。基于最新一代大语言模型 Hy3 的语言理解能力,Hy ASR 3.0 preview 融合高精度语音识别与深度语义理解能力,在通用识别、上下文感知、多场景鲁棒性以及方言覆盖等核心维度实现全面提升,能够在更复杂的真实输入中给出准确、连贯且更接近用户意图的转写结果,从 “逐字转写、单点优化” 演进为 “理解语境、兼容场景、一键直出”。
Hy ASR 3.0 preview 在多个开源评测集和自建评测集上整体表现领先。在开源评测集中,Hy ASR 3.0 preview 在多语种的 WER(Word Error Rate, 词错误率)上都控制在 3% 左右,其中中文普通话 WER 3.34%、英语 WER 2.62%、粤语 WER 3.12%,整体领先竞品。
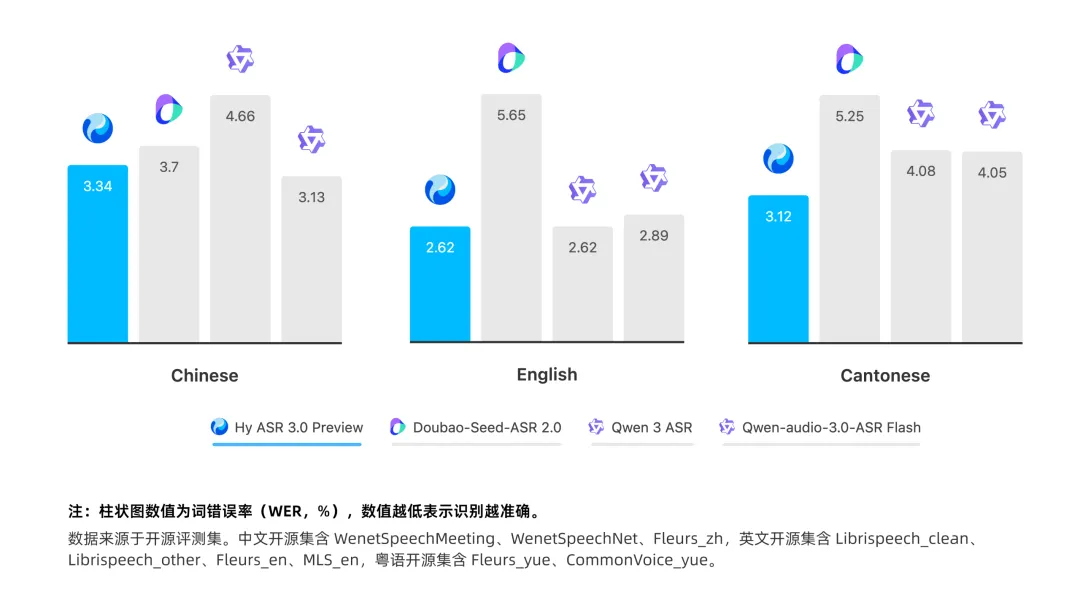
开源评测集表现:Hy ASR 3.0 preview 在语种及方言上均取得最低 WER,整体表现领先
在自建评测集上,Hy ASR 3.0 preview 在通用识别、方言识别、上下文 Context 理解、专词理解、复杂声学场景(高噪、耳语)等场景化评测中,WER 也保持较低水平,整体领先竞品。
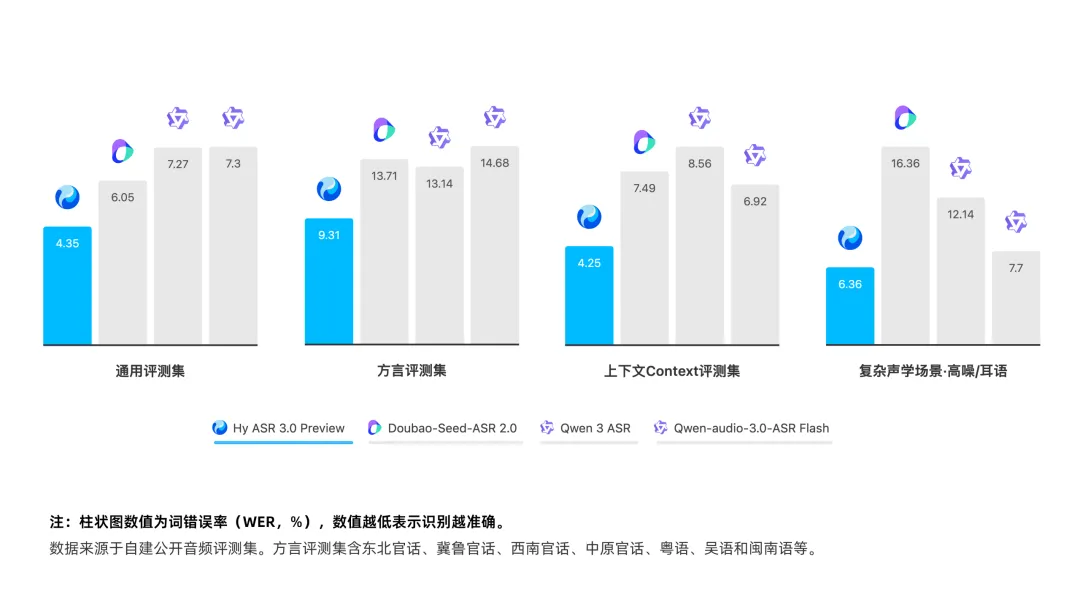
自建评测集表现:在综合评测集上取得最低 WER,整体表现领先
从用户使用的角度,Hy ASR 3.0 preview 重点提升了四类能力,包括:
-
通用识别更准确:提升通用语音、方言、中英混说等场景下的识别准确性,进一步减少错字、漏字及长音频中的错误累积。
-
更能理解用户意图:结合 Context 上下文精准捕捉用户语境,智能纠错同音词,消除语义歧义。
-
更容易适配专业场景:支持热词注入增强,帮助模型快速识别品牌产品名称、人名及行业术语,降低业务接入和持续维护成本。
-
复杂环境下更稳定:面向高噪、耳语、悄悄话等多种声学场景下进行专项优化,复杂条件下依然保持稳定表现。
架构、数据、后训练持续增强,提升语音识别能力上限
Hy ASR 3.0 preview 的能力提升并非来自单一模块,而是模型架构、数据 Scaling 与后训练优化共同作用的结果。
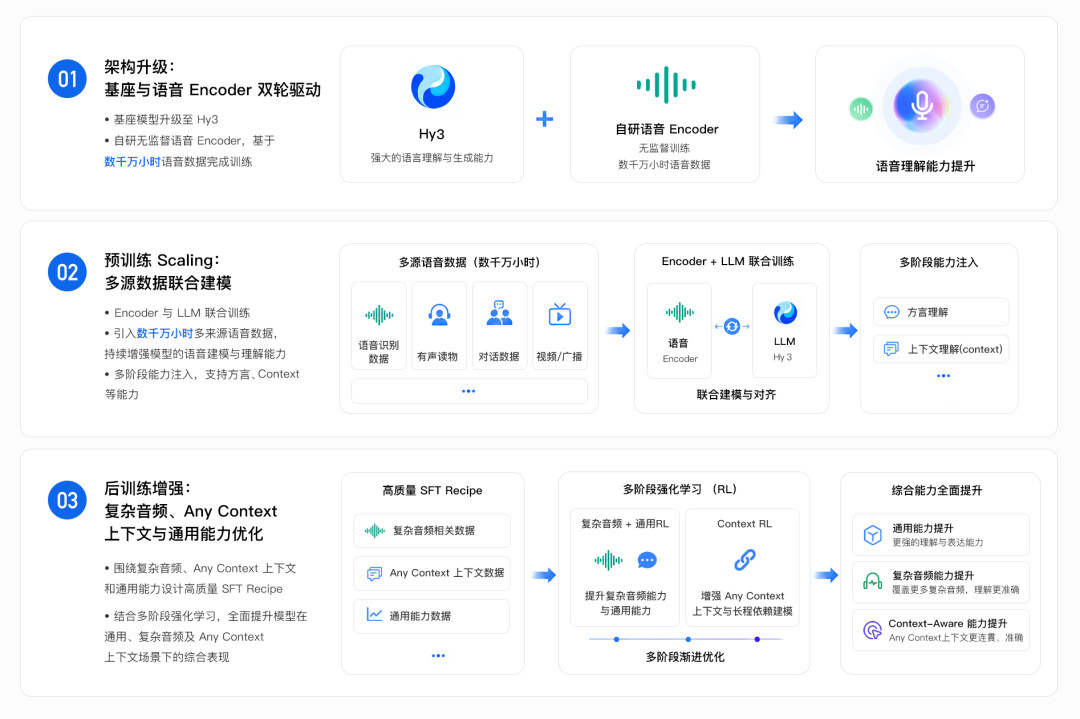
在架构层面,Hy ASR 3.0 preview 采用兼顾效率与性能的 MoE 架构,并将基座模型升级至 Hy3,进一步增强语言理解、上下文建模和语义推理能力。在语音侧,团队自研无监督语音 Encoder,通过数千万小时级无监督语音数据训练,使其能够从复杂音频中提取高质量的声学表征。
为了持续提升模型的语音建模与理解能力,混元团队对语音 Encoder 和大语言模型进行联合训练,引入数千万小时级、多来源的语音数据,覆盖多种方言、口音和声学环境,并通过高质量数据管线进行精细化标注。在大规模联合预训练的基础上,Hy ASR 3.0 preview 通过多阶段能力注入,逐步获得上下文感知、复杂场景适应和方言识别等能力。
围绕通用识别、上下文理解和复杂场景鲁棒性,团队构建了高质量的 SFT recipe,覆盖上下文 context、专业名词、不同声学环境以及多样人群语音。针对方言识别能力,SFT 数据体系进一步覆盖 10 大方言片区和 20 余个二级小片区。
在此基础上,团队进一步引入多阶段强化学习,分别针对通用转写准确性、Any-context 上下文能力和复杂长尾场景进行优化,降低模型在复杂声学环境中的误识别和漏识别问题。
目前 Hy ASR 3.0 preview 已上线腾讯云官网对外提供 API 服务,可广泛应用于智能客服、内容理解、语音搜索等场景。元宝深度参与共研并已完成首发上线,用户打开元宝按住说话即可体验方言识别、上下文智能纠错与复杂环境稳定转写等能力提升,语音输入更准、更稳,且免费开放;WorkBuddy 等产品也在陆续接入中。
腾讯云 API 地址:https://cloud.tencent.com/document/product/1093/135476
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com