TSC异常降级为HPET会放大数据库取时开销,文章给出定位与修复路径。
冷月清谈:
怜星夜思:
2、怎样证明数据库变慢真是时钟源导致的,而不是SQL、锁竞争或磁盘IO的问题?
3、如果问题出现在虚拟机、云服务器或容器里,排查思路和物理机有什么不同?
4、时钟源状态值得加入数据库服务器的常规监控吗,应该监控哪些指标?
原文标题:因CPU时钟源降级引发的数据库性能问题
原文作者:牧羊人的方向
原文内容
Linux服务器通常默认采用CPU内置的时间戳计数器(TSC)作为系统时钟源,以实现最低的时间读取延迟。当内核通过时钟源看门狗(watchdog)机制检测到TSC出现计数漂移、不同步或停止等异常时,会自动将时钟源降级切换至主板集成的高精度事件计时器(HPET)。该切换会显著增加时间获取的系统开销,进而对高频调用时间戳的数据库系统造成明显的性能劣化。本文简要阐述TSC与HPET的技术差异、TSC到HPET自动切换的触发条件、切换对数据库性能的影响机理,并提供故障排查及优化建议。
1、CPU内核时钟源
系统时钟源是操作系统时序调度、应用时间戳获取的底层基准,其性能与稳定性直接决定上层业务的运行表现。在x86 Linux系统中,内核提供了TSC、HPET、ACPI PM Timer、PIT等多种时钟源,并按照性能优先级进行排序,默认优先选择TSC以保障极致的时间读取性能。
TSC依托CPU原生寄存器实现,具备纳秒级访问延迟,但受硬件架构、电源管理与固件实现的影响,在多路服务器、深度休眠、虚拟化等场景下易出现稳定性问题。为避免时钟异常引发系统故障,Linux内核实现了TSC看门狗校验机制,当检测到TSC偏差超出阈值时,自动切换至稳定性更高的HPET时钟源。
数据库系统作为典型的时间敏感型负载,在事务生命周期管理、预写日志(WAL)、并发控制、主从复制等核心链路中高频调用系统时间。时钟源从TSC切换至HPET带来的开销放大效应,会在高并发OLTP场景下被显著放大,表现为吞吐量下降、系统CPU使用率上升、响应时延增加。因此,理解时钟源切换的底层逻辑与性能影响,对数据库性能优化与故障排查具有一定的参考价值。
2、TSC与HPET的底层技术差异
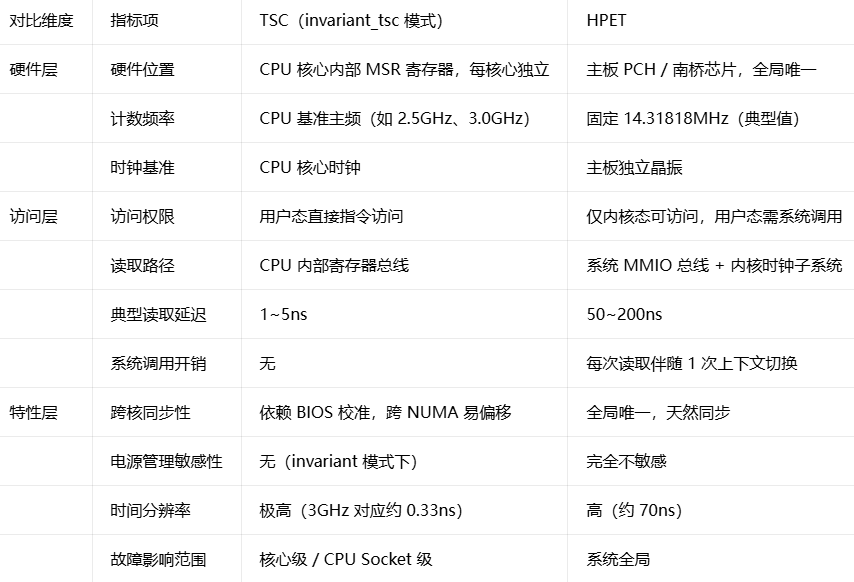
TSC与HPET分属CPU核级与主板芯片级两类不同的硬件时钟,在硬件实现、访问路径、同步特性与可靠性上存在本质差异,是导致二者性能与适用场景分化的根本原因。
TSC是x86 CPU内置的64位模型专用寄存器(MSR),每个物理核独立维护一个计数器,硬件层面随 CPU 时钟周期自增。TSC的技术特性如下:
-
访问模式:支持用户态通过RDTSC/RDTSCP指令直接读取,无需陷入内核,无系统调用与上下文切换开销,典型读取延迟为1~5ns,是当前延迟最低的时钟源。
-
频率特性:随CPU架构演进,TSC的稳定性经历了三代能力升级。早期TSC计数频率与CPU运行主频绑定,随睿频(Turbo Boost)、节能降频(SpeedStep)动态变化,时间基准不稳定;constant_tsc的TSC计数频率固定为CPU基准主频,不受P-state(性能状态)变频影响;nonstop_tsc/invariant_tsc的TSC在深度C-state(休眠状态)下仍保持计数,不受CPU休眠影响,是当前最稳定的TSC形态。
-
同步特性:每个CPU核独立维护TSC寄存器,跨CPU核、跨NUMA节点的初始值与计数速率依赖BIOS固件校准,天然存在偏移风险。
HPET是由Intel与微软联合制定、ACPI规范定义的新一代高精度定时器标准,硬件实体集成于主板 PCH(平台控制器中枢)或南桥芯片中,是系统全局唯一的独立时钟硬件。HPET的技术特性如下:
-
访问模式:用户态无法直接访问,必须通过clock_gettime/gettimeofday等系统调用陷入内核,由内核通过内存映射IO(MMIO)方式读取硬件计数器,再转换为系统时间返回。典型读取延迟为50~200ns,伴随用户态-内核态上下文切换开销。
-
频率特性:采用独立晶振提供固定计数频率,标准值为14.31818MHz,部分高端平台为100MHz,完全不受CPU电源管理、频率调整的影响,计数速率恒定。
-
同步特性:全局唯一硬件计数器,所有CPU核共享同一时间基准,天然具备跨核、跨 NUMA节点的时间一致性,不存在计数偏移问题。
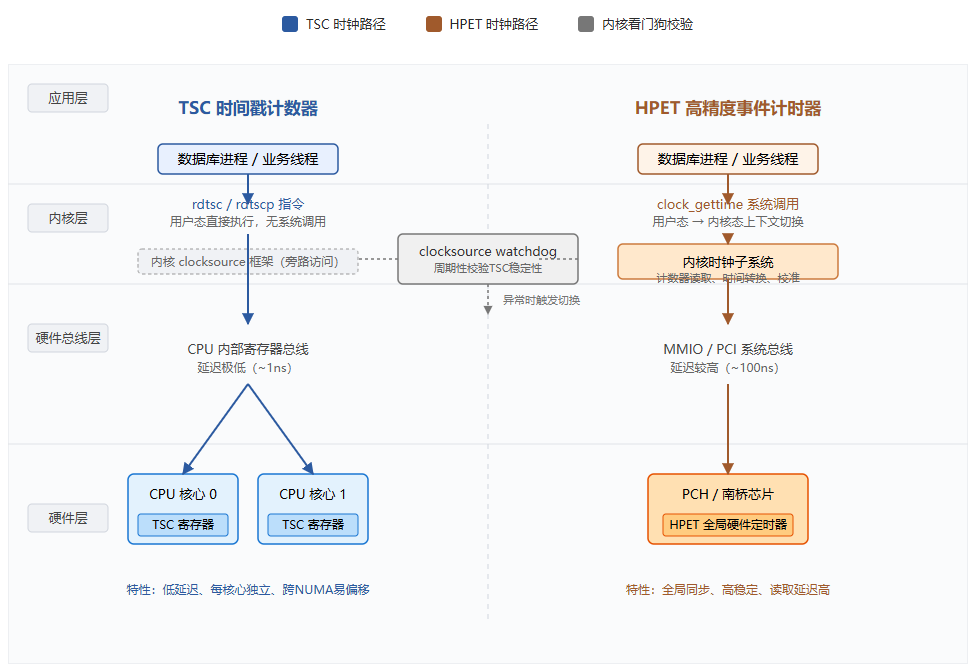
TSC和HPET时钟源在硬件层、访问层和特性层对比如下:
-
TSC访问路径:应用线程在用户态直接执行rdtsc指令读取CPU核内部的TSC寄存器,全程不经过内核系统调用,路径极短、延迟极低,但每个CPU核独立维护计数器,跨NUMA节点天然存在不同步风险。
-
HPET访问路径:应用线程必须通过clock_gettime系统调用陷入内核,由内核时钟子系统通过MMIO总线访问主板上的全局HPET硬件,完成时间转换后返回用户态。路径更长、延迟更高,但全局唯一硬件基准,天然保证跨所有CPU核的时间一致性。
-
看门狗机制:内核clocksource watchdog模块以HPET为参考基准,周期性校验TSC计数准确性;当检测到TSC漂移超出阈值时,自动触发时钟源降级切换,保障系统时间基准可靠。
3、TSC到HPET自动切换的触发机制
Linux内核通过时钟源看门狗(clocksource watchdog)机制实现TSC的稳定性校验与自动降级切换。该机制以HPET或PIT等稳定时钟为参考基准,周期性比对TSC的计数值,当偏差超过预设阈值时,判定TSC不稳定,自动将系统时钟源切换至下一个优先级的可靠时钟源(通常为HPET)。
Linux内核中,TSC作为优先级最高的时钟源,默认注册看门狗校验:
-
内核启动时,初始化TSC时钟源并启动watchdog线程,以HPET(或PIT)为参考时钟;
-
watchdog周期性(通常为0.5秒)采样TSC与参考时钟的计数值,计算两者的偏差率;
-
若连续多次检测到偏差超过500ppm(百万分之五百),则标记TSC为unstable,触发时钟源切换;
-
切换完成后,内核在dmesg 中输出日志:clocksource: timekeeping watchdog: Marking clocksource tsc as unstable; switching to clocksource hpet。
TSC计数异常并触发切换,本质上TSC计数偏离真实时间,典型场景包括以下六类:
1)CPU深度休眠状态(C-state)导致TSC暂停
对于不支持nonstop_tsc的老旧CPU,当系统进入深度C-state(如C6、C7)时,CPU核停止时钟,TSC计数器同步暂停计数;CPU核唤醒后,TSC计数未补偿暂停时长,导致时间滞后,与参考时钟偏差超过阈值,触发切换。常见于开启了CPU节能模式的服务器,低负载时核心频繁进入深度休眠。
2)多路NUMA服务器跨Socket TSC不同步
双路及以上多路服务器中,每个CPU Socket拥有独立的TSC时钟域,BIOS启动阶段的初始校准存在微秒级固有偏差。长期高负载运行后,受硬件温度漂移、晶振差异影响,跨Socket的TSC偏移量会逐渐扩大。当跨节点TSC偏差超过内核watchdog阈值时,会被判定为TSC不稳定,触发切换。该场景是生产环境中数据库服务器时钟源切换的最常见诱因。
3)CPU变频(P-state)导致TSC频率波动
对于不支持constant_tsc的早期CPU,TSC计数频率与CPU运行主频绑定。当CPU在睿频、节能降频之间动态切换时,TSC计数速率随之变化,导致时间计算出现偏差,累计偏差超过阈值后触发切换。
4)BIOS/固件缺陷与配置错误
服务器BIOS固件的TSC校准逻辑存在bug,或电源管理配置不合理,会导致TSC计数异常:部分厂商BIOS版本存在TSC同步校准错误,启动阶段未对多路CPU的TSC进行精准对齐;BIOS 中开启了“CPU C6 report”等深度休眠选项,触发TSC暂停;虚拟化环境下BIOS未开启TSC透传相关选项,导致客户机TSC模拟异常。
5)虚拟化场景下的TSC不兼容
在VMware等虚拟化环境中,TSC的透传与模拟存在较多兼容性问题。虚拟机热迁移至不同CPU型号的宿主机后,TSC特性不一致,导致计数异常;宿主机TSC本身不稳定,透传至客户机后放大偏差;未启用硬件辅助TSC虚拟化,软件模拟的TSC精度不足。
6)硬件层面故障
CPU核时钟电路故障、主板晶振漂移等硬件问题,会导致TSC计数出现持续性偏差或跳变,触发看门狗切换。此类场景相对少见,但属于硬件故障的重要表征。
4、时钟源切换对数据库系统的性能影响
从TSC切换至HPET,本质是以牺牲时间读取性能为代价,换取全局时间基准的稳定性。对于高频调用时间戳的数据库系统,该切换会从底层开销、并发调度、业务逻辑三个层面产生影响。
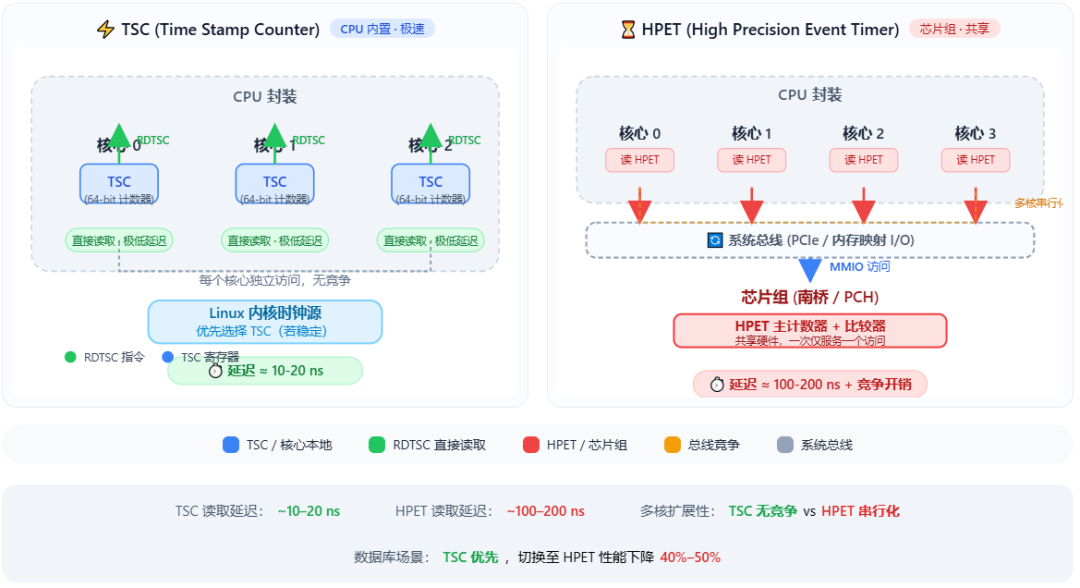
数据库系统在事务处理全链路中高频获取系统时间,时钟读取开销的放大会直接转化为业务性能损失:
1)时间获取开销数十倍增加
数据库核心链路中,几乎所有关键操作都依赖时间戳:
-
事务管理:事务开始时间、提交时间、快照时间(MVCC);
-
日志系统:WAL/Redo日志的时间戳标记;
-
并发控制:行锁、表锁的超时检测,死锁检测计时;
-
连接管理:会话超时、空闲连接回收;
-
监控统计:性能指标采样、慢查询计时。
TSC模式下,用户态可直接读取时间,开销仅几纳秒;切换到HPET后,每次时间获取都需要陷入内核、执行MMIO总线访问、再返回用户态,开销增加10~100 倍。高并发OLTP场景下,每秒数万次的时间调用会累计产生显著的CPU开销。
2)系统调用与上下文切换开销剧增
HPET模式下,每次时间获取对应一次系统调用,伴随用户态与内核态的上下文切换。上下文切换会导致CPU缓存失效、调度开销增加,进一步放大性能损耗。可通过perf stat观测到clock_gettime系统调用次数显著增加,cs(上下文切换)指标上升。
3)定时调度抖动增加
数据库的后台定时任务(如检查点、脏页刷盘、日志归档)依赖高精度定时。HPET的定时中断响应延迟高于TSC,会导致定时任务的触发时机出现抖动,极端情况下可能引发IO峰值,影响业务平稳性。
根据业务模型与并发度的差异,切换后的性能影响存在差异:
-
常规OLTP场景:数据库TPS下降 10%20%,CPU使用率上升10%20%,平均响应时延增加20%~30%;
-
高频小事务场景:单事务时间戳调用次数多,性能下降幅度可达 30%~50%;
-
分析型场景(OLAP):时间调用频率低,性能影响通常小于5%,基本可忽略。
尽管会带来性能损耗,但TSC到HPET的切换是内核的故障保护机制,其正向价值在于避免更严重的业务故障:
-
消除时间戳乱序、时间回退等问题,保障事务日志的正确性与数据一致性;
-
避免跨NUMA节点的时间偏差导致的锁超时误触发、主从复制延迟计算错误;
-
提升系统长期运行的时间稳定性,降低时钟异常导致的业务中断风险。
5、故障排查与优化建议
针对生产环境中TSC自动切换至HPET导致数据库性能下降的问题,按照 “先确认、再排查、后优化” 的思路处理,优先恢复TSC的稳定性,从根源解决性能劣化问题。
1)从数据库运行情况看出现大量的慢SQL,这些SQL语句在平时几十ms完成,但是故障期间执行时间超秒级,并且慢日志耗时高在内核CPU调度。
2)数据库服务器的CPU使用率增加,增加部分表现在sys_cpu部分,这部分CPU耗时增加说明CPU在内核调度上占用了大量的时间,为不正常的现象。
3)通过perf数据解析数据库进程,发现耗时高在read_hpet阶段,占比超70%,这部分为重点的怀疑点。
4)确认当前服务器的时钟源
cat /sys/devices/system/clocksource/clocksource0/current_clocksource
输出hpet则表示已发生切换;输出tsc为正常状态。
5)查看切换日志
dmesg | grep -i "clocksource|tsc.*unstable|switching"
若存在Marking clocksource tsc as unstable; switching to clocksource hpet等关键字,可确认是内核看门狗触发的自动切换。
6)检查TSC硬件特性
grep -E "constant_tsc|nonstop_tsc|invariant_tsc" /proc/cpuinfo
缺失对应特性表示CPU不支持该模式的TSC稳定性,是切换的潜在诱因。
-
BIOS配置检查:检查是否开启了深度C-state(如C6、C7)、CPU节能模式,确认TSC同步校准选项是否开启;
-
硬件架构确认:是否为多路NUMA服务器,跨Socket的TSC偏移是否过大;
-
固件版本核查:服务器BIOS/BMC版本是否过旧,是否存在已知的TSC相关bug;
-
虚拟化场景排查:是否为虚拟机,是否发生过热迁移,宿主机TSC是否稳定。
最终怀疑是硬件层面的问题,通过更换CPU重启服务器后,恢复正常。
6、总结
TSC与HPET两类时钟源分别代表了“极致性能”与“全局稳定”两种设计取向。TSC依托CPU原生寄存器实现纳秒级访问延迟,满足高性能场景的需求;HPET通过主板独立硬件保障跨CPU核时间一致性,保证了系统的稳定性。Linux内核的TSC看门狗自动切换机制,本质是一种故障降级策略,通过牺牲部分性能换取系统时间基准的可靠。
对于数据库系统而言,该时钟源切换可能会带来的20%~30%的性能下降。在实际生产系统中,尤其是在信创服务器多NUMA节点的多路CPU架构下,优先排查TSC时钟源降级的硬件层面原因,通过更换CPU等方式恢复TSC时钟源,以确保性能恢复。