SwiftTailor 通过几何图像表示,统一缝制样板推理与网格合成,大幅提升3D服装生成效率和逼真度。
原文标题:SwiftTailor:利用几何图像表示实现高效的 3D 服装生成
原文作者:数据派THU
冷月清谈:
文章介绍了 SwiftTailor 框架,它通过几何图像表示统一了缝制样板推理和基于几何的网格合成,旨在解决现有 3D 服装生成方法推理速度慢的问题。该框架包含 PatternMaker 和 GarmentSewer 两个轻量化模块。PatternMaker 是一个高效的视觉语言模型,用于预测缝制样板。GarmentSewer 则是一个高效的密集预测 Transformer,可将这些样板转换为服装几何图像,并在 UV 空间中编码服装裁片的 3D 表面。最终的 3D 网格通过逆映射重建,结合重网格化和动态缝合算法直接组装服装,从而避免了物理仿真带来的开销。实验结果表明,SwiftTailor 在保证准确度和视觉逼真度的前提下,显著缩短了推理时间,为下一代 3D 服装生成提供了一个高性能的解决方案。
怜星夜思:
1、SwiftTailor 框架中提到的“几何图像表示”具体指的是什么?与传统的服装建模方法相比,这种表示方式有哪些优势?
2、文章提到 SwiftTailor 的 PatternMaker 模块使用了视觉语言模型。那么,这个模型具体是如何从“多种输入模态”预测缝制样板的? 这里的“多种输入模态”都可能包含哪些信息?
3、SwiftTailor 如何避免物理仿真带来的开销?它的“逆映射过程”具体是如何将几何图像转换成最终的3D网格的? 动态缝合算法在其中扮演什么角色?
2、文章提到 SwiftTailor 的 PatternMaker 模块使用了视觉语言模型。那么,这个模型具体是如何从“多种输入模态”预测缝制样板的? 这里的“多种输入模态”都可能包含哪些信息?
3、SwiftTailor 如何避免物理仿真带来的开销?它的“逆映射过程”具体是如何将几何图像转换成最终的3D网格的? 动态缝合算法在其中扮演什么角色?
原文内容
来源:专知本文约1000字,建议阅读5分钟这项工作为下一代 3D 服装生成提供了一个可扩展、可解释且高性能的解决方案。
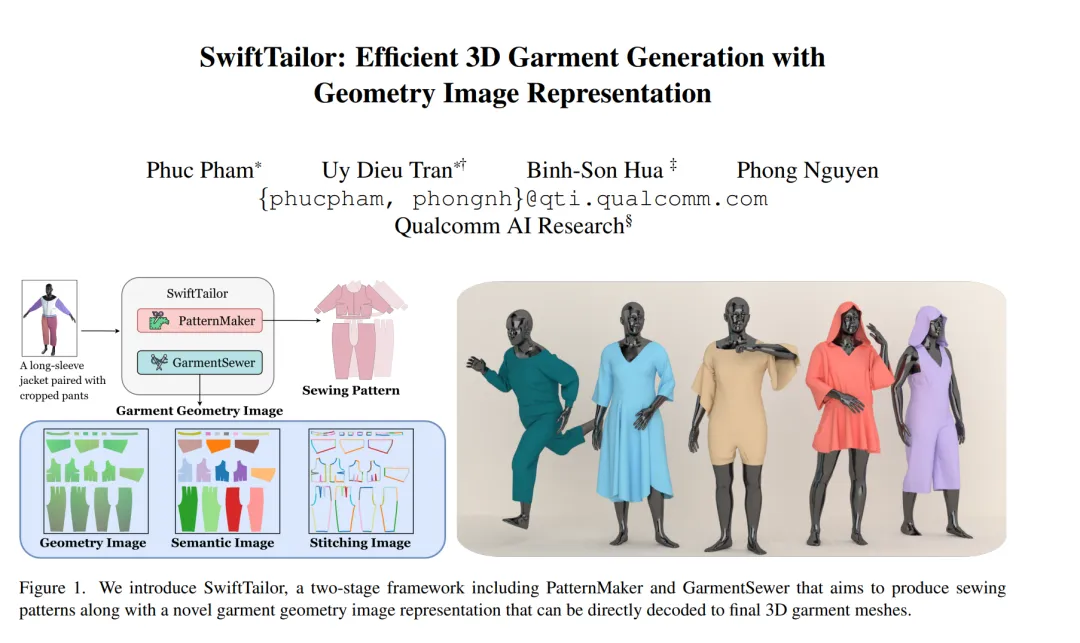
逼真且高效的 3D 服装生成一直是计算机视觉和数字时尚领域的长期挑战。现有方法通常依赖大型视觉语言模型来生成 2D 缝制样板的序列化表示,然后使用 GarmentCode 等服装建模框架将其转换为可仿真的 3D 网格。虽然这些方法产出了高质量结果,但它们往往面临推理速度慢的问题,耗时在 30 秒到 1 分钟之间。在这项工作中,我们推出了 SwiftTailor,这是一个新颖的两阶段框架,通过紧凑的几何图像表示统一了缝制样板推理和基于几何的网格合成。SwiftTailor 包含两个轻量化模块:PatternMaker(一个能从多种输入模态预测缝制样板的高效视觉语言模型)和 GarmentSewer(一个高效的密集预测 Transformer,可将这些样板转换为新颖的服装几何图像,在统一的 UV 空间中编码所有服装裁片的 3D 表面)。最终的 3D 网格通过高效的逆映射过程重建,该过程结合了重网格化和动态缝合算法来直接组装服装,从而抵消了物理仿真的开销。在 Multimodal GarmentCodeData 上的广泛实验表明,SwiftTailor 在显著缩短推理时间的同时,实现了最先进的准确度和视觉逼真度。这项工作为下一代 3D 服装生成提供了一个可扩展、可解释且高性能的解决方案。

