TrustJudge用概率分布替代粗粒度打分,降低LLM评估不一致性,并提升奖励建模效果。
原文标题:ICLR 2026 | 大模型当裁判也「翻车」?北大清华联合多校提出TrustJudge,让LLM评估更值得信赖
原文作者:数据派THU
冷月清谈:
论文将问题归因为两点:一是离散评分会压缩信息,模型内部本来更细的判断被粗暴映射成几个整数,导致打分看似相同、比较时却偏好不同;二是成对比较中的“平局”常混杂真实接近和模型拿不准两种情况,容易引发传递性矛盾。
TrustJudge 的核心做法是利用模型输出背后的概率分布,而不只看最终吐出的离散答案。在评分场景中,它把评分粒度提高到 100 分,并对候选分数做 softmax 归一化,再用加权期望得到更细致的分数;在成对比较场景中,它用困惑度或双向概率聚合来处理模糊平局,并减轻位置偏差。
实验显示,TrustJudge 在 Llama、GPT、Qwen、Gemma 等多个模型家族上都能显著降低不一致性,同时提升评估准确率;部分情况下,小模型加上该方法后的传递性表现甚至超过未使用该方法的大模型。研究还发现,推理强化过的模型在评估任务上可能更不稳定,但 TrustJudge 依然有效。除评估外,该方法还可用于强化学习奖励建模,帮助提升训练信号质量。
怜星夜思:
2、TrustJudge强调要利用完整概率分布,而不是只看最终答案。你觉得以后很多AI系统是不是都该少看“结果”,多看“置信度”和分布信息?
3、文中提到一些推理能力更强的模型,做评估反而更容易自相矛盾。你觉得这是训练目标冲突,还是推理模型更容易“想太多”?
4、如果TrustJudge这类方法真的能提升奖励信号质量,你觉得它对RLHF、GRPO这类训练流程最大的实际意义是什么?
原文内容
来源:机器之心本文约3000字,建议阅读5分钟与其让模型吐一个离散分数了事,不如把它内部的完整概率分布也用上。
让 GPT-4 给两篇文章打分,A 拿了 4 分、B 拿了 3 分。按常理 A 应该比 B 好吧?但换成成对比较,同一个模型却说「B 更好」。更离谱的情况也有——A > B > C > A 的「石头剪刀布」循环,连传递性都守不住。这事还真不少见。
北京大学、清华大学等八所高校的研究团队在 ICLR 2026 上提出了 TrustJudge,一个基于概率的评估框架。核心想法不复杂:与其让模型吐一个离散分数了事,不如把它内部的完整概率分布也用上。不用额外训练,评估不一致性就降了一大截,准确率还跟着涨了。
-
论文标题:TrustJudge: Inconsistencies of LLM-as-a-Judge and How to Alleviate Them
-
作者:Yidong Wang*, Yunze Song*, Tingyuan Zhu, Xuanwang Zhang, Zhuohao Yu, Hao Chen, Chiyu Song, Qiufeng Wang, Zhen Wu, Xinyu Dai, Yue Zhang, Cunxiang Wang†, Wei Ye†, Shikun Zhang†
-
单位:北京大学、清华大学、新加坡国立大学、南京大学、卡内基梅隆大学、西湖大学、东南大学、东京科学大学
-
论文链接:https://arxiv.org/abs/2509.21117
-
开源代码:https://github.com/TrustJudge/TrustJudge
01|问题有多严重?
用大模型给其他模型当裁判,已经是评估界的标配——MT-Bench 用单项评分,AlpacaEval 用成对比较,RLHF/GRPO 做偏好标注。但这个裁判的两种考法给出的结论,经常打架。
TrustJudge 的作者做了系统测量,把问题量化成了两类:
评分-比较不一致(Score-Comparison Inconsistency)
打分时 A 比 B 高,拉到一起比较时又说 B 好。用 Llama-3.1-70B 测试,不一致率 23.32%——差不多每四次评估就矛盾一次。
成对传递性不一致(Pairwise Transitivity Inconsistency)
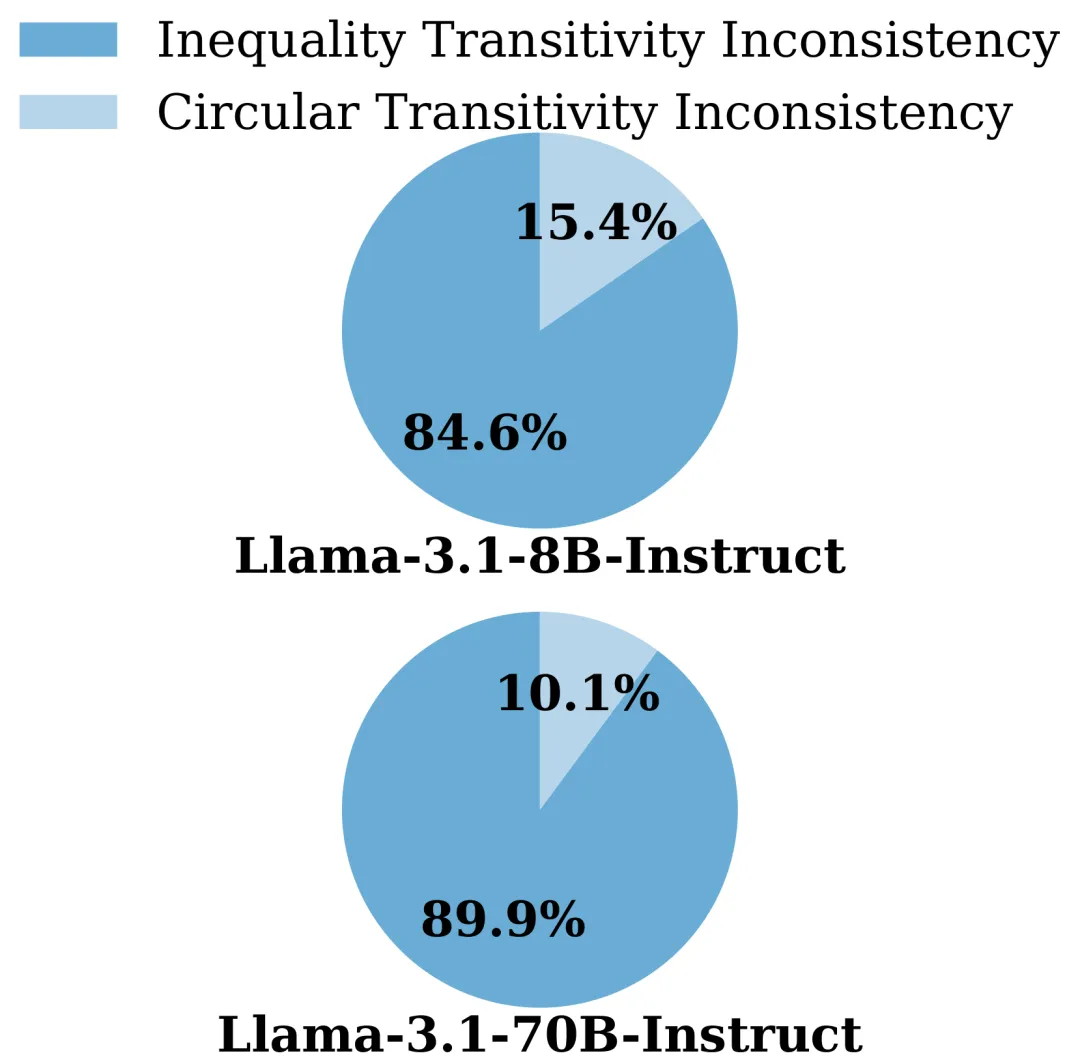
成对比较出现循环偏好(A > B > C > A)或者等价矛盾(A = B = C 但 A ≠ C)。Llama-3.1-70B 上的不一致率是 15.22%。
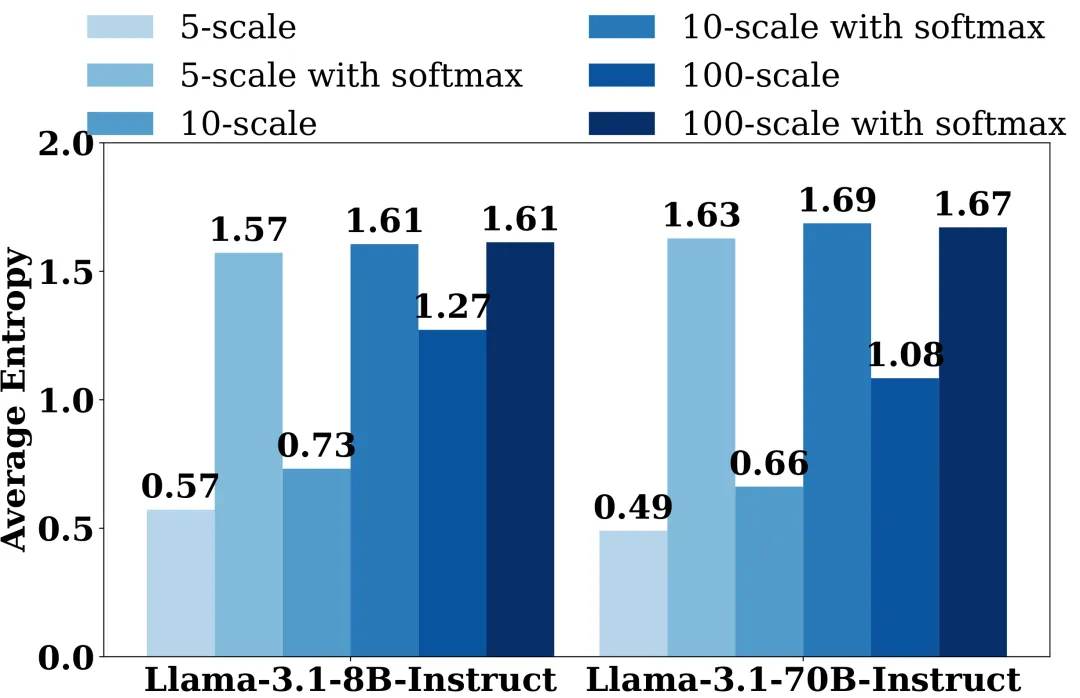
图 1:上图是 Llama-3 系列在 1,200 条指令上的评分熵分布,下图是成对比较中两种传递性错误的占比。
02|问题出在哪?
数据摆出来了,接下来的问题是:这两类不一致的根源是什么?作者从信息论的角度做了归因。
离散评分丢信息
5 分制打分,本质上是把模型心里的连续判断硬塞进几个整数格子里。比方说两条回复质量分别是 3.8 和 4.2,5 分制下都成了 4 分,打分看不出差别。但拉到一起做比较,模型是感知得到这 0.4 差距的——矛盾就这么来了。
作者还在理论上证了一条:存在两个不同的概率分布,离散评分下完全相同,但信息熵不同。换句话说,离散化在结构上就一定会丢东西。
模糊平局带来传递性问题
做成对比较时,模型对质量相近的回复经常给「平局」。但平局和平局不一样——有的是模型真觉得半斤八两,有的纯粹是拿不准。这些「含糊的平局」在不同组合里不一致地冒出来,A = B、B = C、但 A ≠ C 的情况就出现了。
03|TrustJudge 怎么做的?
思路说白了就一句话:别只取模型吐出的那个离散答案,把背后的概率分布也用起来。框架分两块:
分布敏感评分(Distribution-Sensitive Scoring)
传统做法是让模型输出一个分数然后直接采纳。TrustJudge 不这样干:
-
把评分尺度从 5 分拉到 100 分,先把粒度给够。
-
对所有候选分数的 logits 做 softmax,得到一个完整的概率分布。
-
算加权期望作为最终分数:
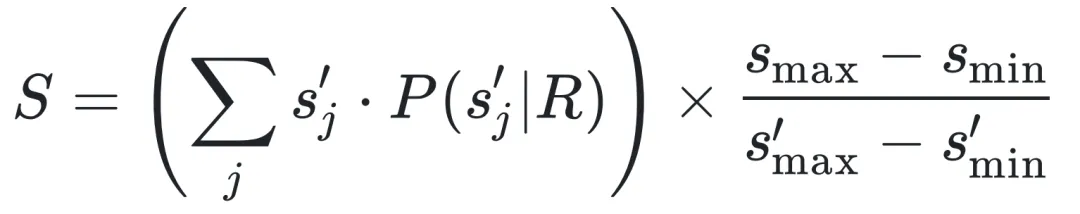
效果就是:原来 5 分制下都是 4 分的两条回复,现在一个 3.82、一个 4.17,差异保住了。
跟 G-Eval 的区别在于,TrustJudge 用 softmax 归一化确保概率和严格为 1,不会被非评分 token 干扰。
似然感知聚合(Likelihood-Aware Aggregation)
成对比较这边,TrustJudge 给了两种策略来打破平局:
策略一:基于困惑度(PPL-Based)
遇到平局时,分别算 A 在前和 B 在前两种排列的困惑度,选困惑度低的那个方向的结果——模型读起来更通顺的排列,判断往往更靠谱:
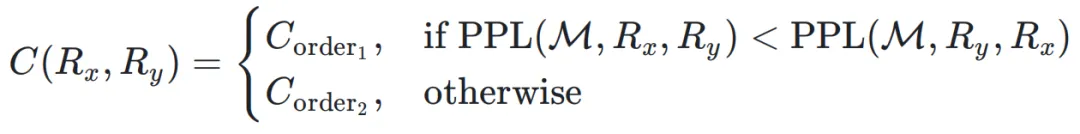
策略二:双向概率聚合
把两个方向的偏好概率加起来,取置信度最高的:
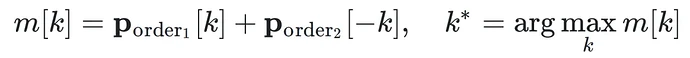
由于是两个方向聚合,位置偏差(position bias)也在这个过程中被抵消了。
04|理论上也站得住
上面的方法直觉上说得通,但有没有更严格的保证?作者给出了形式化的理论证明:
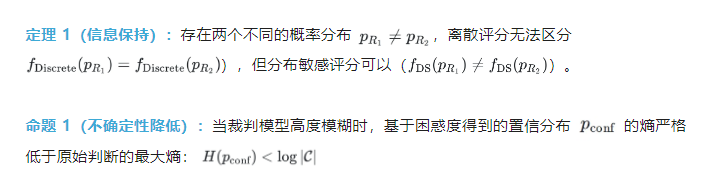
一句话概括:信息保留得更多了,判断的不确定性降下去了。
05|实验结果
实验数据来自 MT-Bench(80 题)和 ArenaHard(500 题),裁判模型覆盖 Llama-3 系列(3B / 8B / 70B)和 GPT-4o。
主实验
表 1:所有模型上两类不一致性都明显下降,精确匹配率同步上升。其中 Llama-3.2-3B 的传递性不一致从 54.69% 直接降到 17.76%,落差接近 37 个点。
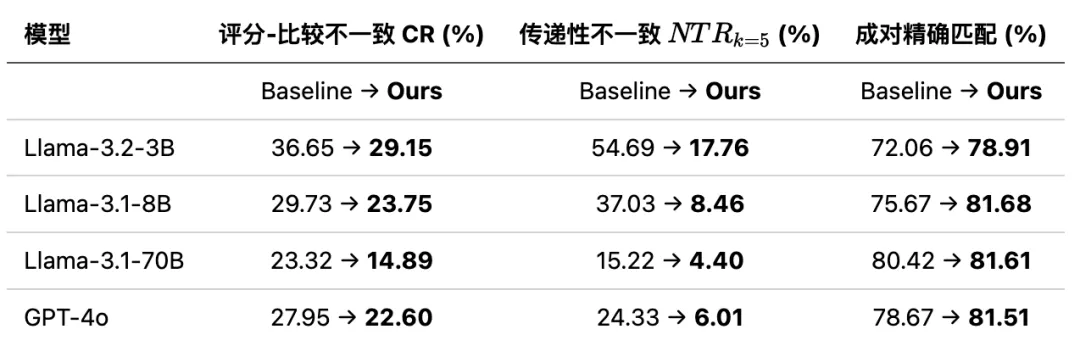
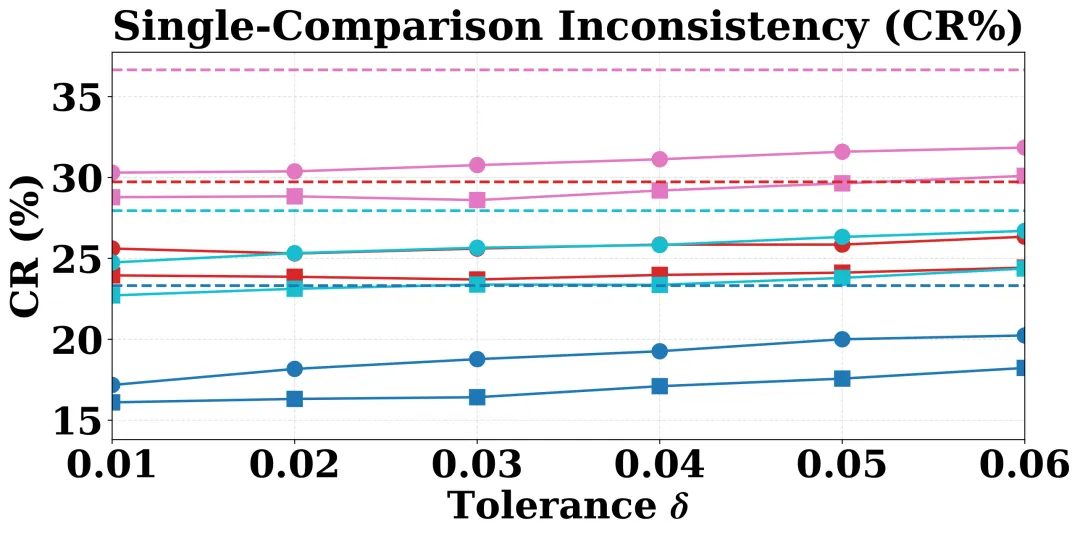
图 2:不同容忍度 δ 下的不一致性对比。TrustJudge(方块 / 三角)在各个设置下都低于 Baseline(虚线)。
消融实验
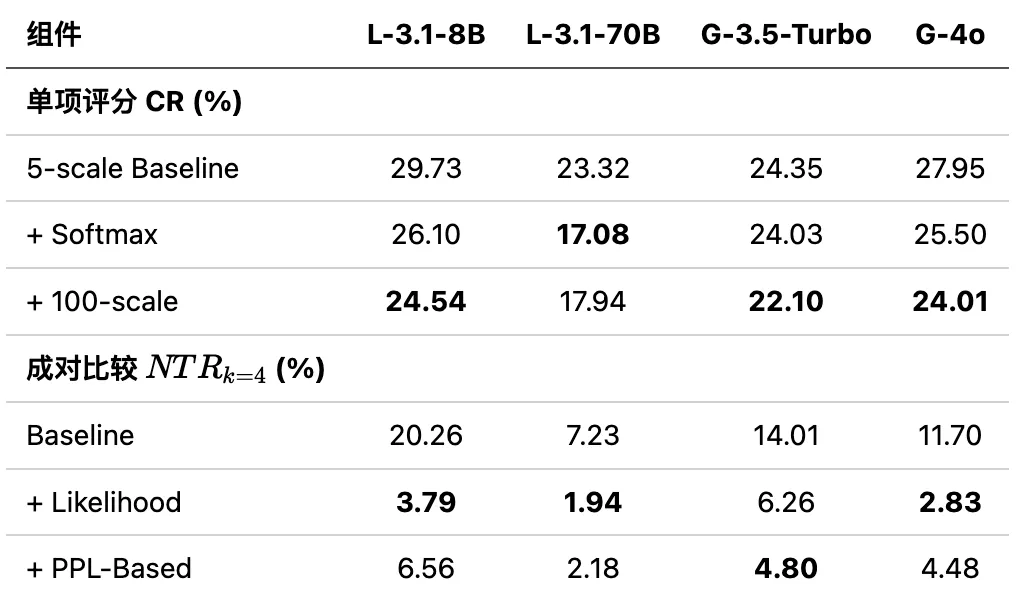
为了搞清楚每个组件的贡献,作者做了逐项消融(这里额外加入了 GPT-3.5-Turbo 作为参考):
表 2:逐个拆开看,softmax 归一化和 100 分制对评分不一致各有贡献;似然聚合和 PPL 方法对传递性不一致效果都很明显,似然聚合整体略优。
06|换个模型还管用吗?
上面的主实验只用了 Llama-3 和 GPT-4o。一个自然的问题是:换成别的架构还有效吗?
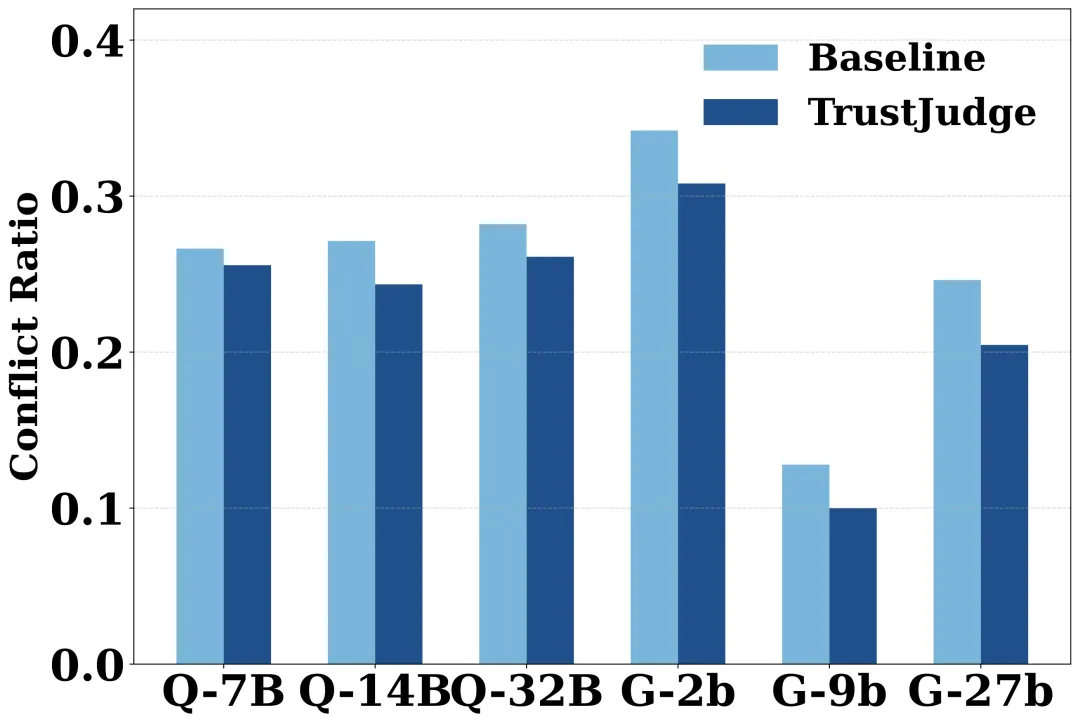
管用。作者把实验扩展到 Qwen-2.5(7B / 14B / 32B)、Gemma-2(2B / 9B / 27B)、Llama-3(3B / 8B / 70B)、GPT 四个家族、共 12 个变体。
图 3:四个模型家族上的不一致性对比。左图为评分-比较不一致,右图为传递性不一致,TrustJudge 在所有架构上都有改善。
几个值得注意的点:
-
分布敏感评分的效果跟模型架构无关,都能降不一致性。
-
加上似然感知聚合后,8B 模型的传递性甚至比未使用 TrustJudge 的 70B 模型更好。
-
9B 的 Gemma 比 27B 的 Gemma 不一致性更低——不是越大越好。
07|推理模型反而更不靠谱
一个意外发现:专门练过推理能力的模型,做评估时反而更容易自相矛盾。

DeepSeek-R1 蒸馏版的评分-比较不一致率 58.75%,是同参数量 Llama 的将近两倍。看起来在数学数据上做强化训练这件事,是以评估能力为代价的。
不过 TrustJudge 在这么高的不一致基线上依然有效:CR 降了将近 10 个点,传递性不一致从 63.98% 压到了 18.50%。
08|拿来做 Reward 也好使
除了评估,TrustJudge 还有一个实际用途:给强化学习提供奖励信号。
作者把它接到 GRPO(Group Relative Policy Optimization)上训练 Qwen2.5-7B-Instruct,训练数据覆盖摘要、数学推理、指令遵循等,一共 8,600 条。
表 3:用 Baseline 奖励训练的模型在两种协议下都没超过原始模型(反而略降);用 TrustJudge 奖励训练的模型两边都涨了。
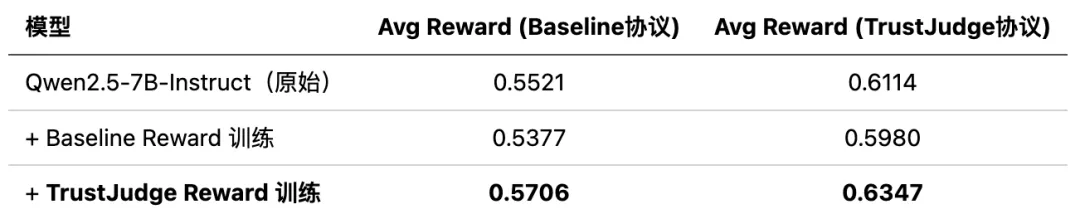
图 4:训练过程中的奖励变化。TrustJudge 的奖励信号全程高于 Baseline。
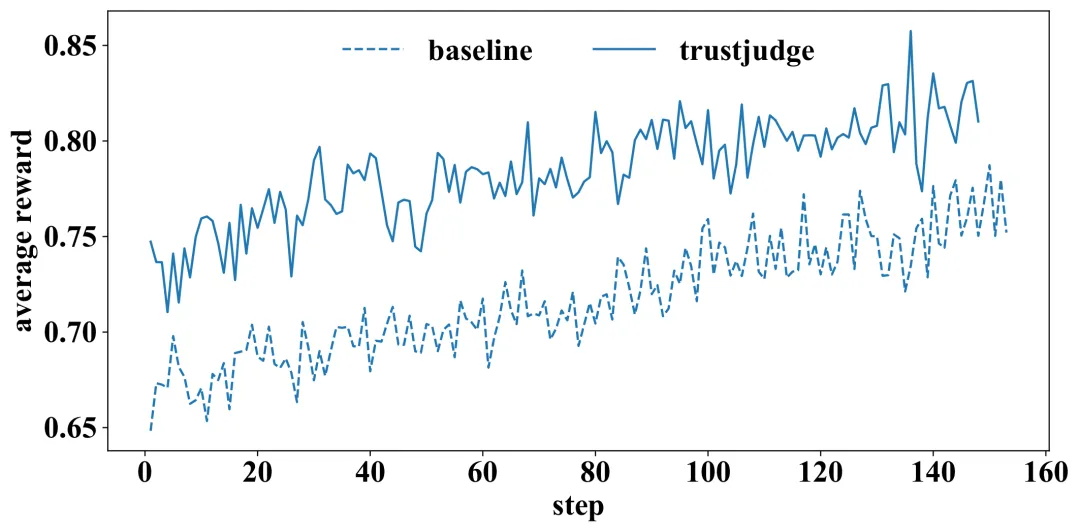
图 5:验证集上各任务的奖励曲线,实线是 TrustJudge,虚线是 Baseline。改善不是靠单个任务拉的,是全面的。
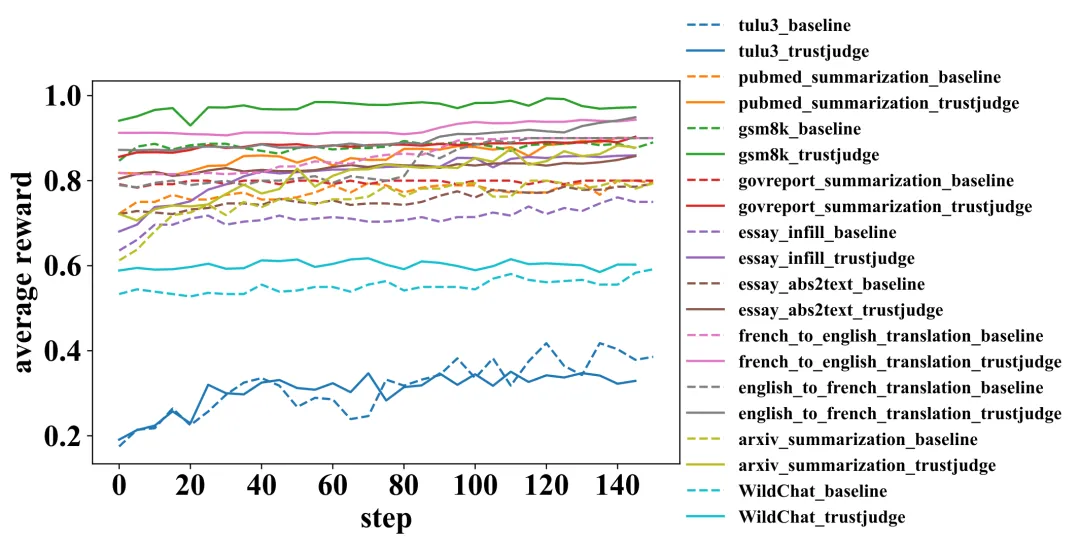
道理也好理解:评估越一致,奖励信号噪声越小,模型学得越准。
09|光提高打分精度够不够?
看完前面的实验,可能会有人问:TrustJudge 里面既提高了评分粒度(5 分 → 100 分),又加了概率归一化。那要是我只做前者,不做后者,行不行?
图 6:5 分、10 分、100 分三档粒度下的不一致性变化。粒度越高不一致越低,但在同一粒度下 TrustJudge(虚线)始终低于 Baseline(实线)。

结论是:提高粒度有帮助,但光靠粒度不够。TrustJudge 赢在粒度提升 + 概率归一化两件事叠加到一起。
10|小结
TrustJudge 做的事情可以用两句话讲清楚:
-
离散评分丢信息 → 改用分布敏感评分,把概率分布的信息保住。
-
模糊平局坏传递性 → 改用似然感知聚合,让模糊判定变得清晰。
实际效果上,它不用训练,开箱即用;跨 Llama、GPT、Qwen、Gemma 四个架构都有效;除了做评估,接上 GRPO 当奖励信号也能用;而且有理论证明兜底。说到底,如果我们要让大模型来当裁判,总得先确认这个裁判自己别前后矛盾才行。
本文共同第一作者王一栋(北京大学)和宋昀泽(新加坡国立大学)主要从事大语言模型评估与对齐研究。通讯作者王存翔(清华大学)和叶蔚、张世琨(北京大学)分别在自然语言处理、软件工程和知识推理等方向有长期积累。团队成员来自北大、清华、南大、NUS、CMU、西湖大学、东南大学、东京科学大学等多所高校,长期关注 LLM 可信评估问题。
编辑:文婧
