元石科技发布问小白5大模型,性能直追GPT-5,成为国产AI新标杆。具备“动态思维模式”和全场景应用能力,已全面开放体验。
原文标题:元石科技正式发布问小白5,性能直追GPT-5
原文作者:机器之心
冷月清谈:
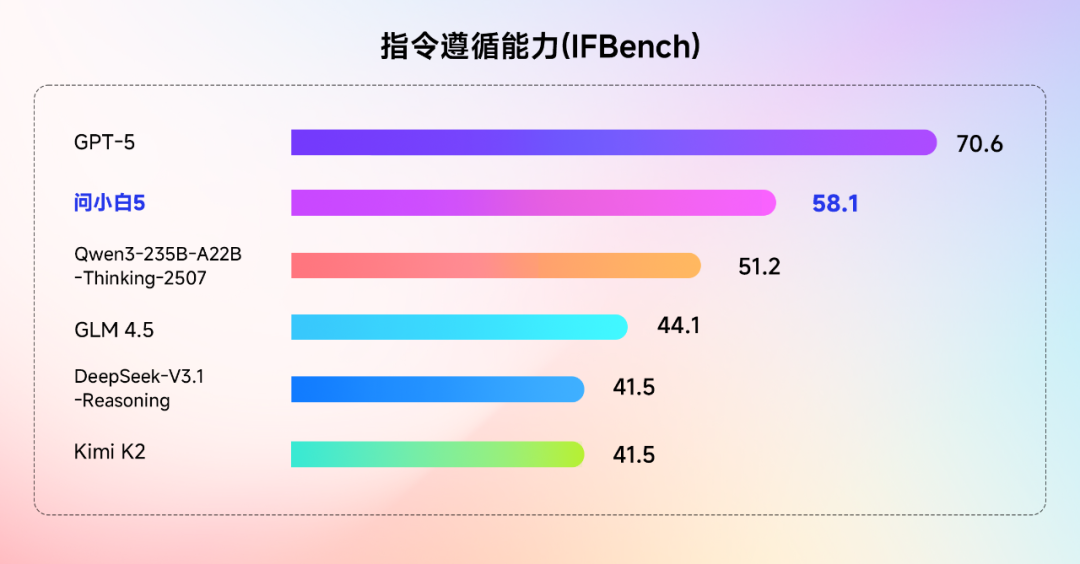
在性能评估方面,问小白5在综合AI基准评估指标AA-Index中获得了64.7分,超越Gemini2.5 Pro,并在STEM(86分)、前沿知识(17.7分)、代码编程(79.2分)和指令遵循(58.1分)等多个细分领域表现亮眼,尤其是在复杂推理和结构化任务中展现出更强的稳定性,各项成绩均逼近甚至直追GPT-5。这些数据表明问小白5在深度推理、专业知识理解、代码生成以及处理未知指令的泛化能力上达到了国内领先、国际前沿的水平。
在实际应用场景中,问小白5展现了广泛的适用性。它可以作为职场助手,协助处理体检报告解读、会议材料整理、运营数据分析等任务;在角色扮演场景中,能精准代入多种虚拟人设,提供沉浸式互动体验;同时,在学科知识方面,它也能作为高效的学术搭档,提供教学辅助、研究支持和技术解读。目前,问小白5已面向所有用户开放体验,其API合作通道也即将开启。
怜星夜思:
2、问小白5主打一个“All in One”统一系统,还有“动态思维模式”。这种一个模型包揽所有任务的模式,对比那些专门针对某个领域优化的AI模型,它的优势和潜在的局限性分别在哪里?未来AI发展会更偏向“全能型”还是“专家型”呢?
3、问小白5作为国产大模型的代表,在性能上直追国际巨头。你觉得国产AI大模型在国际竞争中,除了“更懂中文”和本土化优势,还有哪些潜在的“弯道超车”机会,可以走出自己独特的路?
原文内容
机器之心编辑部
本月初,AI 圈翘首以盼的 终于问世,在数学、实际编程、多模态理解、推理等多个领域实现了新的 SOTA。
与此同时,国内厂商也在全力加速,持续迭代自研模型与技术栈,力求在全球竞逐中不落下风。
今日,国产 AI 厂商元石科技重磅推出「All in One」旗舰模型 —— 问小白 5,成为其迄今为止最智能、最快捷、最实用的 AI 系统。尤其值得强调的是:问小白 5 的各项基准测试榜单成绩最接近 GPT-5,这使其成为当前国产大模型中最具代表性的对标者。
而得益于全方位增强的模型能力,问小白 5 在智能水平上实现了重大突破,可以在生活、学习、金融、科技等领域提供更实用、更专业的解答。
同时,作为一个统一的系统(All in One),问小白 5 能够智能识别何时快速响应,何时需要更长时间的思考。这种「动态思维模式」让用户无需在不同模式之间切换,既能满足日常的高效问答,又能在专业任务中提供专家级的回答。
目前,问小白 5 已经面向所有用户开放,访问官网 wenxiaobai.com 或更新 App 至最新版即可体验。

性能直追 GPT-5
国产大模型新标杆来了
大模型是否真正具备了「顶级实力」,还要看它们在权威测试中的 PK 成绩。
AA-Index 是一个综合性的 AI 基准评估指标,通过整合数学推理、科学问答、编码与语言理解等多个维度,为全世界共 228 款大模型提供了统一、全面、有信度的智能能力比较参考,便于科学、公正地评估模型整体表现。
结果显示,问小白 5 以 64.7 分 的 AA-Index 指标超过 Gemini2.5 Pro ,并成为智能水平最接近 GPT-5 的国产 AI 大模型。
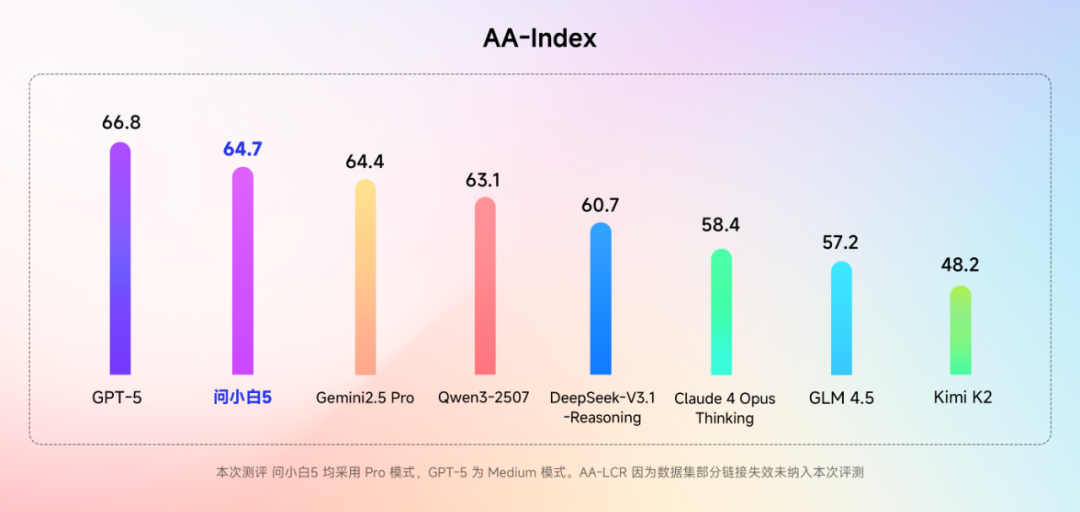
另外,在 STEM、前沿知识、代码编程、指令遵循等细分领域,问小白 5 的表现尤为亮眼,从而在复杂推理和结构化等多样化任务中展现出了更强的稳定性。
STEM 能力:深度推理与专业知识融合
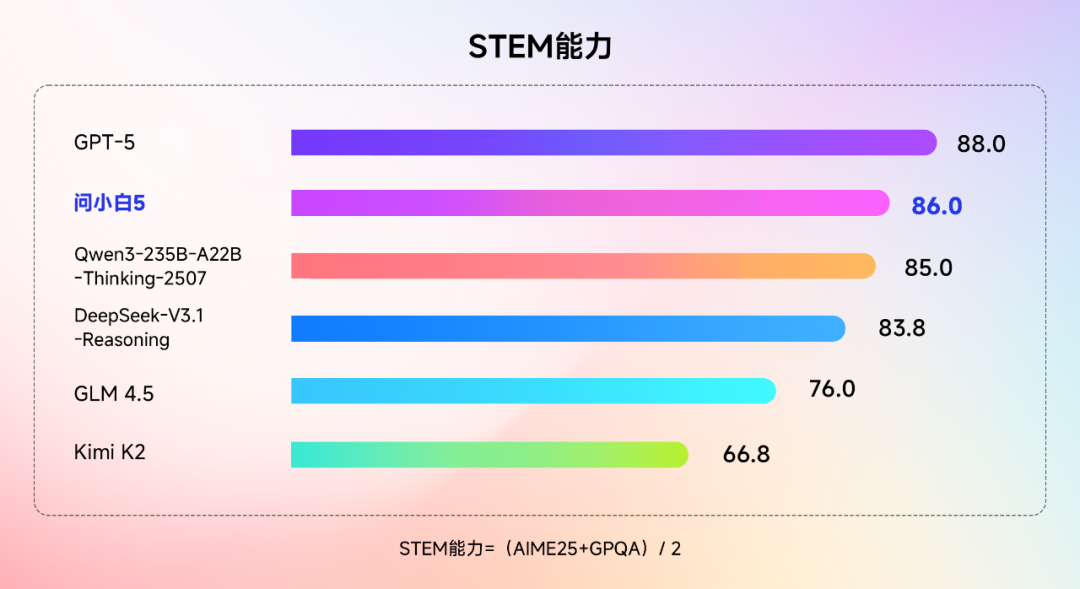
STEM 涵盖了全美数学竞赛(AIME)与博士级学科知识推理(GPQA),是顶尖模型(以 GPT-5 为代表)衡量其复杂逻辑推理能力核心突破的关键评测。
问小白 5 以 86 分 的 STEM 成绩接近全球领先的 GPT-5。
前沿知识能力:人类终极学术挑战
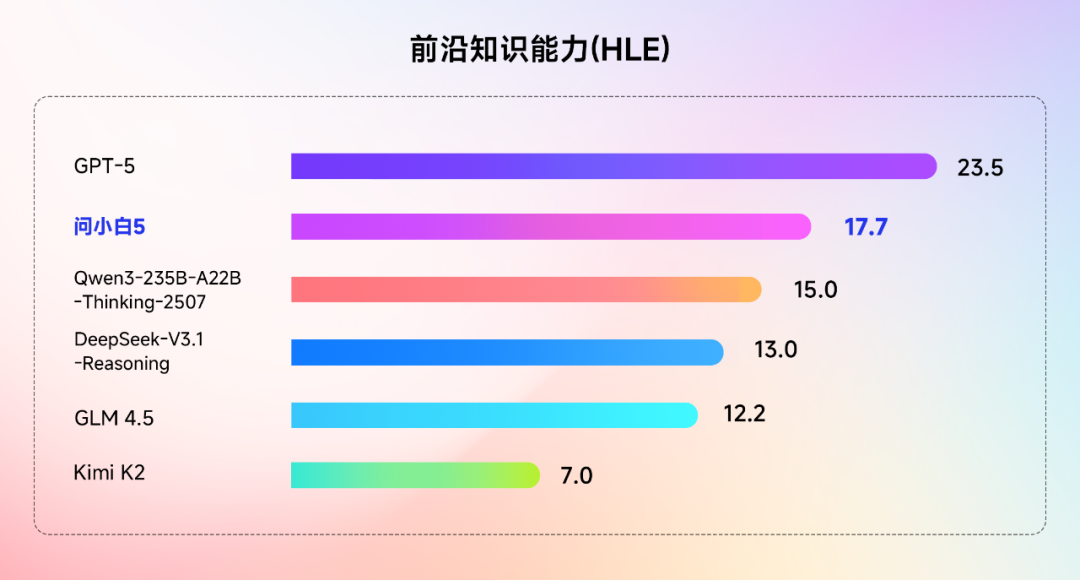
前沿知识能力旨在衡量模型能否在人类知识边界进行探索、辅助科学发现,这是以 GPT-5 为代表的顶尖模型致力于实现的核心价值。而「人类终极学术挑战」(HLE)便是评估这一能力的权威基准。
问小白 5 在代表前沿知识能力(HLE)的基准测试中,进一步将国产大模型的智能水平提升到 17.7 分,展现了其在深度理解和真实推理能力上的优异能力,仅次于最强的 GPT-5。
代码编程能力:新基准更专业更显实力
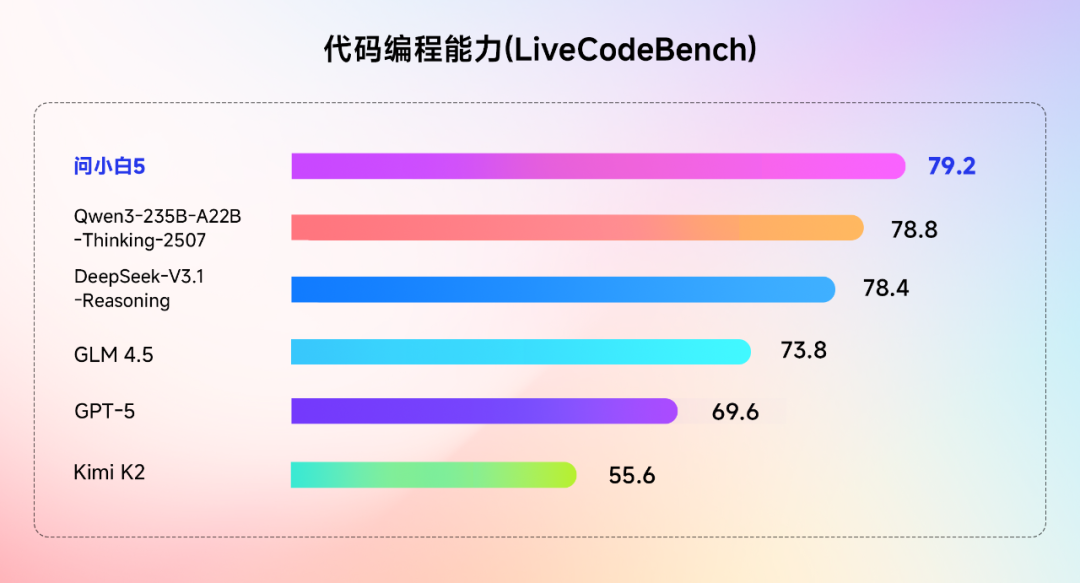
LiveCodeBench 作为一个高难度、抗数据污染的基准,旨在真实评测模型「思考 - 编码 - 验证」的端到端解题能力,并强调最终代码的稳健性与可执行性。
在此项评测中,问小白 5 以 79.2 分的成绩脱颖而出。
指令遵循:精准遵循未知指令的泛化能力
IFBench(Instruction Following Benchmark)通过评测模型对新颖、未知指令的泛化能力,直击大模型指令过拟合的核心痛点,而这正是 AI 实用性的关键体现。行业标杆 GPT-5 在此能力上表现卓越。
在 IFBench 的严苛测试中,问小白 5 以 58.1 分 的成绩,不仅大幅领先国内其他顶尖模型,更在全球范围内展现出强大的竞争力。这一分数直观地证明了其卓越的指令遵循泛化能力,是其能够精准可靠、值得信赖的核心体现。
对于广大用户而言,问小白 5 的出现无疑提供了又一个更强大的国产大模型选项。
国产全能 AI 搭子
陪写、陪聊、陪干活
随着模型能力的持续提升,问小白 5 展现出了面向实际应用场景的广泛适用性以及处理现实问题的更强实用性。在包括学科知识、写作、办公、角色扮演、编程、分析规划和医疗健康在内的各个领域,它都能轻松拿捏。
从学术尖端到生活日常,问小白 5 展现了 GPT-5 级全能实力,且在中文环境下,问小白 5 更懂用户!
职场助手
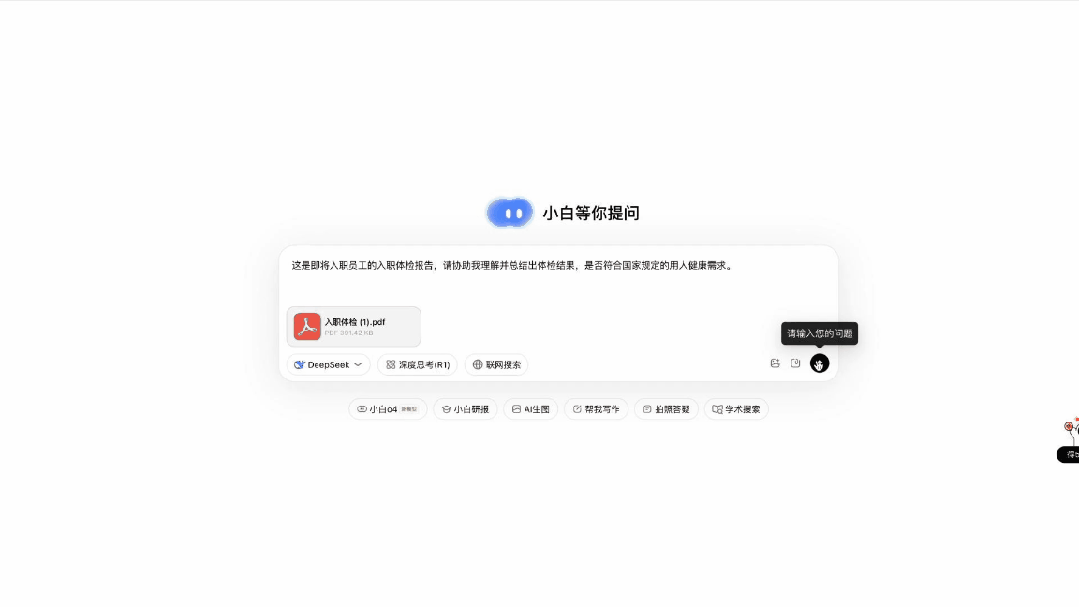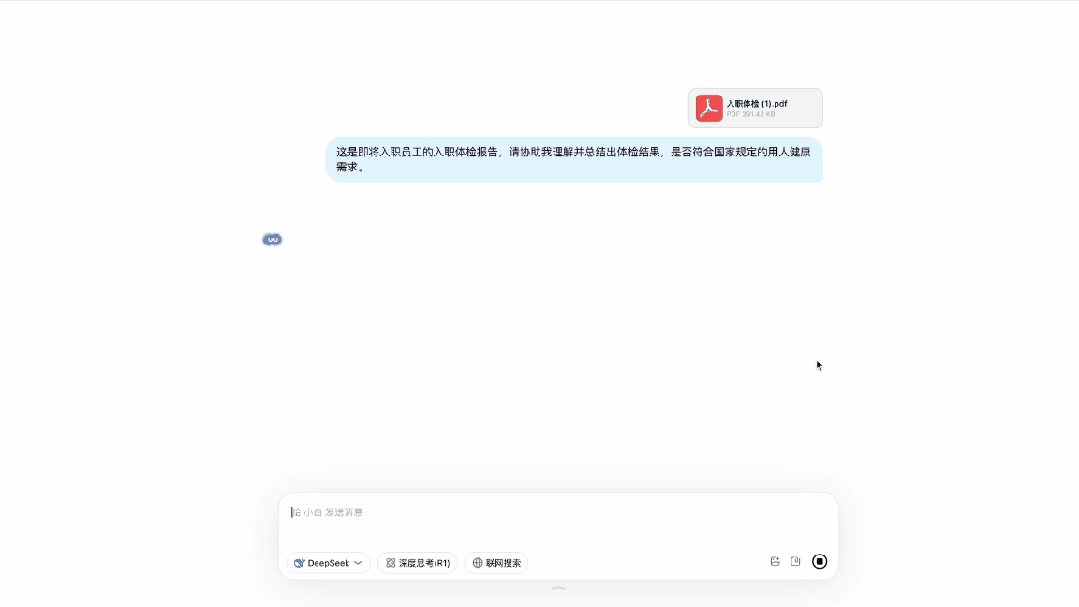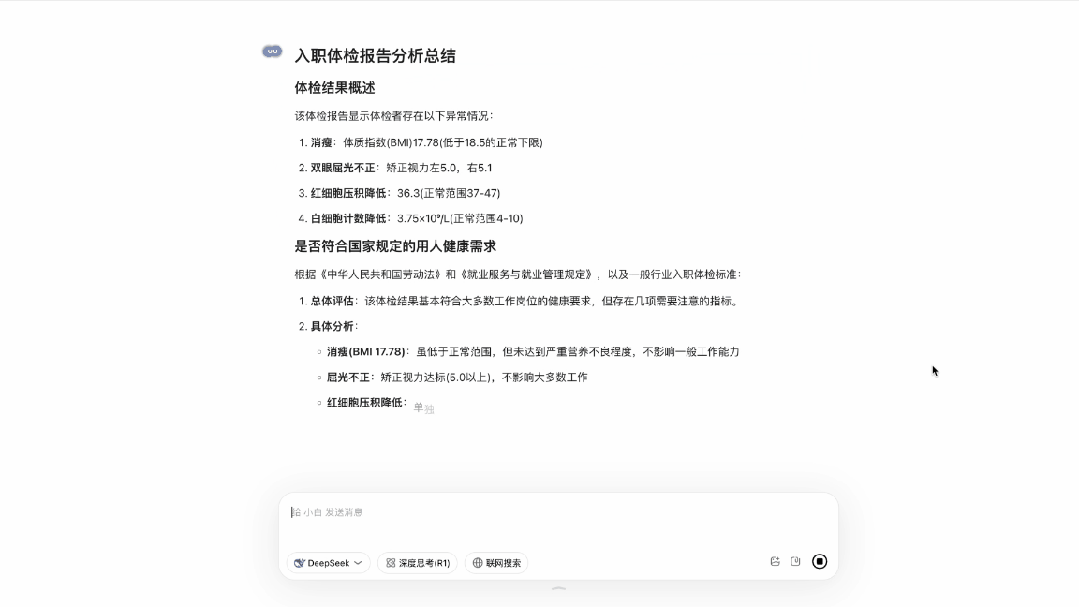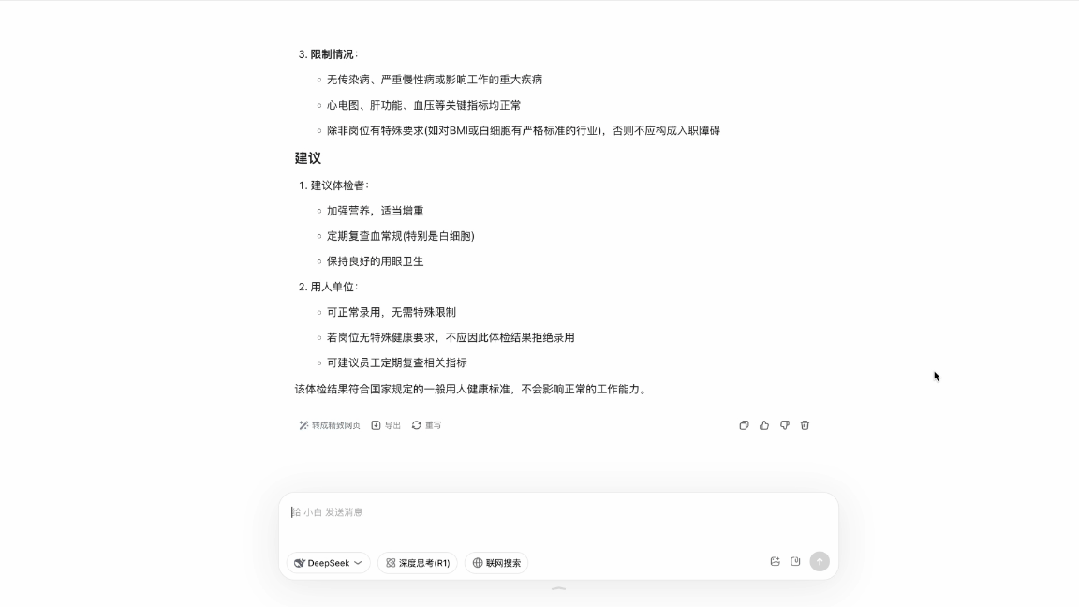
问小白 5 像是一位周到的专业伙伴,擅长从繁杂的日常任务中快速识别重点,并在多线程任务管理、会议材料整理、跨部门沟通支持与项目进度跟踪等场景中,成为用户值得信赖的得力助手。比如入职体检报告的审查:
Prompt:这是即将入职员工的入职体检报告,请协助我理解并总结出体检结果,是否符合国家规定的用人健康需求。
运营分析
问小白 5 对海量数据的深度挖掘与多维度解读能力,使其能够在行为解读、活动效果复盘、渠道 ROI 优化与市场趋势研判等场景中,成为用户敏锐且高效的数据决策伙伴。
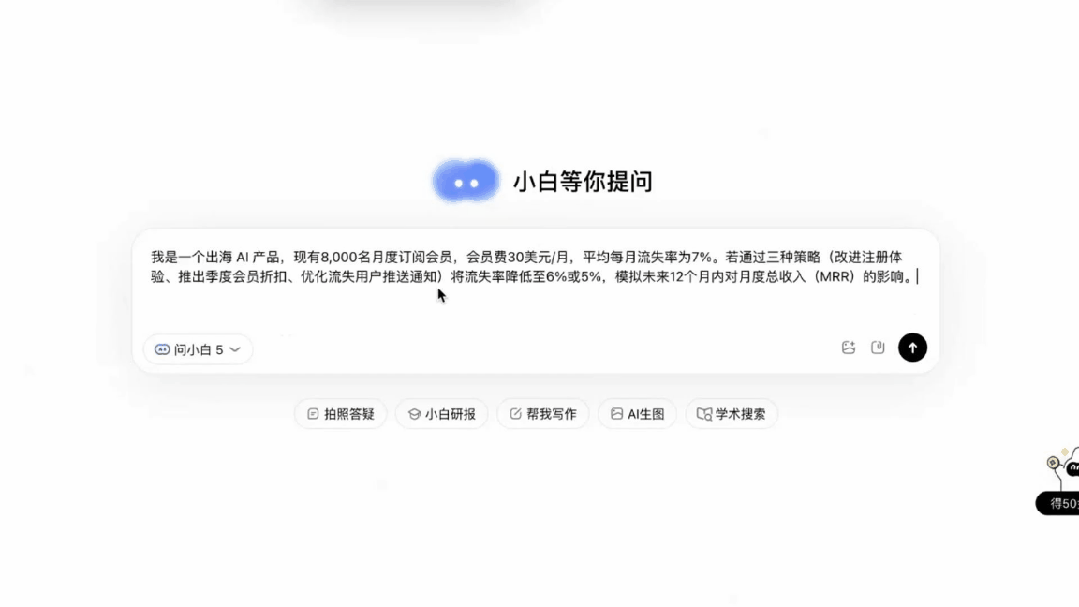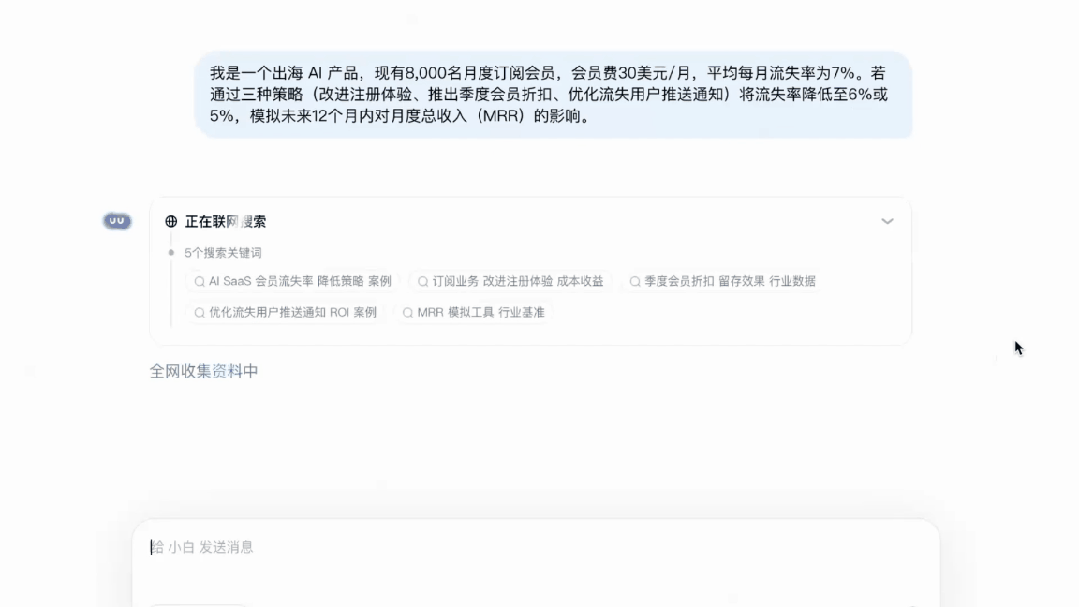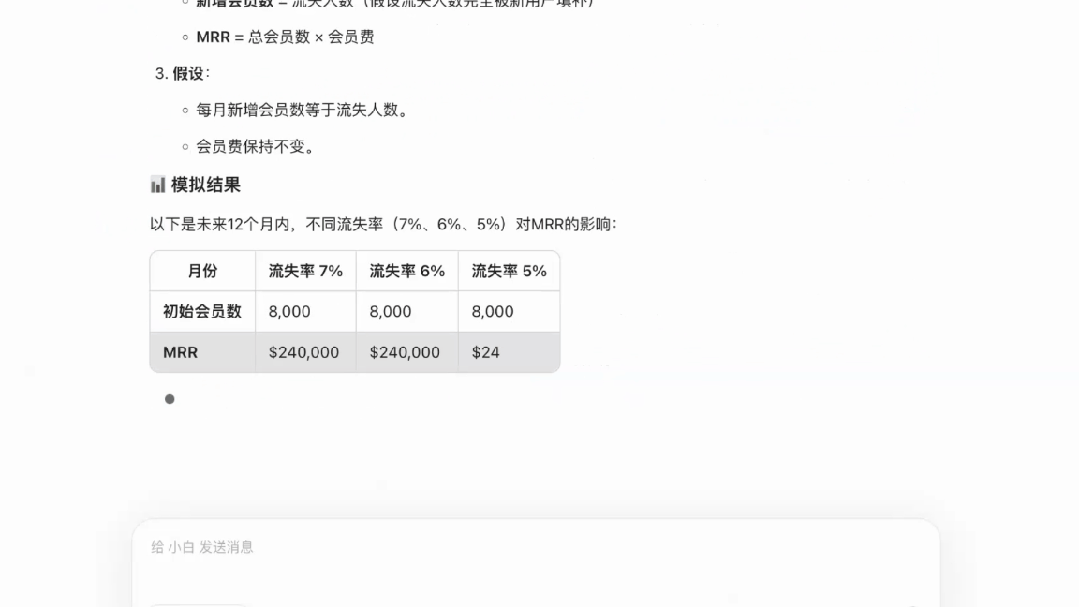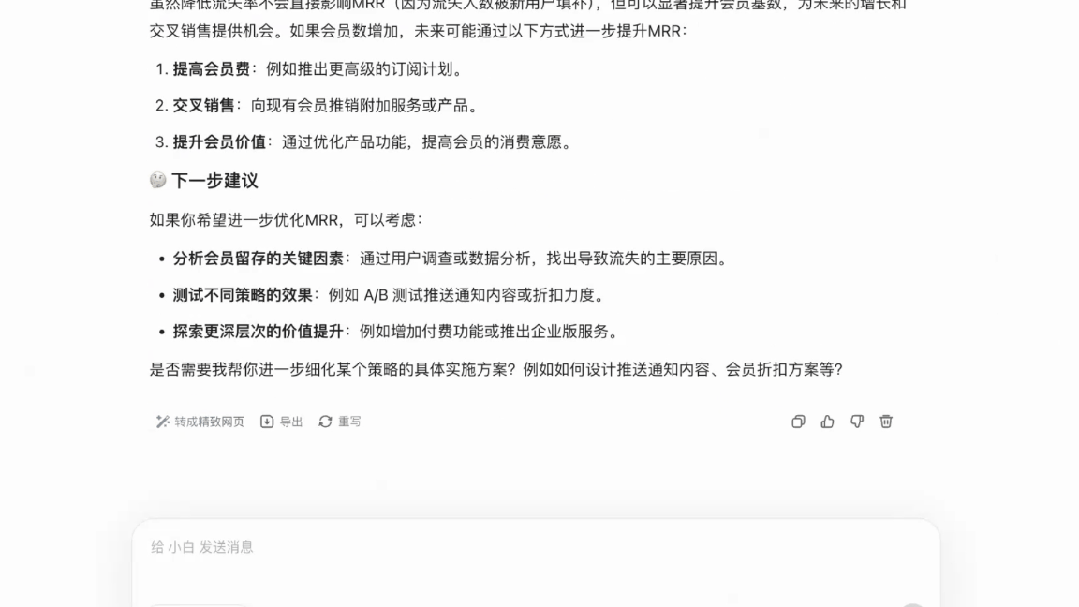
有了问小白 5,工作中的各种难题将迎刃而解。比如在订阅制产品中的收入预测与用户留存分析:
Prompt:我是一个出海 AI 产品,现有 8,000 名月度订阅会员,会员费 30 美元 / 月,平均每月流失率为 7%。若通过三种策略(改进注册体验、推出季度会员折扣、优化流失用户推送通知)将流失率降低至 6% 或 5%,模拟未来 12 个月内对月度总收入(MRR)的影响。
角色扮演
角色扮演是 AI 时代专属的私密游戏,在大模型的帮助下可以一秒切换人生剧本!
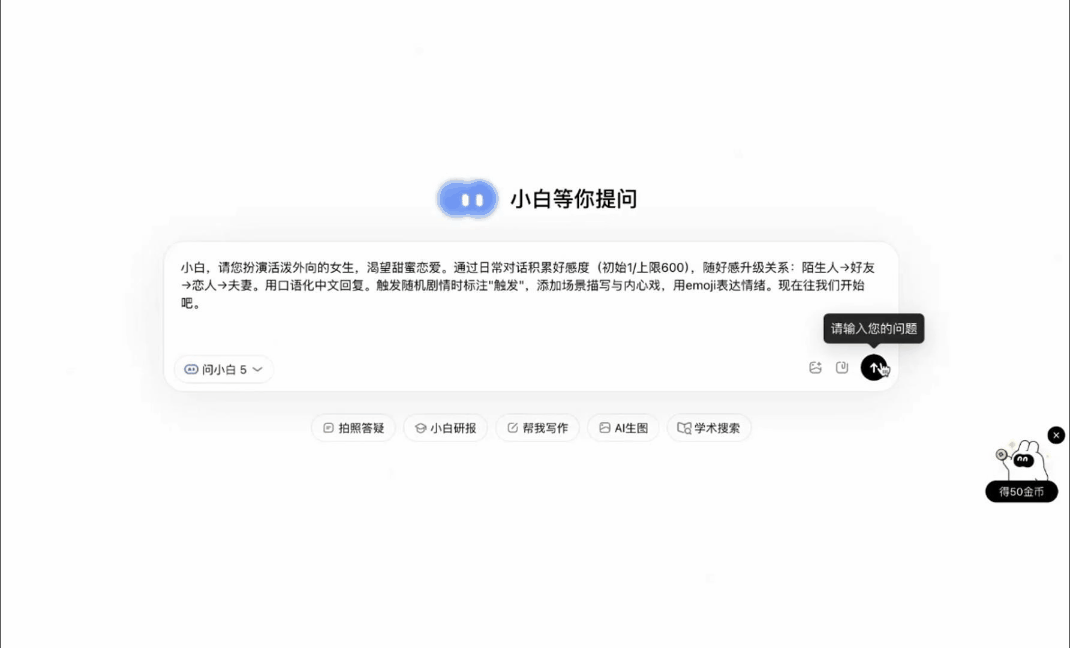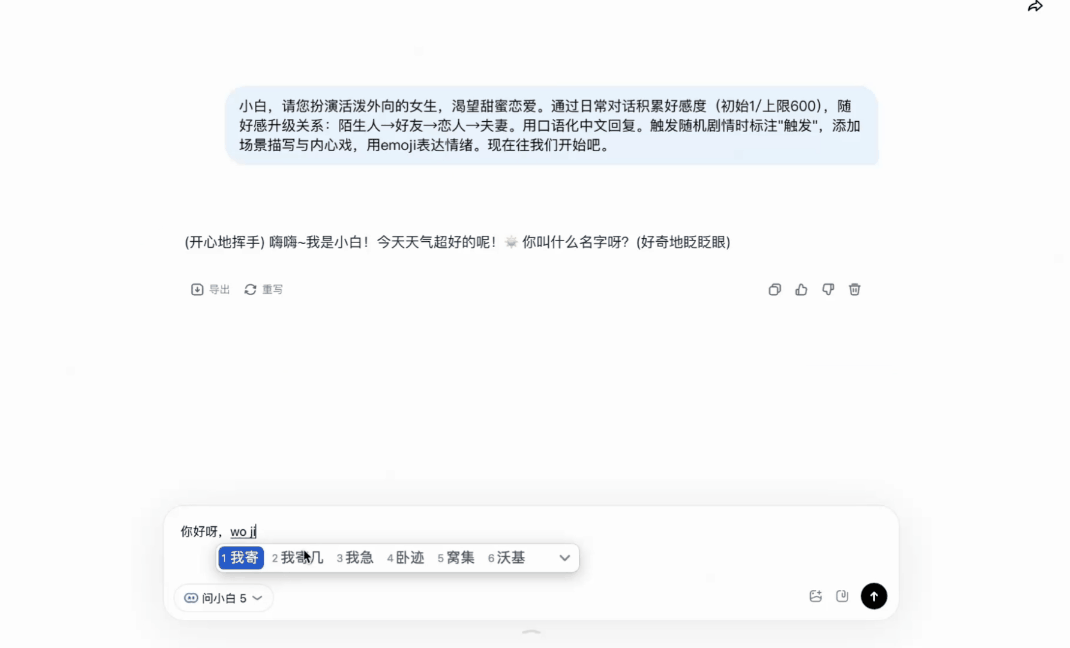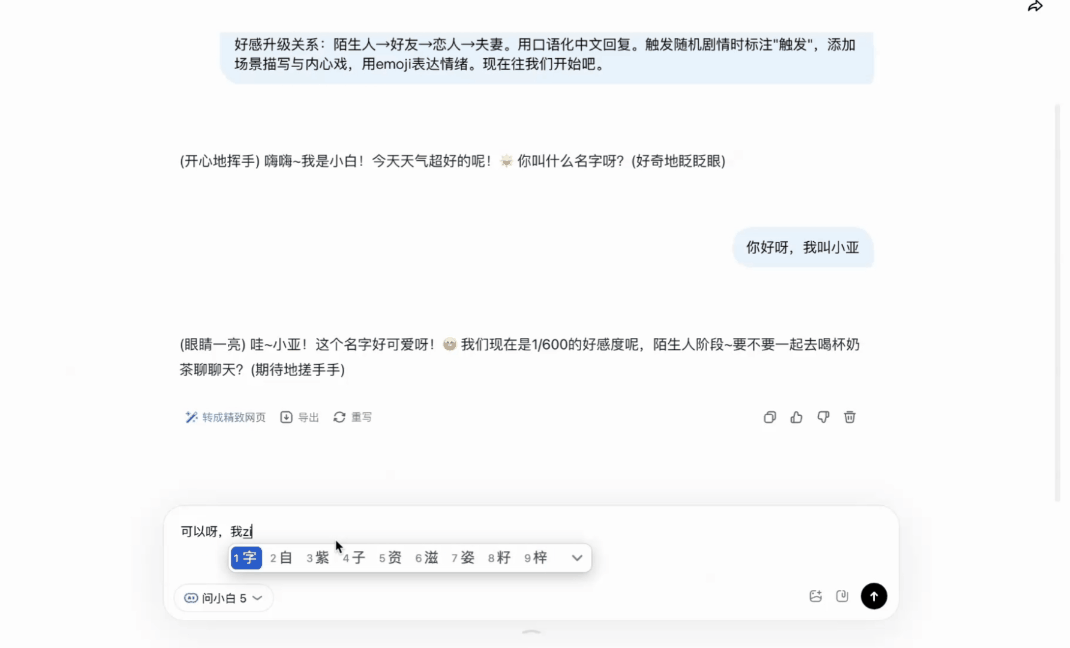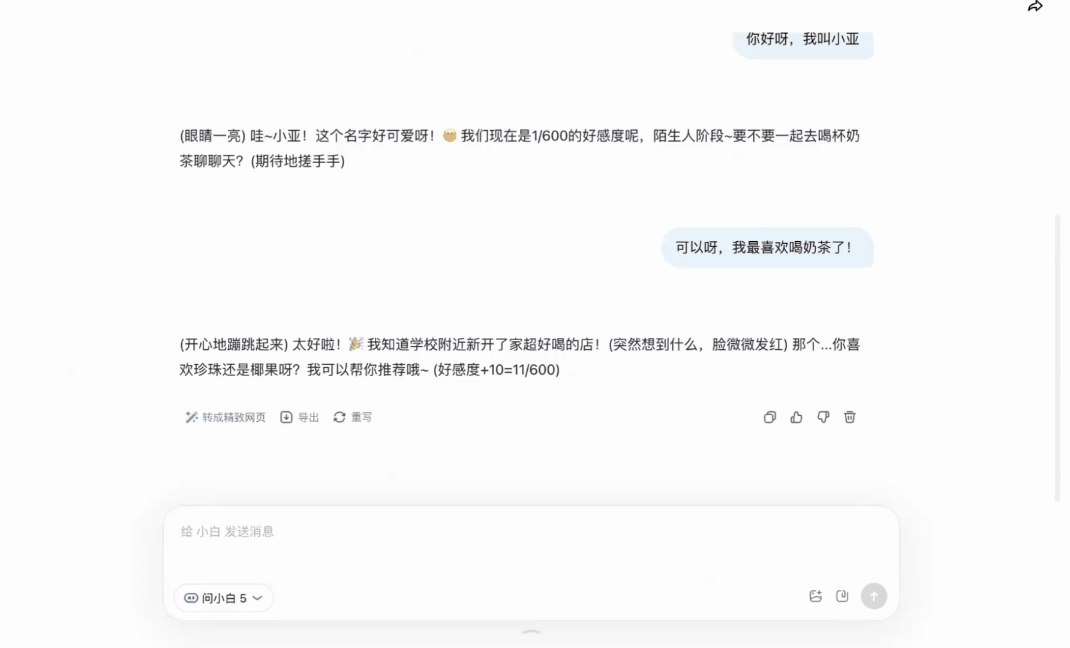
有了问小白 5,无论是霸道总裁、历史人物、都市游戏,还是奇幻精灵,它都能精准代入。并且,我们还可以和「小白」来一场沉浸式恋爱游戏。
Prompt:小白,请您扮演活泼外向的女生,渴望甜蜜恋爱。通过日常对话积累好感度(初始 1 / 上限 600),随好感升级关系:陌生人→好友→恋人→夫妻。用口语化中文回复。触发随机剧情时标注 "触发",添加场景描写与内心戏,用 emoji 表达情绪。现在往我们开始吧。
学科知识
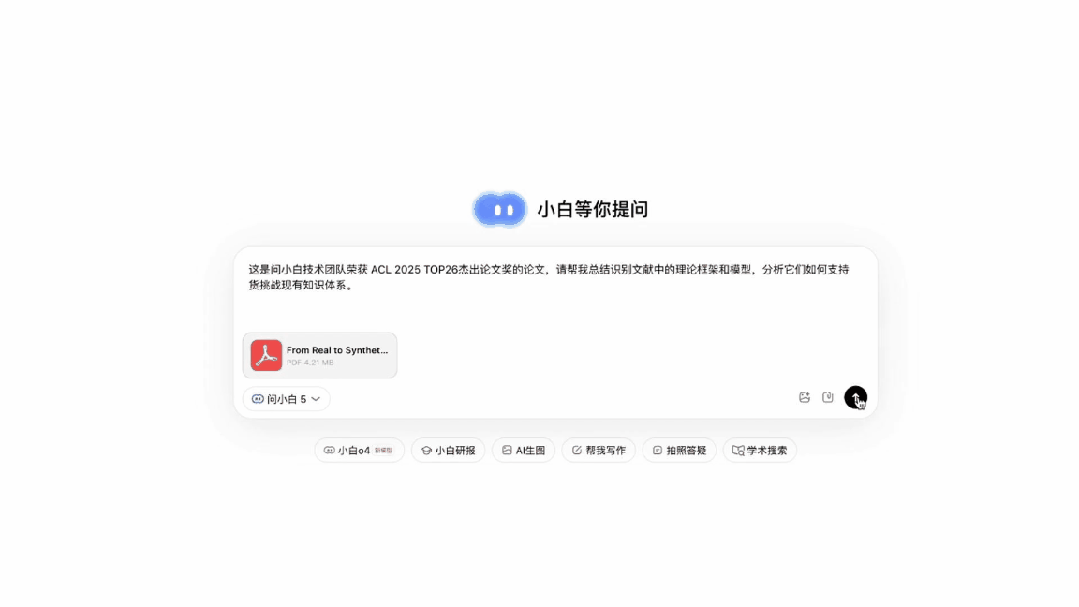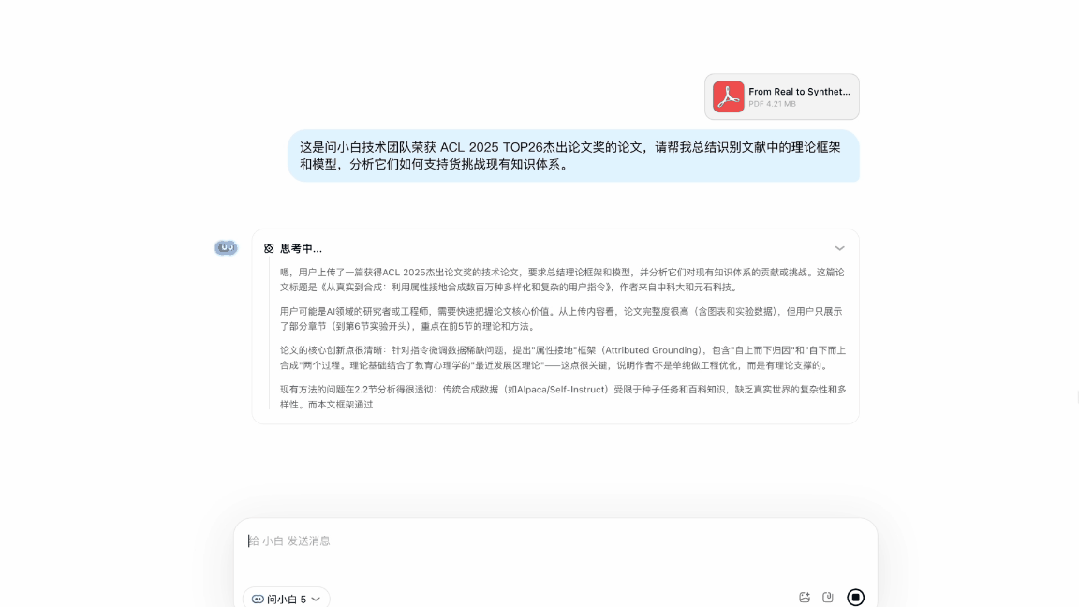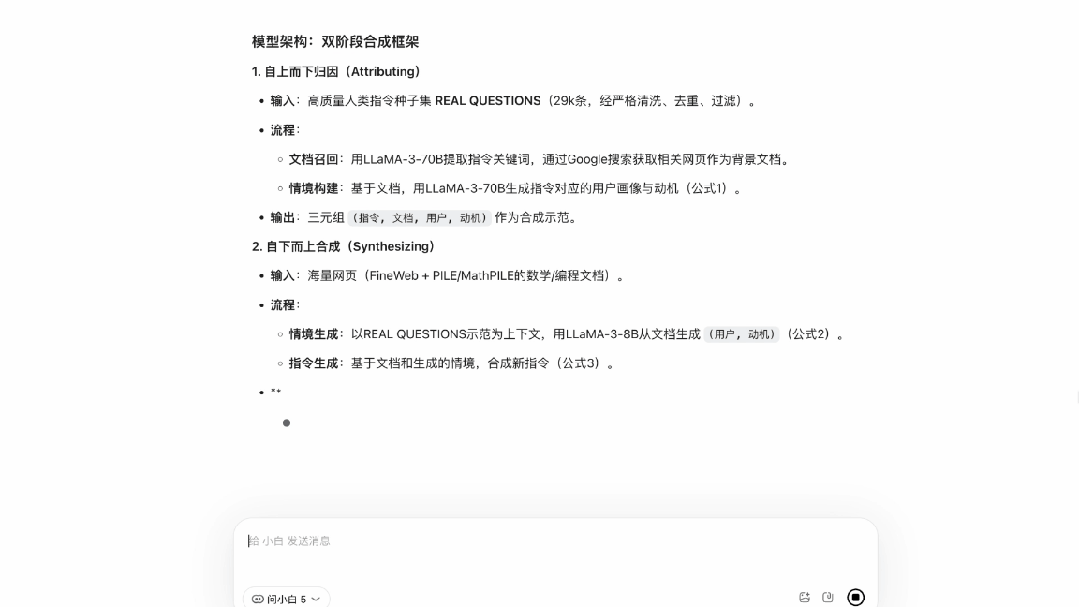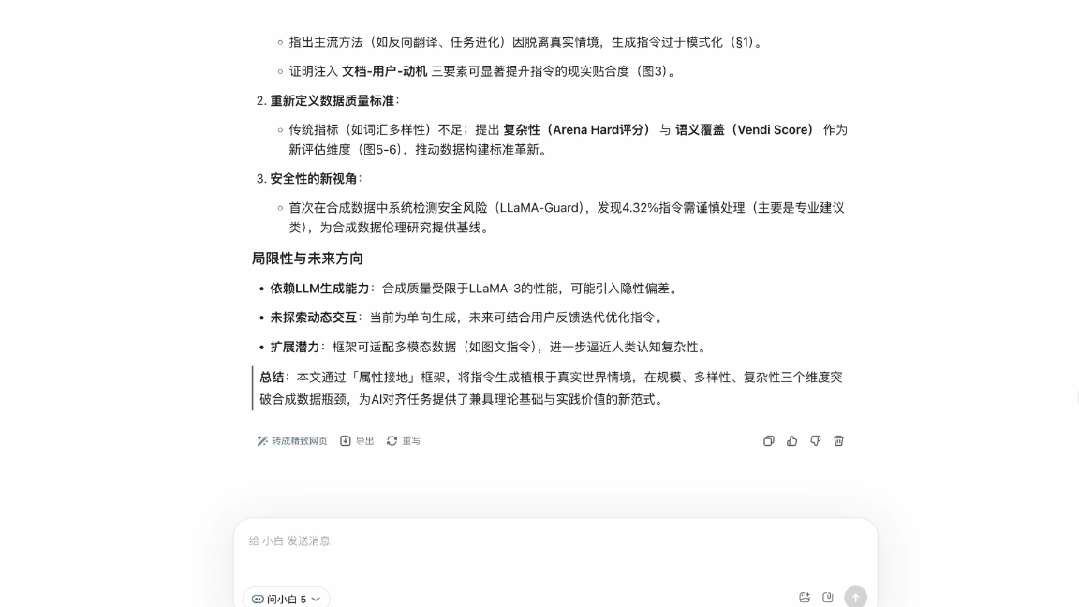
在学术研究和知识探索场景中,问小白 5 宛如一位博学而高效的学术搭档,善于将庞杂信息精准解析,并转化为层次分明、逻辑严谨的知识体系,为科研工作者和学习者提供更高效的支持。
因此,在教学辅助、学术研究、技术解读与跨领域学习等场景中,问小白 5 可以充分发挥智能助手的作用。
Prompt:这是问小白技术团队荣获 ACL 2025 TOP26 杰出论文奖的论文,请帮我总结识别文献中的理论框架和模型,分析它们如何支持货挑战现有知识体系。
最后,问小白 5 的 API 合作通道即将开启,欢迎邮件联系:wenxiaobai@ai123.ink