《从零构建大模型》GitHub爆火,豆瓣9.3分。本书教你亲手搭建、训练、微调大模型,代码示例友好且算力要求低,笔记本也能跑,是初学者快速入门LLM的实践指南。
原文标题:4 个月狂飙 22k Star,这本书凭什么?
原文作者:图灵编辑部
冷月清谈:
文章指出,本书内容覆盖了构建大模型的完整流程,包括数据集处理、模型预训练和针对特定任务的微调。作者将复杂的LLM核心组件拆解成易于理解的知识点,并按章节顺序引导读者逐步实践。特别值得一提的是,所有代码示例都经过精心设计,即使在算力有限的笔记本电脑上也能顺利运行,极大降低了普通人学习大模型的门槛。在编码方面,本书以PyTorch为主要开发库,代码简洁高效,并配有丰富的注释和可视化结果。
在内容组织上,作者采用实用主义导向,不过多纠结于深层原理,而是以大量的代码示例为主线,带领读者解决实际问题。例如,在讲解Transformer模型时,并非从历史背景入手,而是直指RNN模型的局限性,并逐步构建带位置编码的嵌入层和注意力机制来解决问题,从而串联起Transformer的核心功能。文章还通过对比小数据集和大数据集训练效果,直观展现了海量数据对模型性能的关键作用。最后,本书还详细介绍了用于分类和指令执行的微调技术,帮助读者优化模型以适应特定任务。书中还特别收录了关于DeepSeek和未来LLM发展的“彩蛋”文章,展示了作者对技术前沿的关注。
这本书最大的亮点在于对初学者的友好程度,即使是编程经验较少的读者,也可以通过运行随书代码,获得对大模型架构和工作原理的整体认识。它为那些渴望进入大模型领域但又苦于算力或理论门槛的开发者,提供了一条清晰可行的学习路径。
怜星夜思:
2、这本书强调实践,理论部分讲得不多。对于初学者来说,是先代码跟着跑起来重要,还是基础理论打扎实更关键?大家学习时会怎么选择?
3、文章提到书里有个关于DeepSeek和未来LLM发展的彩蛋。大家觉得未来个人或者小团队在LLM领域还有没有机会?或者说,在算法框架已经很成熟的前提下,我们该怎么寻找新的创新点呢?
原文内容
Github 上超火的开源项目 LLMs-from-scratch(项目地址:https://github.com/rasbt/LLMs-from-scratch),中文版 4 月份才上市,目前 Github 上已有 62.6k,4 个月时间飙升超 22k。
作为一本实操性很强的书,作者不仅开发了一个小型的类 GPT-2 大语言模型,还实现了数据集处理、模型预训练、针对特定任务的微调,妥妥涵盖了构建大模型的整个流程。

作者 Sebastian Raschka 把大模型的核心组件拆分成多个知识点,引导读者按章节编排的顺序渐进地进行实践,不仅降低了学习难度,同时书中代码示例也经过精心设计,就算你在算力有限的条件下也能使用,在笔记本上就可以搭建运行。对于普通人来说,简直不要太友好。
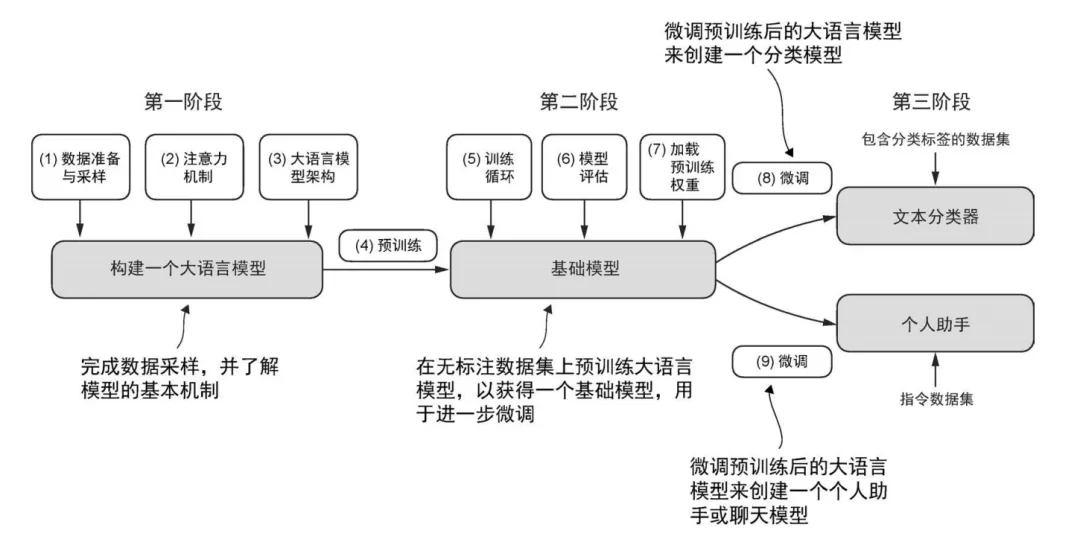
构建大语言模型的 3 个主要阶段:实现模型架构和准备数据(第一阶段)、预训练大语言模型以获得基础模型(第二阶段),以及微调基础模型以得到个人助手或文本分类器(第三阶段)
在编码部分作者使用 PyTorch 作为主要开发库,这个功能强大的开源库可以很方便的搭建神经网络框架,操作张量、损失函数等复杂计算。使得操作变得简单易用,提升开发效率,整个模型开发完成后,代码量也才几百行。另外他还提供了大量的代码注释和输出可视化结果进行说明,直观易读。
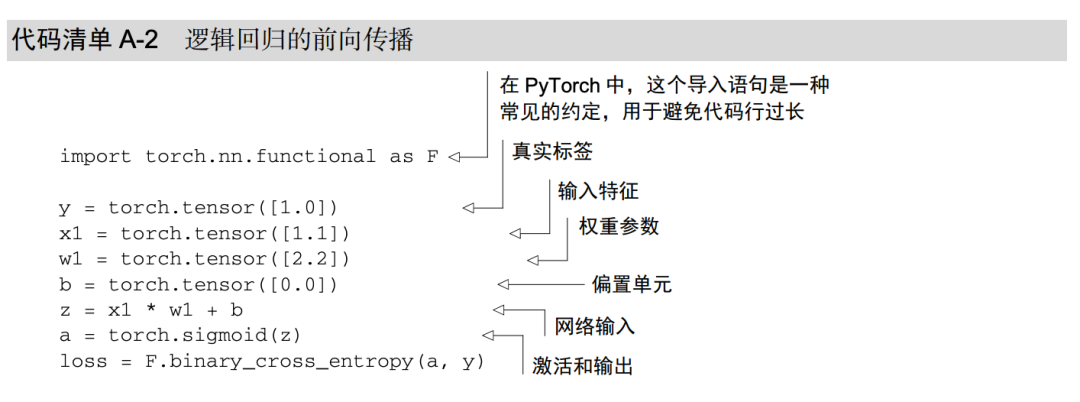
在内容部分作者采用实用主义导向,正文不过多讲解原理性的知识,以代码示例为主,带读者一步步去解决实际问题。
比如在 Transformer 模型开发阶段,并没有过多介绍自然语言处理的起源,或 RNN 模型背景及实现原理,仅提出 RNN 模型无法很好地获取长距离上下文依赖的局限性,作者从这个问题入手,实现了带位置编码的嵌入层,保存词元顺序和相互关系,再实现注意力机制用于并行捕获上下文信息,这样模型就可以在保持语序的前提下突破上下文长度的限制,解决了 RNN 模型的缺陷。作者正是通过这样一步步地拆解问题,把 Transformer 模型的核心功能知识点串联起来,大大降低了理解门槛。
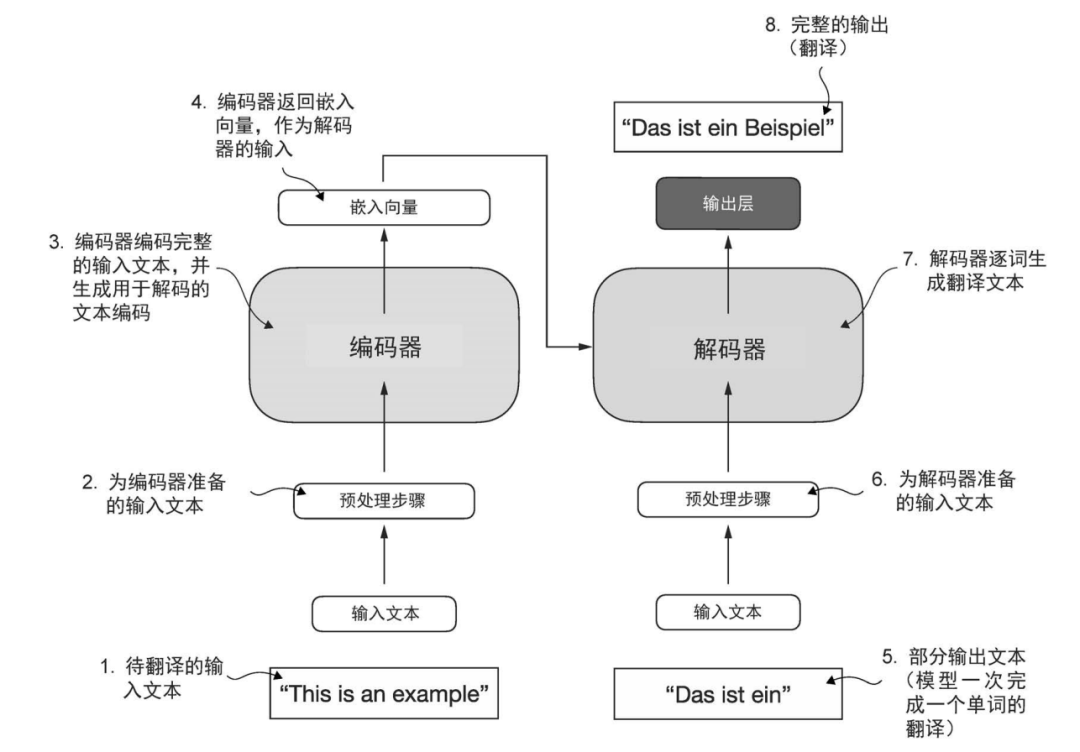
原始 Transformer 架构的简化描述,这是一种用于机器翻译的深度学习模型。Transformer 由两部分组成:一个是编码器,用于处理输入文本并生成文本嵌入(一种能够在不同维 度中捕获许多不同因素的数值表示);另一个是解码器,用于使用这些文本嵌入逐词生 成翻译后的文本。请注意,图中展示的是翻译过程的最后阶段,此时解码器根据原始输 入文本(“This is an example”)和部分翻译的句子(“Das ist ein”),生成最后一个单词 (“Beispiel”)以完成翻译
模型编码完成之后,需要使用数据集训练才能生成连贯的文本,同时还要计算输出损失值用于评估和优化训练结果。作者同样给出代码示例,使用一个 2 万字的短篇小说作为小数据集,和加载一个参数量 1.24 亿的 GPT-2 公开大数据集做对比。

不同大小的 GPT-2 大语言模型的参数量从 1.24 亿到 15.58 亿不等。核心架构相同,唯一的区别是嵌入层大小以及诸如注意力头、Transformer 块等个别组件的重复次数
可以看到小数据集对计算资源需求较小,但生成的句子不通顺,且有明显的语法错误。而用大数据集时虽然计算耗费资源,但输出的文本明显有效果提升,表达也更流畅自然。可以更直观地感受到,只有基于海量的数据训练,才能使模型拥有强大的学习和处理复杂语言的能力。
最后作者还介绍了用于分类的微调和用于执行指令的微调,展示如何通过微调,优化和改进模型的适应性,使得模型可以解决特定任务。
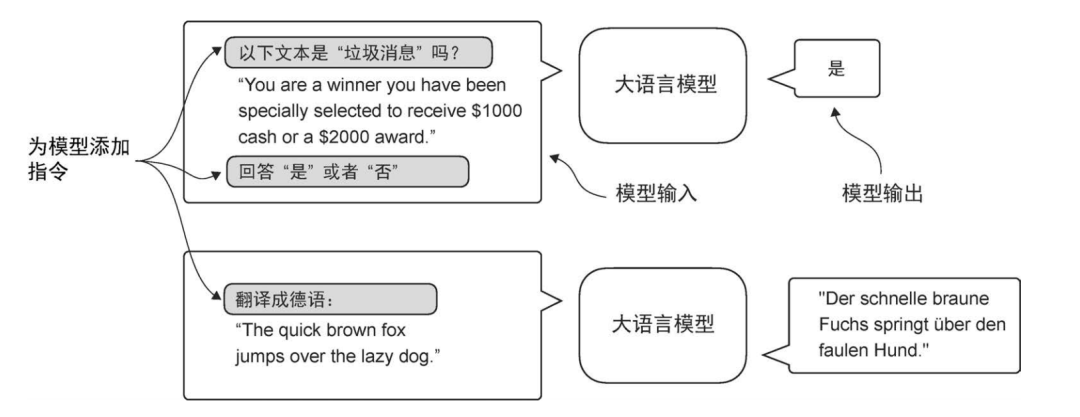
两种指令微调场景。由图的上半部分可知,模型的任务是判断给定文本是否为垃圾消息; 由图的下半部分可知,模型被指示将英语句子翻译成德语
整本书读下来,最大的感触是这本书对初学者很友好,就算是编程苦手也不必担心,可以把随书代码下载下来,暂时忽略代码细节,只是跟着书中指引调试起来,也能在实践中对大模型的架构和工作原理有整体的认识。
另外作者博客的一篇新文章介绍了推理模型的构建方法,还分享了 DeepSeek 发布后对大语言模型领域发展的看法,编辑把这篇文章作为中文版的彩蛋收录在附录中,真的是紧跟最新技术趋势,也是非常用心了。

覃立波,冯骁骋,刘乾 | 译
在本书中,你将学习如何规划和编写大模型的各个组成部分、为大模型训练准备适当的数据集、进行通用语料库的预训练,以及定制特定任务的微调。此外,本书还将探讨如何利用人工反馈确保大模型遵循指令,以及如何将预训练权重加载到大模型中。还有惊喜彩蛋 DeepSeek,作者深入解析构建与优化推理模型的方法和策略。
🔹从零开始:自己动手构建模型架构!
🔹 模型训练:教你如何准备数据、搭建训练管道,并优化模型效果!
🔹 让 LLM 更聪明:微调、加载预训练权重,让你的 LLM 适应不同任务!
🔹 人类反馈微调(RLHF):让 LLM 学会理解指令,避免胡言乱语!
🔹 轻量级开发:一台普通笔记本就能跑,告别「算力焦虑」!

现在大模型独角兽公司 Lightning AI 任资深研究工程师。博士毕业于密歇根州立大学,2018~2023 年威斯康星大学麦迪逊分校助理教授(终身教职),从事深度学习科研和教学。
除本书外,他还写作了畅销书《大模型技术30讲》(图灵已出版:)和《Python机器学习》。
译者冯骁骋,哈尔滨工业大学计算学部社会计算与交互机器人研究中心教授,博士生导师,人工智能学院副院长。研究兴趣包括自然语言处理、大模型等。在 ACL、AAAI、IJCAI、TKDE、TOIS 等 CCF A/B 类国际会议及期刊发表论文 50 余篇。
译者刘乾,新加坡某公司的研究科学家,主要研究方向是代码生成与自然语言推理。他在顶级人工智能会议(如ICLR、NeurIPS、ICML)上发表了数十篇论文,曾获得 2020 年百度奖学金提名奖、北京市 2023 年优秀博士论文提名奖、2024 年 KAUST Rising Stars in AI 等荣誉。
车万翔,哈尔滨工业大学计算学部长聘教授,博士生导师,人工智能研究院副院长,国家级青年人才,斯坦福大学访问学者。
黄科科,中南大学教授,博士生导师,自动化学院副院长,国家级青年人才。
——张俊林,新浪微博首席科学家 & AI 研发部负责人
作为一名大模型从业者,我自认为对书中大部分内容已经足够熟悉,但当我看到书稿的时候,仍忍不住认真读了一遍,因为这种文字、代码、图示、注释四合一的讲解方式实在太引人入胜了。不得不说,这是一本从零入门大模型的难得的好书!
——苏剑林,NLP知名博客“科学空间”博主
这真是一本鼓舞人心的书!它激励你将新技能付诸实践。
——Benjamin Muskalla,GitHub 高级工程师
这是目前对语言模型最通俗易懂且全面的解析!其独特而实用的教学方式,能够达到其他方式都无法企及的理解深度。
——Cameron Wolfe,Netflix 资深科学家
塞巴斯蒂安不仅能够将深邃的理论知识与工程实践完美结合,更拥有化繁为简的魔力。这正是你需要的指南!
——Chip Huyen,《设计机器学习系统》与 AI Engineering 作者
本书内容权威且前沿,强烈推荐!
——Vahid Mirjalili博士,FM Global高级数据科学家
扫描进群,大模型知识学习不迷路👇
